
Официальные результаты Claude Haiku 5.5 опубликованы. Если сравнить их с Haiku 4.5, GPT-6 Luna и Sonnet 5.5, обсуждать стоит не то, выиграла ли модель каждую позицию, а то, насколько далеко она отодвинула границу возможного для «малой модели».
Anthropic выпустила модель Claude Haiku 5.5. ID модели — claude-haiku-5-5, дата выхода — 7 октября 2026 г.
Позиционирование у Anthropic прямолинейное: это самая быстрая, самая дешёвая и самая способная из её малых моделей, рассчитанная на задачи с большим объёмом запросов, низкой задержкой и жёсткими требованиями к стоимости. В числе типичных сценариев компания называет классификацию, извлечение информации, суммаризацию, сжатие контекста, запросы к базам данных, работу в браузере, а также роль субагента для Sonnet 5.5 или Opus 5.5.
В этой статье используются только опубликованные Anthropic бенчмарки, цены и сведения о продукте; официальные результаты мы не выдаём за независимый эксперимент. Наша задача — вернуть эти цифры в контекст типов задач, цен и роли модели и разобраться, в чём Haiku 5.5 действительно сильна и какую работу ей по-прежнему не стоит доверять.
Коротко: Haiku 5.5 уже перешагнула рубеж «малая модель — только для простых задач»
Если свести официальные данные вместе, профиль Haiku 5.5 вырисовывается вполне чётко:
- по сравнению с Haiku 4.5 она значительно выросла во всех основных бенчмарках, опубликованных Anthropic;
- в позициях, где результаты приведены рядом, она опережает GPT-6 Luna;
- в интеллектуальной работе, управлении компьютером и части задач на рассуждение она уже близка к Sonnet 5.5;
- в сложном агентном программировании она всё ещё заметно уступает Sonnet 5.5;
- сильнее всего её позиции там, где сочетаются скорость, цена и уже достаточно высокая доля выполненных задач.
Поэтому Haiku 5.5 правильнее понимать как исполнительный уровень, возможности которого резко выросли, а не как модель, которая полностью заменяет Sonnet 5.5.
Официальное сравнение по бенчмаркам
Anthropic опубликовала на странице анонса Haiku 5.5 следующие данные. Значения GPT-6 Luna и Sonnet 5.5 взяты из той же сравнительной таблицы Anthropic.
| Бенчмарк | Haiku 5.5 | Haiku 4.5 | GPT-6 Luna | Sonnet 5.5 |
|---|---|---|---|---|
| GDPval-AA v2.1: интеллектуальная работа | 1620 | 735 | 1437 | 1840 |
| AA-Briefcase v1.1: интеллектуальная работа | 1578 | 614 | 1336 | 1824 |
| OSWorld 2.1: управление компьютером | 72,4% | 15,7% | 48,9% | 83,9% |
| Humanity's Last Exam: без инструментов | 45,9% | 10,2% | — | 56,9% |
| Humanity's Last Exam: с инструментами | 57,4% | 18,7% | — | 64,5% |
| Terminal-Bench 4.0: агентное программирование | 39,2% | 0,0% | 16,4% | 70,6% |
| FrontierCode 1.1: агентное программирование | 46,4% | — | 42,4% | 52,1% |
| Chartography: визуальные рассуждения | 46,4% | 6,4% | 29,1% | 61,6% |
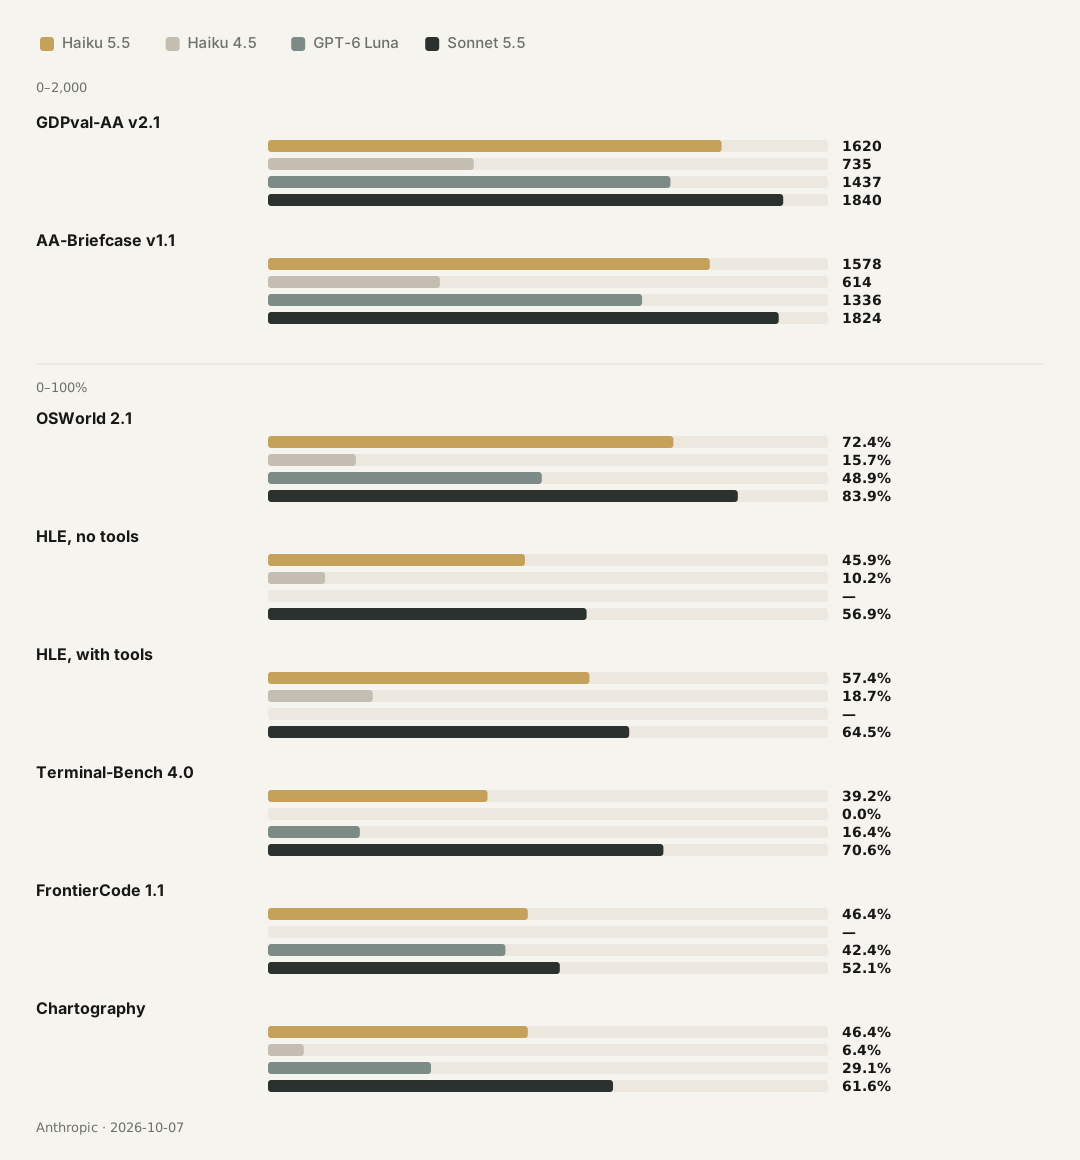
Эти цифры нельзя просто свести к формуле «Haiku 5.5 на втором месте». Разные бенчмарки измеряют совершенно разные способности: в интеллектуальной работе важно качество результата, OSWorld проверяет, может ли модель управлять настоящим компьютером, Terminal-Bench — способна ли она выполнить многошаговую профессиональную задачу в командной строке, а Humanity's Last Exam смещён в сторону сложных знаний и рассуждений.
То, что одна и та же модель так по-разному справляется с разными задачами, — само по себе часть результата.
Изменение первое: Haiku 5.5 оставила предыдущее поколение далеко позади
Если сравнивать только Haiku 4.5 и Haiku 5.5, масштаб обновления очевиден.
Результат в GDPval-AA v2.1 вырос с 735 до 1620 — примерно в 2,2 раза по сравнению с предыдущим поколением; в AA-Briefcase — с 614 до 1578, примерно в 2,6 раза. OSWorld поднялся с 15,7% до 72,4%, а Terminal-Bench — с 0,0% до 39,2%.
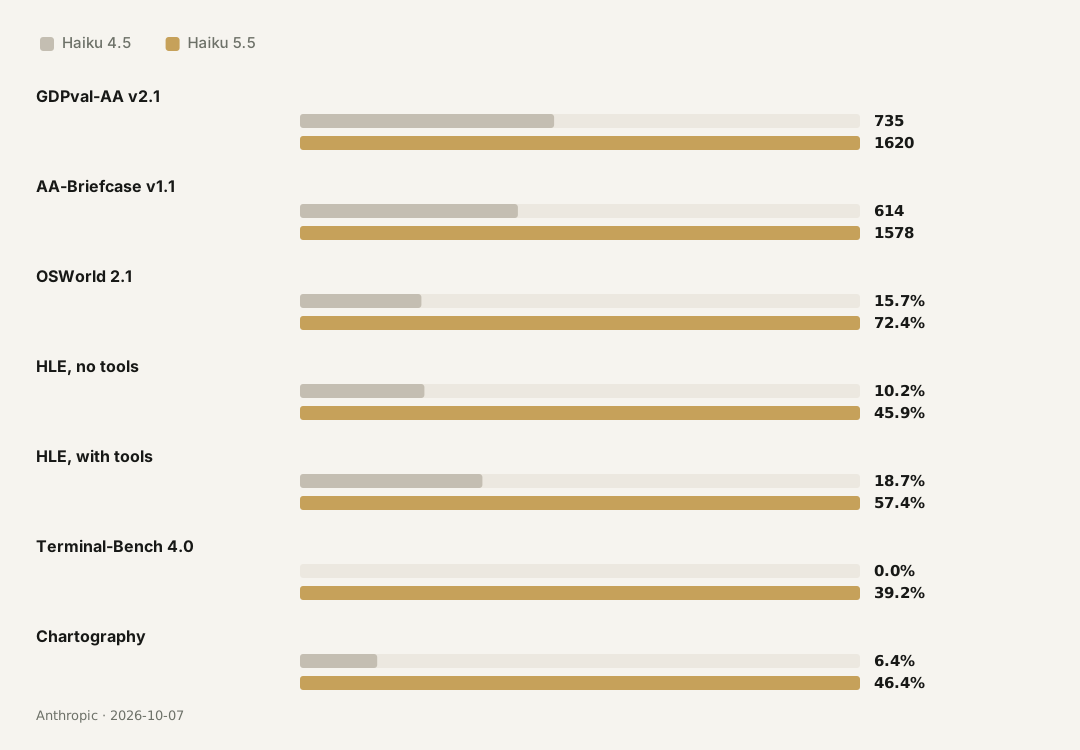
Это не изменение уровня «ответы стали красивее сформулированы». И OSWorld, и Terminal-Bench требуют длинных цепочек действий: модель должна понять задачу, вызвать инструменты, обработать обратную связь и продолжить работу после ошибки на полпути. Рост в таких тестах показывает, что Haiku 5.5 — уже не просто модель для короткой классификации и суммаризации.
Особенно показателен OSWorld. Между 15,7% у Haiku 4.5 и 72,4% у Haiku 5.5 — явный разрыв. Даже с поправкой на настройку бенчмарка, офлайн-подмножество и условия тестирования Anthropic этот результат говорит о том, что в управлении компьютером у Haiku 5.5 произошёл очень большой скачок между поколениями.
Однако рост в отдельном тесте нельзя напрямую превращать в вывод «все производственные задачи улучшились в той же мере». Бенчмарк измеряет конкретный набор задач, а реальный продукт зависит ещё и от длины контекста, описания инструментов, восстановления после ошибок, сетевой задержки и качества бизнес-данных.
Изменение второе: она вошла в зону конкуренции с GPT-6 Luna
В опубликованных Anthropic позициях Haiku 5.5 показывает более высокие результаты, чем GPT-6 Luna:
- GDPval-AA: 1620 против 1437;
- AA-Briefcase: 1578 против 1336;
- OSWorld: 72,4% против 48,9%;
- Terminal-Bench: 39,2% против 16,4%;
- Chartography: 46,4% против 29,1%.
Этих данных достаточно для осторожного вывода: Haiku 5.5 вошла в зону, где конкурируют массовые модели с хорошим соотношением цены и качества.
Но здесь необходимо сохранить две оговорки.
Во-первых, цифры взяты со страницы анонса Anthropic. Разные компании могут по-разному запускать бенчмарки, настраивать модели, подключать инструменты и считать статистику. Эти данные помогают понять, где производитель видит свой продукт, но их нельзя считать полностью независимым и симметричным сторонним рейтингом.
Во-вторых, «выше, чем у GPT-6 Luna» не означает «лучше GPT-6 Luna во всех задачах». Официальная таблица позволяет сравнивать только опубликованные позиции и не даёт оснований переносить результат на задачи, которые не тестировались.
Корректная формулировка такова:
В опубликованных Anthropic сравнительных тестах Haiku 5.5 показала более высокие результаты, чем GPT-6 Luna; при реальном выборе всё равно нужно учитывать тип задачи, цену, скорость и способ вызова модели.
Изменение третье: она близка к Sonnet, но уровни моделей никуда не делись
Разрыв между Haiku 5.5 и Sonnet 5.5 тоже информативен.
В GDPval-AA v2.1 у Haiku 5.5 — 1620, у Sonnet 5.5 — 1840; в AA-Briefcase — 1578 и 1824. В OSWorld Haiku 5.5 набирает 72,4%, Sonnet 5.5 — 83,9%. В Humanity's Last Exam без инструментов результаты составляют 45,9% и 56,9%, с инструментами — 57,4% и 64,5%.
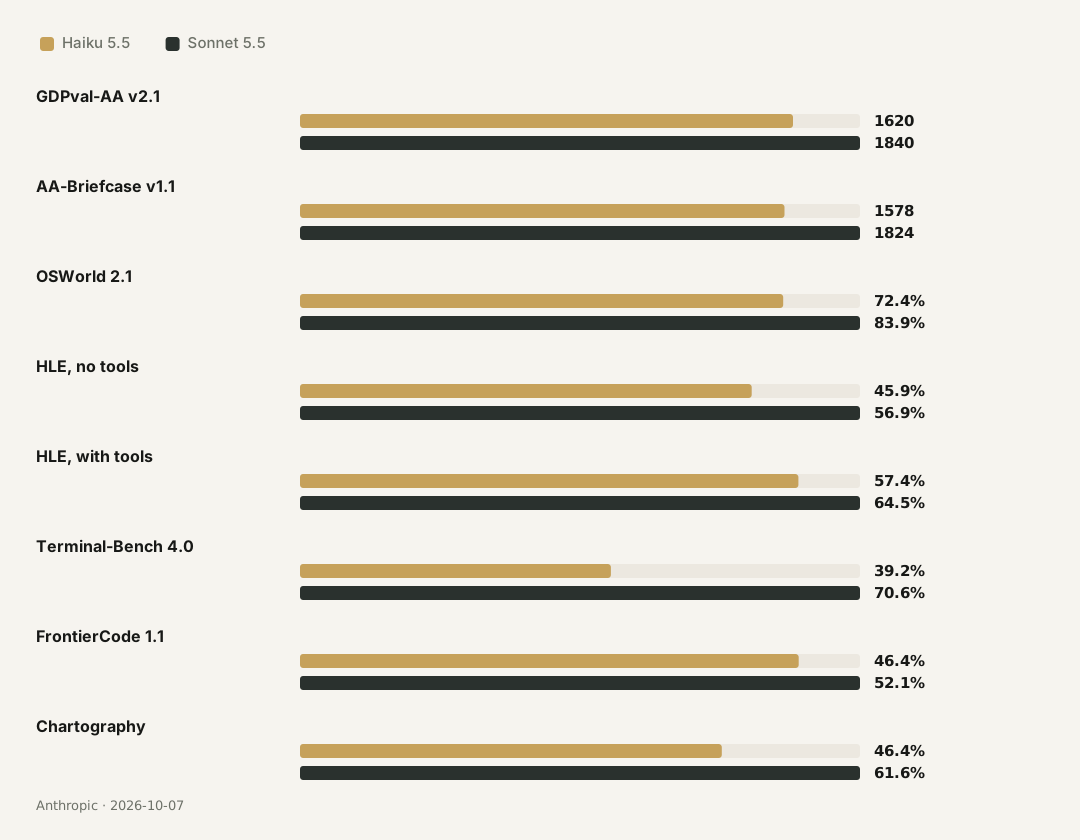
Эти разрывы показывают, что Haiku 5.5 уже справляется со значительной частью интеллектуальной работы и управления компьютером, но по мере роста сложности Sonnet 5.5 сохраняет устойчивое преимущество.
Больше всего внимания заслуживает разрыв в Terminal-Bench: 39,2% у Haiku 5.5 против 70,6% у Sonnet 5.5. Этот бенчмарк требует от модели выполнять сложные многошаговые профессиональные задачи в командной строке, что ближе всего к длительному агентному программированию. Здесь Haiku 5.5 намного опережает Haiku 4.5, но до Sonnet 5.5 ей ещё далеко.
Это задаёт чёткую границу при выборе модели:
- для локальной, повторяющейся и проверяемой работы Haiku 5.5 очень привлекательна;
- для задач, требующих долгосрочного планирования, правок в нескольких файлах и многократного восстановления после ошибок, по-прежнему лучше подходит Sonnet 5.5;
- близкие результаты в некоторых бенчмарках — не повод считать эти две модели разными ценовыми версиями одной и той же модели.
После снижения цен смотреть нужно на стоимость одной задачи
Цена — второй главный акцент этого релиза.
Для запросов объёмом до 100 тыс. токенов Haiku 5.5 стоит $0,10 за 1 млн входных токенов и $0,50 за 1 млн выходных. Свыше 100 тыс. токенов цены составляют $0,50 и $2,50 соответственно. По словам Anthropic, средняя стоимость работы Haiku 5.5 примерно на 75% ниже, чем у Haiku 4.5.
| Размер запроса | Цена ввода | Цена вывода | Чтение из кэша |
|---|---|---|---|
| До 100 тыс. токенов | $0,10 / 1 млн токенов | $0,50 / 1 млн токенов | $0,01 / 1 млн токенов |
| Свыше 100 тыс. токенов | $0,50 / 1 млн токенов | $2,50 / 1 млн токенов | $0,05 / 1 млн токенов |
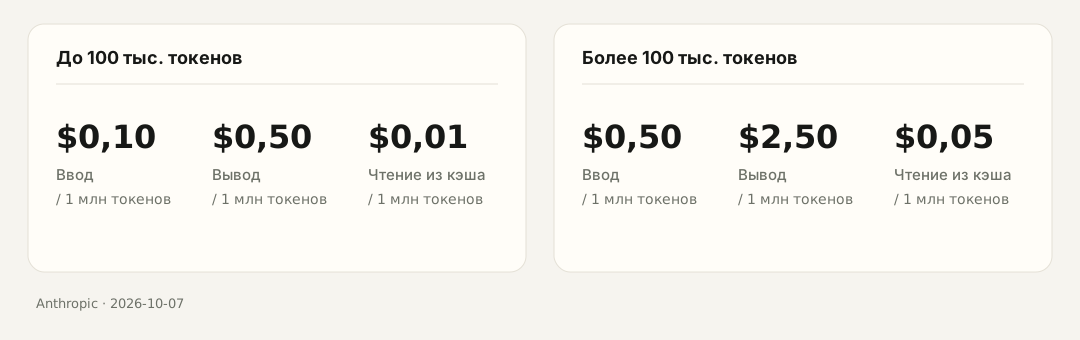
Формально цена ввода в пределах 100 тыс. токенов снизилась с $1 у Haiku 4.5 до $0,10, а цена вывода — с $5 до $0,50: номинальная цена за единицу упала на 90%. Но Anthropic также поясняет, что Haiku 5.5 использует более новый токенизатор и та же задача может расходовать чуть больше токенов. Поэтому средняя стоимость работы снижается примерно на 75%, а не на все 90%.
Для реального продукта нужно учесть ещё три вещи:
- Как часто Haiku 5.5 выполняет задачу с первого вызова?
- Сколько повторов требуется после сбоя?
- Нужно ли привлекать Sonnet или Opus, чтобы проверить и исправить результат?
Более содержательная метрика:
Стоимость одной успешной задачи
= общие затраты на выполнение работы ÷ число успешно выполненных задач
Допустим, один вызов Haiku 5.5 стоит десятую часть вызова Sonnet, но в каком-то типе задач требует двух повторов или 20% запросов в итоге приходится передавать Sonnet. Тогда реальная экономия окажется меньше, чем разница в прайс-листе.
И наоборот: если задачу можно проверить автоматически, а повтор после сбоя обходится дёшево, у Haiku 5.5 может быть очень сильное экономическое преимущество.
За порогом 100 тыс. токенов ценовая граница влияет на архитектуру продукта
В прайс-листе Haiku 5.5 отметка 100 тыс. токенов — важный рубеж.
На коротких и средних запросах низкая цена Haiku 5.5 проявляется сразу. Но репозитории кода, длинные диалоги, корпоративные базы знаний и большие массивы документов часто приближаются к 100 тыс. токенов или превышают этот порог. В таком случае отправлять всё одним запросом — не обязательно лучшее решение.
Более разумная архитектура обычно предполагает пять шагов:
- сначала с помощью Haiku 5.5 классифицировать документы и отобрать релевантные;
- сжать исходный материал в структурированную сводку;
- передавать более крупной модели только фрагменты, относящиеся к текущему вопросу;
- кэшировать повторяющийся контекст;
- хранить многоходовый диалог как состояние, доступное для поиска, а не пересылать его целиком при каждом запросе.
Именно здесь Haiku 5.5 теснее всего связана с агентной архитектурой. Это не только дешёвая модель для ответов, но и базовый уровень для сжатия контекста, обработки результатов поиска и выполнения подзадач.
Параметр effort делает статичный рейтинг недостаточным
Haiku 5.5 — первая модель семейства Haiku с настраиваемым уровнем effort. Для одной и той же модели система может менять объём рассуждений в зависимости от важности задачи и выбирать баланс между качеством, задержкой и стоимостью.
Это меняет то, как нужно читать бенчмарки. Один фиксированный результат показывает поведение модели в одной конфигурации, а полная кривая «стоимость — качество» показывает, как она ведёт себя при разных бюджетах.
Простым задачам может подойти более низкий effort:
- классификация;
- преобразование формата;
- извлечение фиксированных полей;
- переписывание короткого текста.
Задачам средней сложности можно дать более высокий effort:
- суммаризация длинного документа;
- сведение информации из разных абзацев;
- многошаговые действия в браузере;
- задачи, где сначала нужно принять решение, а затем вызвать инструмент.
Даже при повышенном effort Haiku 5.5 не обязательно заменит Sonnet в сложных задачах. Разрыв в Terminal-Bench напоминает: больший бюджет рассуждений может улучшить результат, но сам по себе не устраняет отставание в долгосрочном планировании, восстановлении после ошибок и работе со сложными цепочками инструментов.
Как перевести эти цифры в практическую маршрутизацию моделей
Сопоставив официальные результаты и позиционирование продукта, можно составить первую, достаточно осторожную таблицу маршрутизации:
| Тип задачи | Выбор по умолчанию | Почему |
|---|---|---|
| Классификация, маршрутизация, разметка | Haiku 5.5 | Большой объём вызовов, чёткая структура вывода, результат легко проверить |
| Извлечение полей, упорядочивание данных | Haiku 5.5 | Границы задачи заданы явно, работа хорошо распараллеливается |
| Суммаризация и сжатие контекста | Haiku 5.5 | Заметное преимущество в цене и скорости |
| Одношаговые или короткие сценарии в браузере | Haiku 5.5 | Результат в OSWorld показывает явный рост в управлении компьютером |
| Обычное объяснение кода и мелкие исправления | Haiku 5.5 или Sonnet 5.5 | Зависит от наличия автотестов и цены ошибки |
| Правки во многих файлах | Sonnet 5.5 | В Terminal-Bench всё ещё заметный разрыв |
| Длительное агентное программирование | Sonnet 5.5 или Opus 5.5 | Нужны устойчивое планирование и восстановление после ошибок |
| Финальная проверка и решения с высоким риском | Sonnet 5.5 или Opus 5.5 | Нужны большая стабильность и более сильные рассуждения |
Эта таблица — не постоянное определение того, где заканчиваются возможности Haiku 5.5. Это лишь первая версия рекомендаций, полученная из сопоставления официальных бенчмарков, цены и роли продукта.
При реальном развёртывании всё равно нужно проверить работу на собственных задачах:
- Соответствует ли вывод бизнес-требованиям?
- Можно ли обнаружить сбой автоматически?
- Оправдан ли повтор после сбоя с точки зрения затрат?
- Действительно ли более низкая задержка улучшает продукт?
- Не съедает ли низкую цену более высокая стоимость ручной проверки?
Как читать официальные бенчмарки
С бенчмарками новой модели легко совершить две ошибки.
Первая — сводить все позиции в один общий рейтинг. Интеллектуальная работа, управление компьютером, открытые рассуждения и агентное программирование — разные способности, и один итоговый балл не может их заменить.
Вторая — воспринимать официальные результаты как готовый вывод о работе в продакшене. У официального бенчмарка есть заданная конфигурация тестирования, а на реальный продукт влияют ещё промпт, инструменты, контекст, сеть, данные и механизм восстановления после ошибок.
Более надёжное прочтение состоит из трёх шагов.
Сначала оцените скачок возможностей
Стабильно ли Haiku 5.5 улучшилась по сравнению с Haiku 4.5? Судя по официальной таблице, да — особенно в OSWorld, интеллектуальной работе и тестах агентного программирования.
Затем посмотрите на границы задач
Догнала ли она более крупную модель? Это зависит от задачи. В части интеллектуальной работы и в управлении компьютером она уже близка к Sonnet, но в сложном агентном программировании разрыв всё ещё заметен.
И наконец — стоимость единицы работы
Стоит ли её использовать, определяется совокупностью качества, цены, задержки и восстановления после сбоев. Один только балл в бенчмарке не ответит на вопрос, стоит ли продукту переходить на другую модель.
Итог: сила Haiku 5.5 в том, что её можно использовать массово
Если спрашивать только о том, превосходит ли Haiku 5.5 модель Sonnet 5.5, ответ прост: нет. Официальные данные показывают, что Sonnet 5.5 по-прежнему впереди в интеллектуальной работе, управлении компьютером, общих рассуждениях и агентном программировании.
Если спрашивать только о том, сильнее ли Haiku 5.5, чем Haiku 4.5, ответ столь же однозначен: да, и прирост очень большой.
По-настоящему обсуждать стоит третий вопрос: достаточно ли она сильна, чтобы взять на себя большой объём локальной работы в производственных системах?
Судя по официальным результатам и цене, ответ, скорее всего, тоже положительный.
Ценность Haiku 5.5 в том, что целый класс задач, которым раньше требовалась модель среднего уровня, но которые не оправдывали её цену, теперь можно перенести на более быстрый и дешёвый исполнительный уровень. Классификация, извлечение данных, суммаризация, сжатие контекста, короткие сценарии в браузере и подзадачи агентов вполне могут стать её основным полем.
Это не очередной отчёт о «чемпионе рейтинга моделей», а отчёт о разделении труда между моделями:
- Haiku 4.5 доказала, что малая модель может дёшево выполнять простую работу;
- Haiku 5.5 начинает доказывать, что малая модель способна взять на себя и часть работы, требующей инструментов и нескольких шагов;
- Sonnet 5.5 по-прежнему отвечает за более сложное планирование, программирование и интеллектуальную работу;
- Opus 5.5 продолжает решать длительные и трудные задачи, где ошибка обходится дорого.
Фокус оценки моделей тоже смещается: с вопроса «у кого самый высокий балл» на вопрос «кого выгоднее всего вызывать для какой задачи».


