Một lần thất bại có thể chứng minh mô hình đã mắc lỗi, nhưng tự nó không chứng minh được rằng mô hình giờ đây mắc lỗi thường xuyên hơn trước.
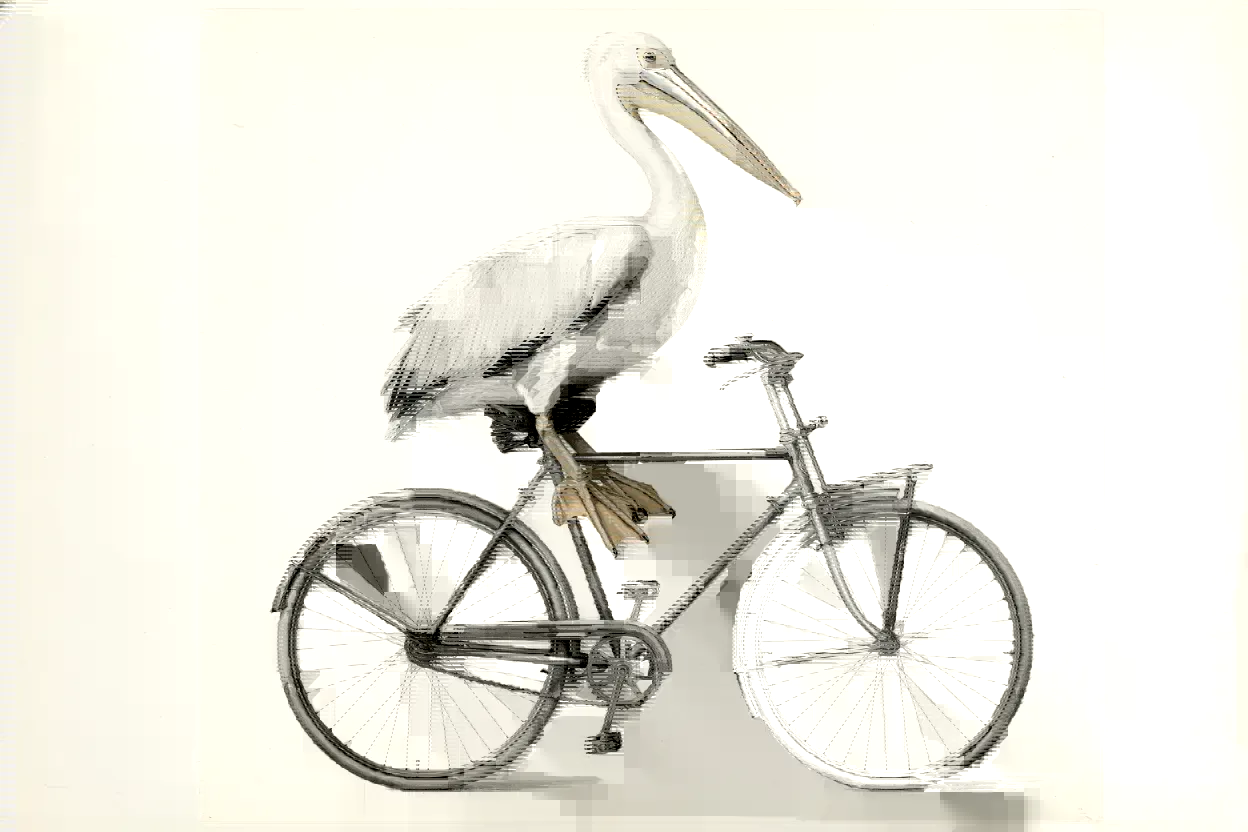
“Mô hình này lại bị giảm trí rồi sao?” Một con bồ nông có một chân lơ lửng ngoài bàn đạp, một chiếc xe đạp có khung bị vặn xoắn như bện thừng, đặt cạnh một ảnh chụp màn hình tuần trước còn vẽ khá đẹp – chừng ấy là đủ để người ta nảy ra câu hỏi này.
Không nên gạt mối nghi ngờ này đi chỉ bằng một câu “mô hình vốn có tính ngẫu nhiên”. Người dùng đã trả tiền, một việc trước đây dịch vụ làm được giờ lại làm không tốt – điều đó đương nhiên đáng để truy hỏi. Nhưng ngược lại, hai ảnh chụp màn hình cũng không đủ để cho thấy mô hình đã bị tráo, ngân sách suy luận đã bị cắt, hay một dịch vụ cụ thể nào đó chắc chắn đã bị “pha loãng”.
Cách đây một thời gian, tôi đã chạy bài kiểm tra bồ nông hàng chục lần. Điều làm đề này hữu ích là rất nhiều lỗi của nó được vẽ ra ngay trước mắt. Mã chạy được không có nghĩa là cấu trúc chiếc xe đạp đúng. Có đủ cả con chim lẫn chiếc xe cũng không có nghĩa là chân nó thật sự đặt trên bàn đạp. So với một câu trả lời trôi chảy nhưng có thể vẫn ẩn chứa lỗ hổng logic, những quan hệ không gian này dễ phát hiện bằng mắt thường hơn. Nhưng càng chạy nhiều, tôi càng nhận ra một điều khác: chúng ta thường đánh giá cả một dịch vụ chỉ dựa trên một sản phẩm duy nhất.
Bài viết này không nhằm bào chữa cho bất kỳ mô hình nào, cũng không dạy ai cách nhận diện “mô hình giả” qua vài đặc điểm bề ngoài. Câu hỏi tôi quan tâm hẹp hơn: khi nghi ngờ một mô hình đã tệ đi, làm sao biến cảm giác đó thành bằng chứng mà người khác có thể kiểm tra lại?
Lưu ý: các dịch vụ A và B dưới đây, cùng mọi con số thử nghiệm đi kèm, đều là ví dụ minh họa. Chúng không ứng với bất kỳ dịch vụ thực nào, và cũng không phải kết quả đo hay xếp hạng của Folkbench.
1. Trước hết, hãy tách câu hỏi: “kém đi” mà bạn nói là chuyện nào?
“Giảm trí” là một cách nói tiện lợi, nhưng nó gộp nhiều câu hỏi khác nhau làm một. Tầng trực tiếp nhất là: lần này, câu trả lời đúng là sai. Con bồ nông mọc thêm một cái chân, chân trượt khỏi bàn đạp, hoặc bánh xe tách rời khỏi khung. Mỗi lỗi như vậy là một thất bại cụ thể, kiểm tra được. Một mẫu là đủ để chứng minh “loại lỗi này đã xảy ra”, thậm chí đủ để bác bỏ lời hứa “nó sẽ không bao giờ mắc loại lỗi này”. Tầng thứ hai là: trong cùng điều kiện, hoặc điều kiện đủ gần, dịch vụ này thất bại thường xuyên hơn.
Đến đây, vấn đề không còn là lỗi có tồn tại hay không, mà là nó xuất hiện thường xuyên đến mức nào. Phần đáng đo nhất trong cái gọi là “trải nghiệm tệ đi” chính là sự chuyển từ “phần lớn thời gian làm được” sang “phần lớn thời gian làm không tốt”. Tầng thứ ba là: thay đổi đó do chính mô hình, hoặc cấu hình phía máy chủ, đã thay đổi. Đây đã là một nhận định về nguyên nhân. Cùng một kết quả xấu có thể đến từ nhiều cách giải thích khác nhau: tham số yêu cầu khác nhau, ngữ cảnh khác nhau, đầu ra bị cắt cụt, hoặc mô hình nền và cấu hình suy luận thật sự đã thay đổi. Chỉ nhìn vào kết quả thường chưa thể xác định duy nhất một trong những cách giải thích đó.
Vì vậy, “lần này sai”, “dịch vụ này kém tin cậy hơn” và “dịch vụ này lặng lẽ tráo mô hình” đòi hỏi bằng chứng ở những mức độ mạnh khác nhau. Thừa nhận sự khác biệt này không phải là nâng ngưỡng cho lời phàn nàn của người dùng. Ngược lại hoàn toàn: gọi tên câu hỏi cho rõ sẽ ngăn nhà cung cấp giải thích mọi sự cố bằng “tính ngẫu nhiên”, và cũng ngăn người đánh giá giải thích mọi khác biệt bằng “họ đã tráo mô hình”.
2. Bạn đang nhìn một sản phẩm, hay một phân phối đầu ra?
Với thiết lập sinh có lấy mẫu ngẫu nhiên, cùng một đầu vào có thể cho ra những đầu ra khác nhau. Ngay cả khi dùng một số biện pháp nhằm tăng khả năng tái lập, cũng không nên hiểu “nhất quán hết mức có thể” thành “giống hệt mọi lần”. Một ghi chú kỹ thuật cũ của OpenAI đã viết rõ: với cùng seed, cùng tham số và cùng dấu vân tay backend, đầu ra vẫn không được bảo đảm giống hệt nhau. Đó là một giới hạn của khả năng tái lập; nó không có nghĩa là mọi mô hình hiện nay đều hỗ trợ cùng những tham số ấy.1
Với bài kiểm tra bồ nông, điều chúng ta thực sự muốn biết thường không phải “thỉnh thoảng nó có vẽ được một bức đẹp không?”, mà là “trong điều kiện tôi đã chỉ định, nếu giao lại nhiệm vụ này thêm một lần, khả năng nhận được kết quả đạt là bao nhiêu?” Một ví dụ đơn giản hóa sẽ cho thấy vấn đề của một ảnh chụp màn hình đơn lẻ. Giả sử tỷ lệ đạt thực sự cho mỗi lần thử của một dịch vụ là 80%, mỗi lần sinh độc lập với nhau, và trạng thái của dịch vụ không đổi trong suốt quá trình kiểm tra. Khi đó, xác suất có ít nhất một lần thất bại trong 20 lần thử liên tiếp là: 1 − 0.8²⁰ ≈ 98.85% Nghĩa là một dịch vụ phần lớn thời gian làm tốt gần như chắc chắn sẽ để lại một lần thất bại đủ để chụp màn hình, ở đâu đó trong 20 lần thử ấy.
Đảo ngược lại. Giả sử tỷ lệ đạt thực sự cho mỗi lần thử của một dịch vụ khác chỉ là 40%. Với cùng các giả định về tính độc lập và ổn định, xác suất có ít nhất một kết quả đạt trong 20 lần thử là: 1 − 0.6²⁰ ≈ 99.996% Nó cũng gần như chắc chắn sẽ cho ra một sản phẩm đủ để mang đi khoe. Hai phép tính này không nói rằng mọi lượt gọi thực tế đều độc lập, cũng không nói tỷ lệ đạt thực tế đúng bằng những con số này. Chúng chỉ chỉ ra một vấn đề chọn lọc: chỉ đưa ra lần tốt nhất thì rất dễ đánh giá quá cao độ tin cậy; chỉ đưa ra lần tệ nhất thì cũng rất dễ phóng đại mức độ suy giảm.
Vì thế, cùng một dịch vụ hoàn toàn có thể xuất hiện đồng thời trong một bài đăng coi một bức ảnh là bằng chứng nó vẫn là “bản đầy đủ”, và trong một bài khác coi một bức ảnh là bằng chứng nó đã bị “giảm trí”. Cả hai ảnh chụp màn hình đều có thể là thật; suy luận thì chưa chắc. Còn một khác biệt dễ bị bỏ qua: thành công ngay ở lần sinh đầu tiên, và sinh mười lần rồi chọn ra lần thành công, không phải cùng một năng lực. Cách sau bao gồm thêm lượt gọi, thời gian chờ và chi phí chọn lọc. Nếu so sánh hai quy trình làm việc, hãy cho cả hai cùng một ngân sách số lần thử. Đừng đem lần thử đầu tiên của A so với bộ sưu tập chọn lọc của B.
3. Chạy đủ 20 lần thì khác biệt tự động có ý nghĩa thống kê sao?
Không. Hai mươi lần có thể là một ngân sách thử nghiệm hợp lý, nhưng không phải tấm giấy thông hành thống kê. Vẫn lấy ví dụ cụ thể ấy: kênh A chạy 20 lần, đạt 16 lần; kênh B chạy 20 lần, đạt 8 lần. Cả hai dùng cùng một đề cố định, cùng tiêu chí chấm, và giữ lại toàn bộ mẫu.
| Kênh | Số lần đạt / tổng số | Tỷ lệ đạt của mẫu | Khoảng Wilson 95% cho tỷ lệ đạt |
|---|---|---|---|
| A | 16 / 20 | 80% | 58,4%–91,9% |
| B | 8 / 20 | 40% | 21,9%–61,3% |
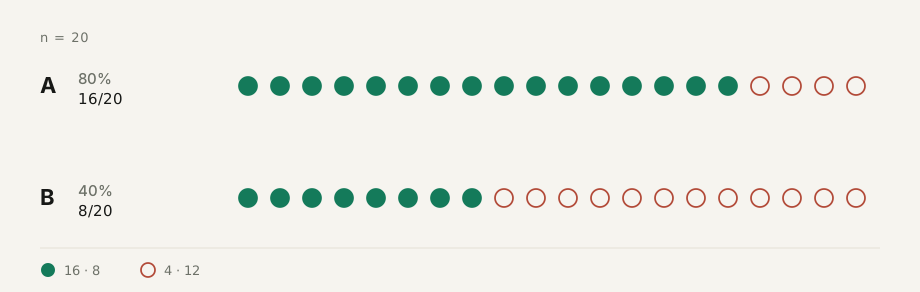
Các khoảng này là khoảng Wilson hai phía 95% cho một tỷ lệ nhị thức. Chúng thể hiện độ bất định trong ước lượng tỷ lệ đạt, không phải khoảng điểm cho chất lượng hình vẽ.2 Chênh lệch trong mẫu là 40 điểm phần trăm. Nhưng với chỉ 20 lần thử mỗi bên, ước lượng vẫn còn thô: không thể coi 80% và 40% là năng lực thực đã được đo chính xác và sẽ không bao giờ thay đổi.
Nếu giả định thêm rằng các lượt gọi độc lập, xác suất đạt của mỗi kênh ổn định trong khung thời gian, và phép so sánh này đã được chọn từ trước, thì kiểm định chính xác Fisher hai phía trên số đếm đạt / không đạt cho p ≈ 0.0225. Với mức ý nghĩa 5% đã chọn trước, ví dụ này ủng hộ nhận định “tỷ lệ đạt của hai bên khác nhau trong điều kiện này”.3 Con số đó không có nghĩa là “97,75% khả năng B đã bị pha loãng”, cũng không phải “97,75% khả năng A mãi mãi tốt hơn”. Giá trị p là xác suất thu được dữ liệu cực đoan như thế này, hoặc cực đoan hơn, dưới giả thuyết không có khác biệt và các điều kiện của kiểm định. Nó không phải xác suất của một nguyên nhân ẩn giấu nào đó.3
Đừng thay phép kiểm định chênh lệch bằng việc liếc xem hai khoảng có chồng lên nhau hay không. Mỗi khoảng ước lượng một tỷ lệ; còn phép kiểm định nhắm vào chênh lệch giữa hai tỷ lệ. Quan trọng hơn việc nhớ một phương pháp kiểm định là nhớ ba giới hạn. Hãy xem độ lớn của chênh lệch cùng với cỡ mẫu. 16 so với 8 không nên dẫn tới một kết luận mạnh ngang 16 so với 15. Cần bao nhiêu mẫu tùy thuộc vào việc bạn muốn phát hiện chênh lệch nhỏ đến mức nào, và chấp nhận rủi ro kết luận sai lớn đến đâu. Không có con số “chạy ít nhất bấy nhiêu lần” nào phù hợp với mọi nhiệm vụ.
Không phát hiện khác biệt có ý nghĩa thống kê không chứng minh hai bên như nhau. Có thể dữ liệu chỉ đơn giản là quá ít, hoặc quá bất ổn, để đi đến kết luận. Muốn chứng minh một khác biệt nhỏ đến mức có thể bỏ qua, hãy định nghĩa trước “nhỏ đến mức nào thì bỏ qua được”, thay vì coi một kết quả không có ý nghĩa thống kê là bằng chứng về sự tương đương. Khác biệt về mặt thống kê, tự nó, chưa phải lý do để đổi dịch vụ. Người dùng còn phải cân nhắc cái giá của một lần thất bại, giá mỗi lượt gọi, độ trễ và chi phí làm lại. Một khác biệt có thể là thật mà vẫn quá nhỏ để thay đổi lựa chọn. Vai trò của thống kê ở đây không phải là tạo ra một giá trị p trông chuyên nghiệp, mà là ngăn chúng ta nói quá những gì bằng chứng có thể gánh.
4. Baseline là một hợp đồng thử nghiệm, không phải câu “prompt giống nhau”
Nhiều phép so sánh thất bại trước cả khi cỡ mẫu trở thành vấn đề: các mẫu vốn không so sánh được ngay từ đầu. Cả hai bên đều được yêu cầu “vẽ một con bồ nông đạp xe đạp”. Một bên là yêu cầu API trong một phiên mới tinh. Bên kia là cửa sổ chat đã trò chuyện hàng chục lượt, lại còn bật công cụ. Một bên được phép viết đầu ra dài, bên kia chạm giới hạn độ dài giữa chừng. Lặp lại như thế một trăm lần cũng không cho phép quy kết quả cho khác biệt về năng lực mô hình.
Nghiên cứu về chuẩn đánh giá OLMES chỉ ra rằng những lựa chọn trong đánh giá như định dạng prompt, ví dụ trong ngữ cảnh và cách diễn đạt nhiệm vụ đều làm thay đổi hiệu năng đo được; một phép so sánh có thể tái lập phải ghi lại rõ các thiết lập đó. Các nhiệm vụ trong nghiên cứu ấy không phải SVG bồ nông, nhưng lời nhắc về cấu hình thử nghiệm thì đáng tham khảo.4 Tôi đề xuất hiểu baseline như một hợp đồng về “vòng này thực sự đang đo cái gì”.
Đối tượng so sánh phải cụ thể: dịch vụ, nhóm hoặc tuyến, và phiên bản mô hình mà bạn thực sự có được. Nếu chỉ có một bí danh mô hình có thể thay đổi theo thời gian, hãy ghi bí danh đó. Nếu không biết snapshot bên dưới, hãy ghi “không rõ”. Đừng coi chuỗi tên mô hình mà API trả về là bằng chứng độc lập về danh tính thực của mô hình bên dưới. Hãy lưu đầu vào càng đầy đủ càng tốt – không chỉ câu prompt cuối cùng mà cả system prompt, lịch sử hội thoại, tệp đính kèm và thiết lập công cụ mà bạn kiểm soát và quan sát được. Điều kiện nhìn thấy được giống nhau không chứng minh rằng điều kiện không nhìn thấy cũng giống nhau.
Với thiết lập sinh, hãy ghi lại mức độ suy luận, giới hạn đầu ra và các tham số lấy mẫu mà API thực sự hỗ trợ. Trường nào API không hỗ trợ thì ghi “không hỗ trợ”, trường nào không xác nhận được là có hiệu lực hay không thì ghi “không rõ” – đừng lặng lẽ coi chúng là giống nhau. Cũng không nên mặc định rằng một thiết lập cùng tên “high” trên hai mô hình khác nhau có cùng ngân sách tính toán.
Môi trường đánh giá bao gồm cách kết xuất và cách chấm điểm. Kiểm tra cùng một tệp SVG trong cùng khung nhìn và trình kết xuất. Với đề yêu cầu hoạt ảnh, hãy dùng khung quan sát đã thống nhất; đừng xem trọn chuyển động ở một bên rồi chỉ chọn một khung hình ở bên kia. Nếu đề không yêu cầu hoạt ảnh, cũng đừng trừ điểm vì đầu ra là ảnh tĩnh. Cuối cùng, hãy viết quy tắc thử lại trước khi bắt đầu. Lần thất bại đầu tiên có được thử lại không, thử lại mấy lần, có được phản hồi không – tất cả đều là điều kiện kiểm tra, không phải thứ để ứng biến khi đã thấy kết quả.
Cố định những thứ này không phải để tạo ra một “mô hình phòng thí nghiệm” tách rời thực tế. Bạn hoàn toàn có thể so sánh trải nghiệm mặc định của hai sản phẩm chat. Khi đó, kết luận nên là “hai sản phẩm này khác nhau về những gì chúng mang lại ở thiết lập mặc định”, chứ không phải “tôi đã tách riêng được trọng số mô hình nền nào tốt hơn”. Điều kiện không kiểm soát được có thể để là “không rõ”; nhưng không được ghi điều chưa rõ thành đã kiểm soát.
5. Cách sắp xếp phép thử thường quan trọng hơn việc chỉ chạy thêm nhiều lần
Đừng để kênh gắn chặt với thời điểm
Chạy hết A vào buổi sáng, rồi chạy hết B vào đêm khuya, sẽ trộn lẫn “khác biệt giữa các kênh” với “khác biệt theo thời gian”. Kể cả khi thật sự thấy chênh lệch, bạn cũng khó nói chênh lệch đó phụ thuộc bao nhiêu vào khung giờ ấy. Với một phép so sánh song song gọn nhẹ, tôi sẽ cho A và B xen kẽ nhận yêu cầu trong một khung thời gian đã định trước, và sắp xếp thứ tự ngẫu nhiên. Hãy giữ mức đồng thời càng giống nhau càng tốt; đừng để một bên sinh từng cái một trong khi bên kia phải gánh một loạt yêu cầu dồn dập.
Có thể tiến thêm một bước: chia khung thời gian thành vài đợt nhỏ, đợt nào cũng có cả A và B. Ngoài kết quả tổng thể, bạn còn xem được chênh lệch có chỉ tập trung ở một đợt nào đó hay không. Thứ tự ngẫu nhiên giúp giảm nhiễu do thời gian, nhưng không tự động loại bỏ mối tương quan đến từ một backend dùng chung, một sự cố ngắn hay điều gì tương tự.
Câu hỏi theo chiều dọc – “có tệ hơn tuần trước không?” – thì khác. Thời gian chính là biến số đang được nghiên cứu, nên không thể cố định cả hai bên vào cùng một thời điểm. Hãy giữ nguyên đề cốt lõi, cấu hình và tiêu chí chấm nhiều nhất có thể, và chạy lại một dịch vụ tham chiếu trong mỗi khung quan sát, thay vì mãi đem kết quả hôm nay so với bức đẹp nhất của tuần trước. Khi đọc kết quả theo chiều dọc, hãy giữ cả tỷ lệ đạt tuyệt đối lẫn chênh lệch tương đối. Nếu dịch vụ được kiểm tra và dịch vụ tham chiếu cùng đi xuống, chênh lệch tương đối có thể không đổi; nhưng điều đó không có nghĩa trải nghiệm người dùng không tệ đi. Dịch vụ tham chiếu cũng không phải chân lý luôn đúng và luôn ổn định.
Đừng vừa nhìn kết quả vừa quyết định khi nào dừng
“Chạy năm lần trước, A thắng thì đăng bài; A chưa thắng thì chạy tiếp cho đến khi khác biệt có ý nghĩa thống kê.” Cách làm này trông như tăng thêm mẫu, nhưng thực chất đã thay đổi quy tắc thống kê. Liên tục xem dữ liệu với một phép kiểm định cỡ mẫu cố định rồi dừng dựa trên những gì thấy được sẽ phá vỡ khả năng kiểm soát dương tính giả mà phép kiểm định ấy được thiết kế để bảo đảm. Một phép thử cần theo dõi dữ liệu liên tục nên dùng phương pháp chuyên cho phân tích tuần tự.5 Phần lớn mọi người không cần bắt đầu từ thống kê tuần tự. Cách dễ làm nhất là ghi lại trước khi bắt đầu vòng: sẽ chạy bao nhiêu lần, dùng chỉ số chính nào, so sánh chính những gì – rồi giữ lại toàn bộ kết quả.
Thử vài lượt gọi trước để xác nhận API và quy trình chấm hoạt động bình thường là hoàn toàn được. Đó là các lượt chạy thử. Sau khi đã chỉnh xong quy trình, hãy bắt đầu phép thử chính thức một cách riêng biệt; đừng trộn kết quả giai đoạn chỉnh đề với kết quả chính thức. Tương tự, thử liền vài chục đề rồi chỉ công bố đề có lợi nhất, hoặc thấy tổng điểm không chiếm ưu thế thì chuyển sang tuyên bố chiến thắng ở một hạng mục con, đều không còn là phép so sánh đã thống nhất từ trước.
Đừng coi một đề chạy một trăm lần là đã làm một trăm đề
Sinh lặp lại cho biết dịch vụ đáng tin cậy đến đâu trên đề này, nhưng không tự động mở rộng phạm vi của kết luận. Bồ nông có vẽ ổn định đến mấy cũng không trực tiếp chứng minh rằng việc gỡ lỗi code, phân tích văn bản dài và tuân theo chỉ dẫn phức tạp cũng đáng tin cậy như vậy. Khi suy luận về cả một loại nhiệm vụ, khác biệt giữa các đề và khác biệt giữa các lần sinh trên cùng một đề là hai loại bất định khác nhau. Các nghiên cứu về đánh giá phân biệt rõ lấy mẫu lặp lại, so sánh ở cấp độ đề và cách xử lý các mẫu tương quan theo cụm.6
Vì vậy, tôi sẽ dùng một câu hỏi thăm dò để quan sát độ lặp lại trước, rồi thêm một nhóm nhỏ các nhiệm vụ cố định gắn với mục đích sử dụng thực tế. Cả hai bên trả lời cùng một bộ đề. Hãy tính kết quả và chênh lệch trên từng đề trước khi tổng hợp, thay vì chỉ đưa ra một tổng điểm. Nếu phân tích thống kê chính thức trên nhiều đề, hãy giữ quan hệ ghép cặp theo cùng đề và cùng đợt. Không thể coi “10 đề, mỗi đề 10 lần” là “100 đề độc lập” rồi áp lại phép tính cho một đề ở phần trước.
Còn một cái bẫy nhỏ: seed cố định hữu ích khi truy tìm vấn đề tái lập, nhưng sao chép hai mươi lần một đầu ra gần như không đổi dưới cùng một seed không phải là hai mươi quan sát độc lập về phân phối đầu ra ngẫu nhiên. Khi đo độ ổn định, hãy thống nhất trước chiến lược lấy mẫu; API nào hỗ trợ seed có thể dùng nhiều seed được tạo sẵn từ trước, API nào không hỗ trợ thì ghi lại giới hạn đó. Bộ đề nên được cập nhật lâu dài ra sao là một câu hỏi riêng. Ít nhất trong vòng so sánh này, đừng vừa thay đề vừa nối điểm cũ và mới thành một “đường cong tiến bộ của mô hình”.
6. Hết thời gian chờ, bị cắt cụt và vẽ sai không thể gộp chung một rổ
Một kiểu méo mó thống kê thường gặp là chỉ chấm những sản phẩm trả về thành công, còn xóa thẳng các yêu cầu hết thời gian chờ và báo lỗi. Điểm số thu được trả lời câu hỏi “khi đã có đầu ra hoàn chỉnh trong tay, khả năng nó đạt là bao nhiêu?”, chứ không trả lời câu hỏi người dùng quan tâm hơn: “gửi đi một yêu cầu, tôi có nhận được kết quả đạt không?” Giả sử đã lên lịch trước 20 yêu cầu, trong đó 4 yêu cầu hết thời gian chờ; 16 yêu cầu còn lại trả về sản phẩm hoàn chỉnh, và 8 trong số đó đạt. Tỷ lệ đạt trong các đầu ra hoàn chỉnh là 50%, nhưng tỷ lệ giao kết quả đạt ngay lần đầu, tính trên cả 20 yêu cầu, chỉ là 40%. Chỉ công bố con số đầu sẽ bỏ sót bốn lần người dùng không nhận được gì.
Tôi sẽ giữ đồng thời ba loại kết quả: thất bại kỹ thuật không giao được kết quả, trả về hoàn chỉnh nhưng không đạt yêu cầu, và trả về hoàn chỉnh và đạt yêu cầu. Hết thời gian chờ, lỗi API, luồng bị ngắt giữa chừng, chạm giới hạn độ dài – mỗi loại nên được ghi lại nguyên nhân riêng. Ghi riêng không có nghĩa là miễn trách cho sự cố của dịch vụ. Với người đang chọn dịch vụ, hết thời gian chờ hay vẽ sai đều tốn thời gian; chỉ là khi truy tìm nguyên nhân, không nên mô tả tất cả chúng thành “trí tuệ của mô hình đã suy giảm”. Sự cố mạng cục bộ hoặc lỗi của script kiểm tra cũng cần được liệt kê riêng; có loại bỏ chúng hay không phải dựa trên quy tắc đã định trước, không thể thấy bên nào thua rồi mới xóa mẫu.
Tôi nghiêng về việc lấy tỷ lệ yêu cầu đầu tiên nhận được kết quả đạt làm chỉ số chính, còn tỷ lệ đạt về nội dung trong các đầu ra hoàn chỉnh, tỷ lệ thất bại kỹ thuật, độ trễ và chi phí thì đặt bên cạnh để hỗ trợ giải thích. Tỷ lệ đạt về nội dung trên các đầu ra hoàn chỉnh cũng không phải một “điểm năng lực thuần túy” không thiên lệch: nếu các yêu cầu phức tạp dễ hết thời gian chờ hơn, những sản phẩm còn lại có thể vốn đã dễ hơn. Tỷ lệ đó giúp khoanh vùng vấn đề, nhưng không thay thế được kết quả tính trên toàn bộ yêu cầu.
Còn câu hỏi “sửa một lần thì có thành công không?” có thể là một phép thử riêng, cho cả hai bên cơ hội sửa như nhau. Đừng kiên nhẫn chỉnh lỗi cho một bên qua năm vòng, còn bên kia vừa sai lần đầu đã bị “tuyên án”.
7. Một phép so sánh tối thiểu mà người bình thường cũng làm được
Không cần dựng cả một nền tảng đánh giá chỉ để kiểm tra một con bồ nông. Dưới đây là một phương án khởi đầu. Nó phù hợp để rà soát một khác biệt rõ rệt trên một câu hỏi thăm dò cố định, không phải một thiết kế cỡ mẫu bảo đảm phát hiện được mức suy giảm nhỏ.
| Hạng mục | Thỏa thuận cho vòng này |
|---|---|
| Câu hỏi | Trên đề cố định này, tỷ lệ giao kết quả đạt ngay lần đầu của dịch vụ A và B có khác nhau không? |
| Đầu vào và thiết lập | Lưu toàn bộ yêu cầu nhìn thấy được. Thống nhất các tham số kiểm soát được. Ghi lại những khác biệt không thể xác nhận. |
| Mẫu | Lên lịch trước 20 yêu cầu chính thức cho mỗi bên. Không trộn lượt chạy thử vào mẫu chính thức. |
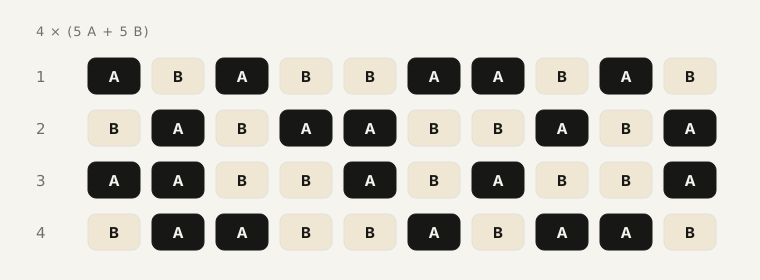
| Thời gian và thứ tự | Chia khung thời gian định trước thành 4 đợt, mỗi đợt A và B mỗi bên 5 lần. Xen kẽ ngẫu nhiên trong đợt, giữ cùng quy tắc đồng thời. |
| Thử lại | Phép thử câu trả lời đầu tiên chính thức không thêm lần thử lại. Muốn đánh giá khả năng sửa lỗi thì mở một thử nghiệm riêng. |
| Chấm điểm | Chốt tiêu chí đạt trước lần chạy đầu tiên. Sau khi kết xuất, ẩn tên kênh, xáo trộn thứ tự rồi mới chấm. |
| Đầu ra | Lưu mọi kết quả gốc, trạng thái của từng lượt gọi, căn cứ chấm điểm, cùng thống kê theo từng đợt và tổng thể. |
Tiêu chí đạt cho đề bồ nông có thể bắt đầu đơn giản. Tệp có kết xuất bình thường trong môi trường đã thống nhất không? Con vật và chiếc xe có đủ hoàn chỉnh để nhận ra không? Có cấu trúc then chốt nào sai rõ ràng không? Những điểm tiếp xúc mà đề yêu cầu, như chân với bàn đạp, có thật sự đúng không? Độ đẹp có thể ghi riêng, nhưng không thể dùng màu sắc tinh tế để bù cho lỗi cấu trúc.
Nếu ai đó phân vân trước một mẫu nằm ở ranh giới, hãy đánh dấu là có tranh cãi và xử lý theo quy tắc rà soát lại đã định trước; đừng đợi thấy tên kênh rồi mới quyết định có cho qua hay không. Phép thử quy mô nhỏ có thể chấm thủ công theo kiểu mù. Khi quy mô lớn hơn, chấm điểm tự động và hiệu chỉnh giám khảo là câu hỏi tiếp theo – không nhất thiết phải giải quyết hết ngay ở vòng đầu. Việc ghi chép sẽ nhẹ nhàng hơn nhiều nếu bạn tách cấu hình “mỗi vòng một bản” khỏi nhật ký “mỗi lượt gọi một dòng”. Cấu hình vòng lưu mẫu yêu cầu gốc, tham số, phiên bản đề, phiên bản quy tắc chấm, khung thời gian, cùng thỏa thuận về hết thời gian chờ và thử lại. Mỗi lượt gọi nên ghi ít nhất các trường sau:
run_id,block_id,service,service_group,requested_model,returned_model,started_at,request_hash,status,finish_reason,latency_ms,qualified,failure_reason,artifact_pathGhi thời gian theo định dạng có múi giờ. Liên kết phản hồi gốc, SVG đã trích xuất và ảnh đã kết xuất qua artifact_path. Số lượng token, dấu vân tay backend và mọi thông tin khác mà API cung cấp đều có thể lưu kèm; nếu không được cung cấp thì ghi là trống hoặc không rõ. request_hash dùng để kiểm tra yêu cầu có giữ nguyên hay không, nhưng không thay thế được bản thân yêu cầu gốc. Khi lưu và chia sẻ nhật ký, hãy xóa khóa API và che đi ngữ cảnh riêng tư hoặc nội dung nhạy cảm khác. Một phép kiểm chứng công khai cần điều kiện thử nghiệm, chứ không cần bạn giao kèm cả thông tin xác thực tài khoản.
Khi tổng hợp, hãy xem trước chênh lệch tổng thể và kết quả từng đợt. Khoảng nhị thức và kiểm định chính xác Fisher ở trên chỉ áp dụng khi các giả định của chúng, gồm tính độc lập và ổn định, đại thể được thỏa mãn. Nếu kết quả rõ ràng chịu ảnh hưởng của đợt, hoặc về sau mở rộng thành kiểm tra lặp lại trên nhiều đề, hãy dùng phương pháp phân tích phù hợp với thiết kế ghép cặp, thay vì áp dụng máy móc công thức cho một đề. Nếu chênh lệch ban đầu đáng để truy tiếp, hãy kiểm tra lại trong một khung thời gian định trước mới, và thêm các nhiệm vụ liên quan đến mục đích sử dụng thực tế của bạn. Vòng đầu tiên là manh mối về một bất thường; một vòng mới, độc lập mới giúp bạn phán đoán bất thường đó có còn tồn tại hay không.
8. Phát hiện khác biệt rồi, nên viết kết luận thế nào?
Vẫn dùng các con số minh họa ở trên, một kết luận chừng mực nhưng hữu ích có thể viết như sau:
Với đề cố định của vòng này, cùng thiết lập nhìn thấy được và khung thời gian định trước, A và B mỗi bên được kiểm tra 20 lần; số lần giao kết quả đạt ngay lần đầu lần lượt là 16 và 8, tỷ lệ đạt của mẫu chênh nhau 40 điểm phần trăm. Với các giả định bao gồm lấy mẫu độc lập, kiểm định chính xác Fisher hai phía cho giá trị p khoảng 0,0225, ủng hộ việc tồn tại khác biệt trong điều kiện của vòng này. Kết quả này vẫn cần được kiểm chứng ở các khung thời gian khác và trên các nhiệm vụ liên quan; tự nó không thể xác định nguyên nhân cụ thể của thay đổi ở mô hình nền hay cấu hình phía máy chủ.
Nó không giật gân bằng “bằng chứng là bản đầy đủ”, nhưng đã trao cho người khác những điều kiện then chốt cần thiết để kiểm tra lại. Nếu các phép thử sau đó, qua nhiều khung thời gian và nhiều nhiệm vụ liên quan, vẫn cho kết quả cùng chiều, chúng ta mới có lý do vững hơn để nói: dịch vụ này kém tin cậy hơn dịch vụ tham chiếu cho những mục đích này, hoặc thực sự đã thụt lùi so với baseline lịch sử của chính nó. Nhưng nhảy từ “chất lượng giao kết quả đi xuống” sang “đã lặng lẽ tráo sang một mô hình nhỏ hơn” vẫn là đi thêm một bước. Muốn xác nhận một cơ chế cụ thể, cần bằng chứng độc lập có khả năng phân biệt các cách giải thích, chẳng hạn bản ghi định tuyến hoặc cấu hình có thể kiểm chứng; không thể chỉ dựa vào phong cách đầu ra để đoán tên mô hình.
Điều đó cũng không có nghĩa người dùng phải chờ đến khi tìm ra nguyên nhân mới có quyền đổi dịch vụ. Chọn dịch vụ cần biết nó có đáp ứng yêu cầu của bạn hay không; cáo buộc một nguyên nhân cụ thể cần bằng chứng về chính nguyên nhân đó. Hai việc này có thể tách riêng.
9. Thứ thực sự đáng tiết kiệm là chi phí để chứng minh vấn đề cho rõ ràng
Phần tốn sức nhất của kiểm tra thủ công thường không phải là bấm nút chạy, mà là công việc lặp đi lặp lại sau đó: tệp lưu ở đâu, tham số có thay đổi không, bức ảnh này là lần sinh thứ mấy, có thử lại không, ảnh chụp màn hình còn khớp được với phản hồi gốc không. Thiếu những ghi chép đó, niềm tin chắc nịch rằng “nó thật sự kém đi rồi”, một tuần sau, có thể chỉ còn lại vài ảnh chụp màn hình không ai kiểm tra lại được.
Nếu bạn chỉ muốn tìm hiểu sơ bộ các dịch vụ hoạt động thế nào, không cần ai cũng phải tự sắp xếp lại từ con số không. Bạn có thể bắt đầu từ Folkbench, xem bảng xếp hạng công khai và lối vào các báo cáo, để biết mô hình, nhóm dịch vụ và chỉ số bạn quan tâm đã có kết quả hay chưa. Các trang công khai của Folkbench nhấn mạnh việc so sánh các dịch vụ khác nhau trên cùng một mô hình, và bảng xếp hạng cũng lưu ý rằng số liệu của nhóm ở một hàng không đại diện cho mọi nhóm của trạm đó.7
Tuy vậy, ý nghĩa của một bảng xếp hạng có sẵn là giảm chi phí thu thập và sắp xếp, chứ không phải lý do để thôi kiểm tra điều kiện. Kể cả Folkbench, bảng xếp hạng nào cũng đáng được hỏi tiếp: đo khi nào, đo cái gì, mẫu bao nhiêu, thất bại có được giữ lại không, kết luận áp dụng trong phạm vi nào? Thông tin chưa công khai thì vẫn là điều chưa biết. Quay lại câu hỏi ban đầu: bao nhiêu phần trong chuyện “mô hình bị giảm trí” là thật, bao nhiêu là ảo giác của một lần lấy mẫu đơn lẻ?
Khi chưa có định nghĩa chung, mẫu đầy đủ và điều kiện so sánh được, đưa ra một tỷ lệ tổng thể chỉ tạo thêm một thứ huyền học mới. Điều chúng ta có thể làm tốt hơn là biến từng mối nghi ngờ cụ thể, từng bước một, thành một nhận định có thể kiểm tra. Thấy thất bại, hãy giữ lại kết quả gốc; nghi ngờ thụt lùi, hãy bắt đầu so sánh đối chứng; phát hiện khác biệt, rồi mới truy tìm nguyên nhân. Đừng cố hoàn thành tất cả các bước ấy trong một tấm ảnh chụp màn hình. Một ảnh chụp màn hình có thể đặt ra một câu hỏi hay. Muốn trả lời nó, vẫn cần một thử nghiệm tử tế.
Chú thích và tài liệu tham khảo
- OpenAI, How to make your completions outputs consistent with the new seed parameter, một ví dụ Cookbook cũ, trang đã được đánh dấu lưu trữ. Ghi chú này mô tả seed cố định là nỗ lực hết mức hướng tới tính tất định chứ không phải một sự bảo đảm. Bài viết này chỉ trích dẫn giới hạn về khả năng tái lập đó, không coi tên các mô hình cũ và phạm vi hỗ trợ tham số trong trang ấy là mô tả sản phẩm hiện tại. Nguồn↩
- NIST/SEMATECH, e-Handbook of Statistical Methods, mục 7.2.4.1, Confidence intervals, phương pháp khoảng Wilson cho tỷ lệ. Bài viết dùng khoảng Wilson hai phía 95% cho 16/20 và 8/20; kết quả do tác giả tính theo công thức, làm tròn đến một chữ số thập phân của phần trăm. Mức tin cậy ở đây mô tả tính chất bao phủ dài hạn của phương pháp dựng khoảng; phương pháp Wilson là một phương pháp xấp xỉ. Nguồn↩
- Tài liệu chính thức của SciPy,
scipy.stats.fisher_exact. Bài viết dùng bảng tiếp liên[[16, 4], [8, 12]]vớialternative="two-sided"và thu đượcp = 0.0224774273717544. Đây là kết quả tính trên dữ liệu ví dụ, không phải kết quả đo thực tế từ một bài báo hay báo cáo của nền tảng nào. Ví dụ này so sánh các kết quả nhị thức độc lập; dữ liệu ghép cặp, phân cụm theo nhiều đề, phụ thuộc theo thời gian hay so sánh bội cần được phân tích theo thiết kế tương ứng. Nguồn↩ - Yuling Gu và cộng sự, OLMES: A Standard for Language Model Evaluations, Findings of NAACL 2025. Bài báo thảo luận các chi tiết đánh giá như định dạng prompt, cách chọn ví dụ trong ngữ cảnh, cách diễn đạt nhiệm vụ, và những gì một phép so sánh có thể tái lập đòi hỏi. Nguồn↩
- Ramesh Johari, Leo Pekelis và David J. Walsh, Always Valid Inference: Bringing Sequential Analysis to A/B Testing, arXiv:1512.04922, bản sửa đổi năm 2019. Bài báo thảo luận vấn đề liên tục xem kết quả rồi dựa vào đó quyết định cỡ mẫu, cùng các phương pháp suy luận tuần tự tương ứng. Nguồn↩
- Evan Miller, Adding Error Bars to Evals: A Statistical Approach to Language Model Evaluations, 2024. Về độ bất định ở cấp độ đề, lấy mẫu lặp lại, so sánh ghép cặp và mẫu theo cụm, xem các mục 2, 3 và 4; về lập kế hoạch cỡ mẫu, xem mục 5. Nguồn↩
- Trang chủ và trang bảng xếp hạng công khai của Folkbench, truy cập ngày 5 tháng 10 năm 2026. Bài viết chỉ dựa vào các trang công khai này để mô tả lối vào, phạm vi so sánh và lưu ý ở cấp độ nhóm; không xác nhận độc lập bất kỳ số liệu xếp hạng cụ thể nào, và cũng không có nghĩa là Folkbench đã triển khai toàn bộ quy trình thử nghiệm đề xuất trong bài. Trang chủ; Bảng xếp hạng↩