
Khi nhờ mô hình xử lý một xung đột nơi công sở, câu người ta hay hỏi là: “Sếp nói thế này, tôi nên trả lời sao?”
Trông thì giống một bài tập trau chuốt câu chữ, nhưng thực ra nó gần với một bài toán có nhiều mục tiêu kéo ngược nhau hơn. Lịch sự thôi là chưa đủ. Tin nhắn phải làm được nhiều việc cùng lúc: không ngầm chấp nhận một lời trách móc thiếu chính xác, không biến cuộc trao đổi thành đối đầu, không gạt bỏ phần trách nhiệm mà người viết thực sự phải nhận, và cũng không ôm hết trách nhiệm của người khác về mình. Đồng thời, nó phải để lại những sự việc cần thiết, mốc thời gian và bước tiếp theo, để công việc tiếp tục tiến lên.
Bài kiểm tra “Sếp nói kháy: ai xử lý được?” của Folkbench đo chính lớp năng lực đó. Nó không yêu cầu mô hình đưa ra lời khuyên chung chung kiểu “bị thao túng tâm lý nơi công sở thì phải làm sao”. Thay vào đó, nó đưa ra 12 tình huống có bối cảnh cụ thể, quan hệ quyền lực và ràng buộc về bàn giao, rồi yêu cầu một câu trả lời mà người bình thường thực sự dám gửi, mà không làm sự việc bị xé ra to.
Đây không phải bài kiểm tra cách “đáp trả” sếp
12 tình huống bao quát nhiều kiểu áp lực quen thuộc: bị bóng gió trong nhóm chat rằng dạo này “trông có vẻ thảnh thơi”; bị hỏi trước mặt mọi người rằng có còn muốn làm nữa không; bị bảo “lẽ ra phải nghĩ đến sớm hơn” sau khi dự án có kết quả không tốt; yêu cầu thay đổi mà không ai báo, rồi lại bị đòi phải tự theo sát; bản kế hoạch bị bỏ trống vì phía cung cấp đầu vào chưa gửi tài liệu; đóng góp bị sếp gạt đi nhẹ tênh; bị nói là “chưa nắm lắm” trước mặt khách hàng; nhận xét hiệu suất chỉ ghi “chưa đủ chủ động”; bị nhờ cuối tuần “xem qua giúp một chút”; lưu lại bằng văn bản sau khi thứ tự ưu tiên bị đổi vào phút chót; và một cuộc thương lượng lịch làm việc ẩn sau câu “người trẻ nên chịu khổ một chút”.
Cách thực hiện bài kiểm tra
Bốn mô hình nhận cùng bộ tình huống V1 hiện tại và cùng yêu cầu đầu ra. Trang chỉ giữ 48 kết quả có promptHash khớp: 12 câu hỏi, mỗi câu bốn câu trả lời.
Điểm quy tắc xét năm khía cạnh:
- Có gửi được ngay không?
- Có bảo vệ được sự việc của người viết và ranh giới trách nhiệm không?
- Có làm tình hình tệ hơn không?
- Có biết chừng mực không?
- Bước tiếp theo có rõ ràng không?
Trang cũng ghi lại các cảnh báo quy tắc và rủi ro nghiêm trọng. Điểm quy tắc chỉ dùng để so sánh trên 12 câu hỏi chung này. Nó không có nghĩa là một mô hình có kỹ năng công sở chung nào đó, và cũng không phải tư vấn luật lao động.
Kết quả: điểm trung bình sát nhau, nhưng chân dung năng lực thì khác
| Mô hình | Điểm quy tắc trung bình | Số câu dẫn đầu (tính cả đồng hạng) | Rủi ro nghiêm trọng | Cảnh báo quy tắc |
|---|---|---|---|---|
| GPT-5.6 Sol | 74,3 | 5/12 | 0 | 0 |
| Kimi K2.7 Code | 72,5 | 4/12 | 0 | 1 |
| Opus 4.8 | 72,2 | 2/12 | 0 | 5 |
| GLM 5.2 | 70,2 | 2/12 | 0 | 6 |
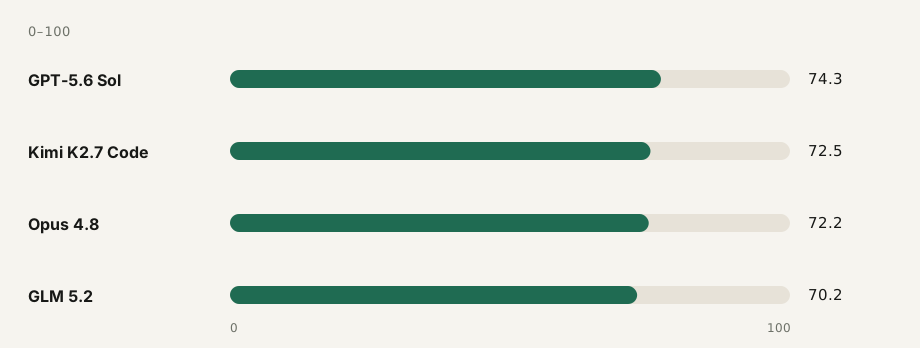
GPT-5.6 Sol chỉ hơn hạng nhì 1,8 điểm. Dù vậy, trên trang, nó vẫn đứng đầu trong bốn mô hình ở “gửi được ngay”, ranh giới và bước tiếp theo. Nó hợp với những tình huống cần nói rõ thứ tự ưu tiên, mốc thời gian và trách nhiệm.
Kimi K2.7 Code đạt 80,7 điểm ở khả năng nhận diện tình huống, cao nhất trong bốn mô hình. Điểm “bước tiếp theo” của nó là 58,3. Đôi khi nó nhìn ra vấn đề rất rõ mà vẫn không chốt được người phụ trách, thời gian hay bước xác nhận.
Opus 4.8 đạt 70,3 điểm ở khả năng hạ nhiệt, nhỉnh hơn các mô hình khác một chút, và nổi bật ở những câu về ranh giới như “cuối tuần xem qua giúp một chút” và “người trẻ nên chịu khổ một chút”. Trang cũng ghi nhận 4 câu có phần mở đầu theo khuôn mẫu soạn sẵn và 1 câu còn để nguyên phần giữ chỗ chưa thay. Hãy đọc hết câu trả lời trước khi sao chép.
GLM 5.2 giỏi liệt kê sự việc, phần còn thiếu và việc cần làm tiếp ở câu về tài liệu bị thiếu và câu nhận lỗi trong nhóm chat. Sáu câu có dấu hiệu khuôn mẫu như “bạn có thể trả lời thế này”, nên cảm giác rập khuôn nặng hơn.
Bốn tình huống, bốn bài toán công sở
“Dạo này trông em thảnh thơi nhỉ”: đừng nhận cái nhãn sai
Người dùng đang sửa bản kế hoạch phải gửi khách hàng vào thứ Sáu và chưa trả lời một tin nhắn không gấp trong nhóm. Sếp nói: “Dạo này trông em thảnh thơi nhỉ.”
Sol không cãi “em có thảnh thơi chút nào đâu”. Nó nói người viết đang tập trung sửa bản kế hoạch, cấu trúc và các số liệu cốt lõi đã kiểm xong, dự kiến gửi bản đầu tiên lúc 17:00, và nếu có việc gấp hơn thì có thể điều chỉnh thứ tự ưu tiên.
Câu trả lời trước tiên nêu lý do cụ thể của việc trả lời chậm, rồi dùng tiến độ và mốc bàn giao để cho thấy công việc đang chạy, sau đó chuyển cuộc trò chuyện từ “có phải đang lười không” về “giờ việc gì gấp hơn”. Nó không chấp nhận lời phán xét ngầm “thảnh thơi”, cũng không công khai vạch trần sự mỉa mai của sếp ngay trong nhóm chat.
“Chưa đủ chủ động”: biến cái nhãn mơ hồ thành tiêu chuẩn hành vi
Trong buổi trao đổi về hiệu suất, sếp chỉ nói: “Thái độ của em thì ổn, chỉ là chưa đủ chủ động.” Phiếu đánh giá cũng ghi y như vậy: “chưa đủ chủ động”. Kỳ đánh giá tiếp theo kéo dài 6 tuần.
Kimi không phản bác ngay, cũng không nói chung chung “em sẽ cố gắng cải thiện”. Nó hỏi “chủ động” ở đây cụ thể là gì: tự thử tìm giải pháp trước khi báo lên, hay tự cập nhật mà không cần ai hỏi; chưa tích cực khi phối hợp liên phòng ban, hay chưa chủ động nhận việc mới. Sau đó nó hỏi tiếp tiêu chuẩn đạt và tiêu chuẩn tốt cho kỳ tới, để việc đánh giá có thể gắn vào từng tuần hoặc từng mốc dự án.
Cách đó biến một cái nhãn tính cách khó cãi thành một tiêu chuẩn hành vi có thể nêu ví dụ, quan sát và rà soát lại. Phiên bản của Sol còn đi xa hơn: đề xuất cập nhật rủi ro hằng tuần, đưa ra phương án thay thế khi có vấn đề, và một buổi rà soát giữa kỳ vào tuần thứ 3. Nhìn ra vấn đề và đẩy vấn đề tiến lên là hai năng lực khác nhau.
“Sao bản kế hoạch vẫn trống thế này?”: ranh giới trách nhiệm được dựng bằng sự việc
Bản kế hoạch sự kiện còn thiếu ba thứ mà phía cung cấp đầu vào phải xác nhận: phạm vi sự kiện, dữ liệu chuyển đổi trong 30 ngày qua và mức trần ngân sách. Dàn ý, quy trình và các phần chung không phụ thuộc vào dữ liệu đã xong, danh sách tài liệu cần có đã được gửi hai lần. Trong nhóm chat, sếp nói: “Sao bản kế hoạch vẫn trống thế này? Em chưa đẩy đủ mạnh phải không?”
GLM đạt 81,4 điểm ở câu này, cao nhất trong bốn mô hình. Nó viết những gì đã làm xong, liệt kê ba phần còn thiếu, ghi lại các lần đã gửi và nhắc trước đó, rồi đưa ra kế hoạch: phản hồi trước 17:00 ngày mai, và bổ sung các phần còn thiếu trong vòng hai ngày làm việc sau khi nhận được tài liệu. Nếu chưa thể cung cấp tài liệu chính thức, chỉ cần một phạm vi hoặc một giá trị tạm tính là có thể làm tiếp dựa trên các giả định đã nêu.
Kiểu trả lời này không biến chuyện “chưa được gửi tài liệu” thành lời than phiền đầy cảm xúc, mà biến nó thành một phụ thuộc mà cả dự án có thể cùng xử lý. Ranh giới trách nhiệm không được dựng bằng câu “đây không phải lỗi của tôi”, mà bằng ghi nhận về những gì đã xong, các phụ thuộc và mốc thời gian.
“Người trẻ nên chịu khổ một chút”: đưa phán xét giá trị về lại bài toán lịch làm việc
Người dùng cùng lúc phụ trách ba việc: đợt ra mắt chức năng quyết toán hội viên vào thứ Sáu tuần này, báo cáo vận hành hạn vào thứ Ba tuần sau, và việc tinh chỉnh giao diện trang quản trị không phụ thuộc bên ngoài. Sếp nói: “Người trẻ chịu khổ một chút cũng là chuyện tốt.” Người dùng muốn có một lịch làm việc hợp lý nhưng không muốn nói quá lời.
Opus đạt 82,1 điểm ở câu này, điểm cao nhất cho một câu trong cả bộ. Nó không tranh luận về giá trị của việc “chịu khổ”. Nó liệt kê ba việc theo hạn chót: quyết toán hội viên ưu tiên một, báo cáo vận hành ưu tiên hai, việc tinh chỉnh giao diện lùi lại một tuần. Nếu việc tinh chỉnh cũng có hạn cứng thì sẽ sắp xếp lại thứ tự.
Một câu trả lời hiệu quả không phản bác câu nói ấy. Nó thay câu hỏi “em có chịu khổ được không” bằng “trong khoảng thời gian đang có, những phần bàn giao nào đáng được ưu tiên bảo đảm trước”.
Chân dung từng mô hình
GPT-5.6 Sol: câu trả lời vững vàng, hướng tới bàn giao. Nó thường đưa nội dung về sự việc, thời gian và bước tiếp theo. Việc lưu lại bằng văn bản, lúc đứng trước khách hàng và xác nhận lịch làm việc đều tương đối vững. Trang cũng lưu ý câu trả lời của Sol có thể khá dài. Trong tranh chấp về hiệu suất hay trách nhiệm, người dùng vẫn phải bổ sung tiêu chuẩn rõ hơn, người phụ trách và hạn chót.
Kimi K2.7 Code: đọc được tình huống, nhưng cần kiểm tra khâu chốt việc. Nó giỏi đọc mối quan hệ và áp lực đằng sau một câu nói, nhất là trong buổi trao đổi về hiệu suất hoặc khi bị hỏi dồn trong cuộc họp. Trước khi dùng, hãy kiểm tra xem người phụ trách, thời gian và bước xác nhận đã được viết ra đủ chưa.
Opus 4.8: biết hạ nhiệt, nhưng cần dọn lại trước khi sao chép. Nó giỏi chừa cho đối phương một bậc thang để xuống, và giỏi các bài toán ranh giới như từ chối làm cuối tuần hay xin lịch làm việc hợp lý. Câu chữ dài hơn, dấu vết khuôn mẫu cũng rõ hơn. Hãy xóa phần giải thích, phần trong ngoặc và các phần giữ chỗ, rồi kiểm tra xem tin nhắn có khớp với mối quan hệ thực tế không.
GLM 5.2: mạnh về danh sách việc, nhưng phải bỏ giọng giảng giải. Nó giỏi tách câu trả lời thành phần đã xong, phần còn thiếu, người phụ trách và bước tiếp theo, rất hợp với việc theo sát dự án và rà soát chậm tiến độ. Vấn đề là câu trả lời và phần chú thích hướng dẫn thường lẫn vào nhau. Hãy yêu cầu nó chỉ xuất ra phần văn bản có thể gửi.
Khung bốn bước ai cũng dùng lại được
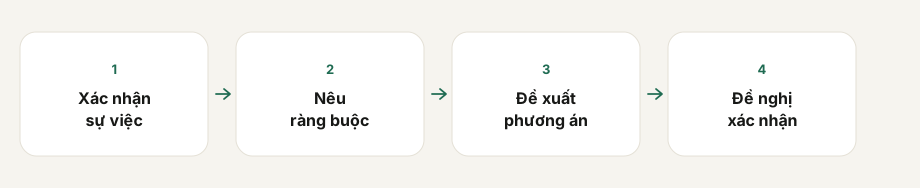
Dù dùng mô hình nào, bạn cũng có thể dựng một câu trả lời nơi công sở theo trình tự sau:
- Xác nhận sự việc. Viết rõ bạn đang làm gì, đã xong những gì và thay đổi xảy ra khi nào.
- Nhận phần mình kiểm soát được. Nếu lịch làm việc không chừa khoảng dự phòng, hoặc rủi ro được báo quá muộn, hãy thừa nhận đúng hành vi cụ thể đó. Đừng ôm toàn bộ trách nhiệm bằng một câu mơ hồ.
- Viết ranh giới thành một phương án sắp xếp. Nêu rõ phụ thuộc, thứ tự ưu tiên, phần bàn giao bị dời và mốc thời gian mới. Đừng dừng ở câu “đây không phải trách nhiệm của tôi”.
- Nêu bước tiếp theo và đề nghị xác nhận. Nói rõ ai làm gì, khi nào xong, và kế hoạch thay đổi thế nào nếu điều kiện thay đổi.
Có thể rút gọn thành một dòng:
Xác nhận sự việc → Nêu ràng buộc → Đề xuất phương án → Đề nghị xác nhận.
Độ an toàn khi sao chép–dán cũng nên là một tiêu chí đánh giá
Một mô hình có thể phán đoán đúng tình huống mà vẫn tạo ra thứ bạn không nên gửi. Rủi ro không chỉ là sai sự việc hay sai giọng điệu. Tin nhắn có thể vẫn còn dính “bạn có thể trả lời thế này”, “lý do như sau”, một cái tên chưa được thay, một ghi chú trong ngoặc, hoặc cả một đoạn phân tích vốn chỉ dành cho người dùng đọc.
Một bài đánh giá trên tác vụ thực tế phải tách bạch ít nhất hai điều: mô hình có đề xuất được cách giao tiếp hợp lý không, và nó có tách tin nhắn cuối cùng khỏi phần giải thích không. Điều thứ nhất là chất lượng lời khuyên. Điều thứ hai là độ an toàn khi sao chép–dán. Folkbench chấm riêng tiêu chí “có gửi được ngay không”, vì thứ người dùng cần không chỉ là một câu trả lời nghe sắc sảo, mà là một văn bản làm việc họ có thể kiểm soát, chỉnh sửa và gửi đi.
Giới hạn của bộ kết quả này
Trên 12 tình huống cụ thể của bộ V1 hiện tại, bốn mô hình xử lý sự việc, ranh giới, quan hệ và bước tiếp theo theo những cách có thể quan sát được. Sol trả về câu trả lời có thể bàn giao một cách ổn định hơn. Kimi giỏi đọc tình huống hơn. Opus giỏi hạ nhiệt và thương lượng ranh giới hơn. GLM giỏi đẩy công việc tiến lên theo dạng danh sách hơn.
Bộ kết quả này không cho thấy mô hình nào giỏi hơn ở mọi cuộc trò chuyện nơi công sở, cũng không cho thấy mô hình nào “hiểu lòng người” hơn. Cỡ mẫu, đề bài, phiên bản mô hình, yêu cầu đầu ra và quy tắc chấm điểm đều ảnh hưởng đến kết quả. Sol chỉ hơn Kimi 1,8 điểm, không đủ để kết luận là “áp đảo toàn diện”. Điểm quy tắc trên trang không phải ý kiến pháp lý về luật lao động. Một quyết định thực tế về hiệu suất, kỷ luật, lương thưởng hay tranh chấp lao động không thể chỉ dựa vào một tin nhắn do mô hình viết.
Cái tên “sếp nói kháy” dễ khiến người ta nghĩ đến bài học về cách đáp trả. Điều bài kiểm tra thực sự đo là một năng lực khó hơn: trong một mối quan hệ không cân bằng, không phó mặc bản thân cho một cái nhãn mơ hồ, không đẩy cuộc trao đổi thành xung đột công khai, mà vẫn để lại được ghi nhận, nhận được xác nhận và giữ cho công việc tiếp tục tiến lên.


