
Một mô hình có thể viết ra một bản hướng dẫn làm jianbing đầy đủ các bước, giọng điệu kiên nhẫn, nhưng điều đó không có nghĩa là người mới thật sự làm theo được.
Căn bếp gia đình thực tế có rất nhiều biến số. Chảo khác nhau về kích thước và chất liệu. Bột có thể quá đặc hoặc quá loãng. Lửa thay đổi giữa lúc tráng bánh, đập trứng và lật mặt. Miếng bánh giòn mỏng baocui không phải lúc nào cũng mua được. Buổi sáng có khi chỉ có 20 phút. Sau lần thất bại đầu tiên, người dùng không cần thêm một công thức đẹp đẽ khác. Họ cần ai đó phán đoán được “vì sao bánh vừa rồi bị rách”, và cho biết mẻ bánh trong chảo còn cứu được không.
Vì vậy, bài đánh giá làm jianbing lần này không kiểm tra xem mô hình có thuộc lòng một công thức hay không. Nó kiểm tra xem mô hình có biến được kiến thức thành một phương án mà căn bếp gia đình có thể thực hiện, điều chỉnh, và vẫn đi tiếp được khi có sự cố hay không.
Xem kết luận trước: ngoài điểm trung bình, khác biệt nằm ở thất bại và rủi ro
Vòng thử nghiệm này đặt ra 12 tình huống bếp gia đình; bốn mô hình để lại tổng cộng 48 kết quả khớp promptHash. Điểm theo quy tắc trên trang xem xét câu trả lời từ năm góc độ: các bước có làm theo được không, có thể hiện hiểu biết thường thức về bếp núc không, có xử lý được khi hỏng không, diễn đạt có rõ ràng không, và mô hình có tự nhận mình là một “đầu bếp lão luyện” quá tự tin hay không.
Điểm tổng hợp được công bố trên trang như sau:
| Mô hình | Tổng hợp | Số đề dẫn đầu trong 12 đề (kể cả đồng hạng) | Lưu ý quy tắc hoặc rủi ro nghiêm trọng được đánh dấu trên trang |
|---|---|---|---|
| Sonnet 5 | 80,4 | 6 | Không có |
| GLM 5.2 | 79,3 | 5 | 1 lưu ý quy tắc |
| Kimi K2.7 Code | 77,6 | 3 | 1 lưu ý quy tắc, 1 rủi ro nghiêm trọng |
| GPT-5.6 Terra | 75,6 | 0 | Không có |
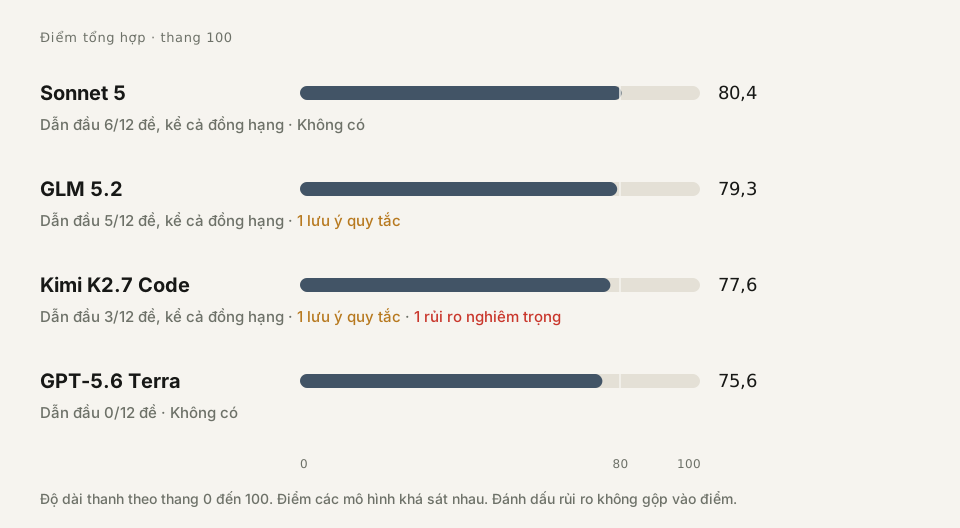
Sonnet 5 dẫn đầu với 80,4 điểm. Xét tổng thể, nó gần với một bản hướng dẫn có thể giao cho người mới hơn cả: các tình huống làm lần đầu, kiểm soát lửa theo loại chảo và bữa sáng 20 phút đều khá vững. GLM 5.2 chỉ kém 1,1 điểm, nhưng điểm các bước thao tác lại đạt 90, cao nhất trong vòng. Kimi K2.7 Code có điểm tổng hợp thấp hơn, nhưng làm tốt nhất ở những tình huống cần cứu vãn tại chỗ như “bánh rách rồi, cứu thế nào”. GPT-5.6 Terra đạt 84,2 điểm ở bài hướng dẫn hoàn chỉnh cho lần đầu, nhưng lộ rõ điểm yếu ở các đề về tỷ lệ bột, kiểm soát nhiệt chảo nướng điện và chẩn đoán thất bại.
Nhìn bề ngoài, đây là bảng điểm của bốn mô hình. Điều đáng chú ý hơn là nó phơi bày một sự thật hay bị bỏ qua: khả năng làm theo được không phải một năng lực đơn lẻ. Một mô hình có thể giỏi viết các bước cho rõ ràng nhưng kém trong việc chẩn đoán thất bại; cũng có thể rất giỏi cứu vãn nhưng vẫn để lại một vấn đề về ranh giới an toàn không thể làm ngơ.
1. Căn bếp gia đình không phải sân khấu trình diễn công thức
Nếu chỉ hỏi “làm jianbing thế nào”, mô hình rất dễ đưa ra một đáp án chuẩn trông có vẻ đầy đủ: chuẩn bị bột mì, pha bột, làm nóng chảo, tráng bánh, đập trứng, rắc hành lá, quét tương, đặt bánh giòn, rồi cuộn lại.
Đáp án đó có thể không sai rõ ràng ở mặt câu chữ, nhưng nó không trả lời những câu hỏi mà người mới thật sự gặp phải:
- Nhà chỉ có một chiếc chảo chống dính 26 cm, không có cây gạt bột để tráng bánh – một cái muôi và một cái xẻng có đủ không?
- Bột rốt cuộc nên loãng đến mức nào? Vì sao cùng một tỷ lệ nước và bột, có người tráng ra bánh rất dày, có người vừa xúc lên đã rách?
- Nếu không có bánh giòn, vỏ hoành thánh, quẩy, snack khoai tây và bánh bột mỏng thông thường sẽ cho ra kết quả khác nhau thế nào?
- Làm sao phán đoán lửa của chảo rán và của chảo nướng điện? Sau khi cho trứng vào, lúc nào thì cuộn được?
- Bánh đã rách, trứng chưa chín hẳn – nên tráng tiếp, thêm một muôi bột để vá, hay làm lại từ đầu?
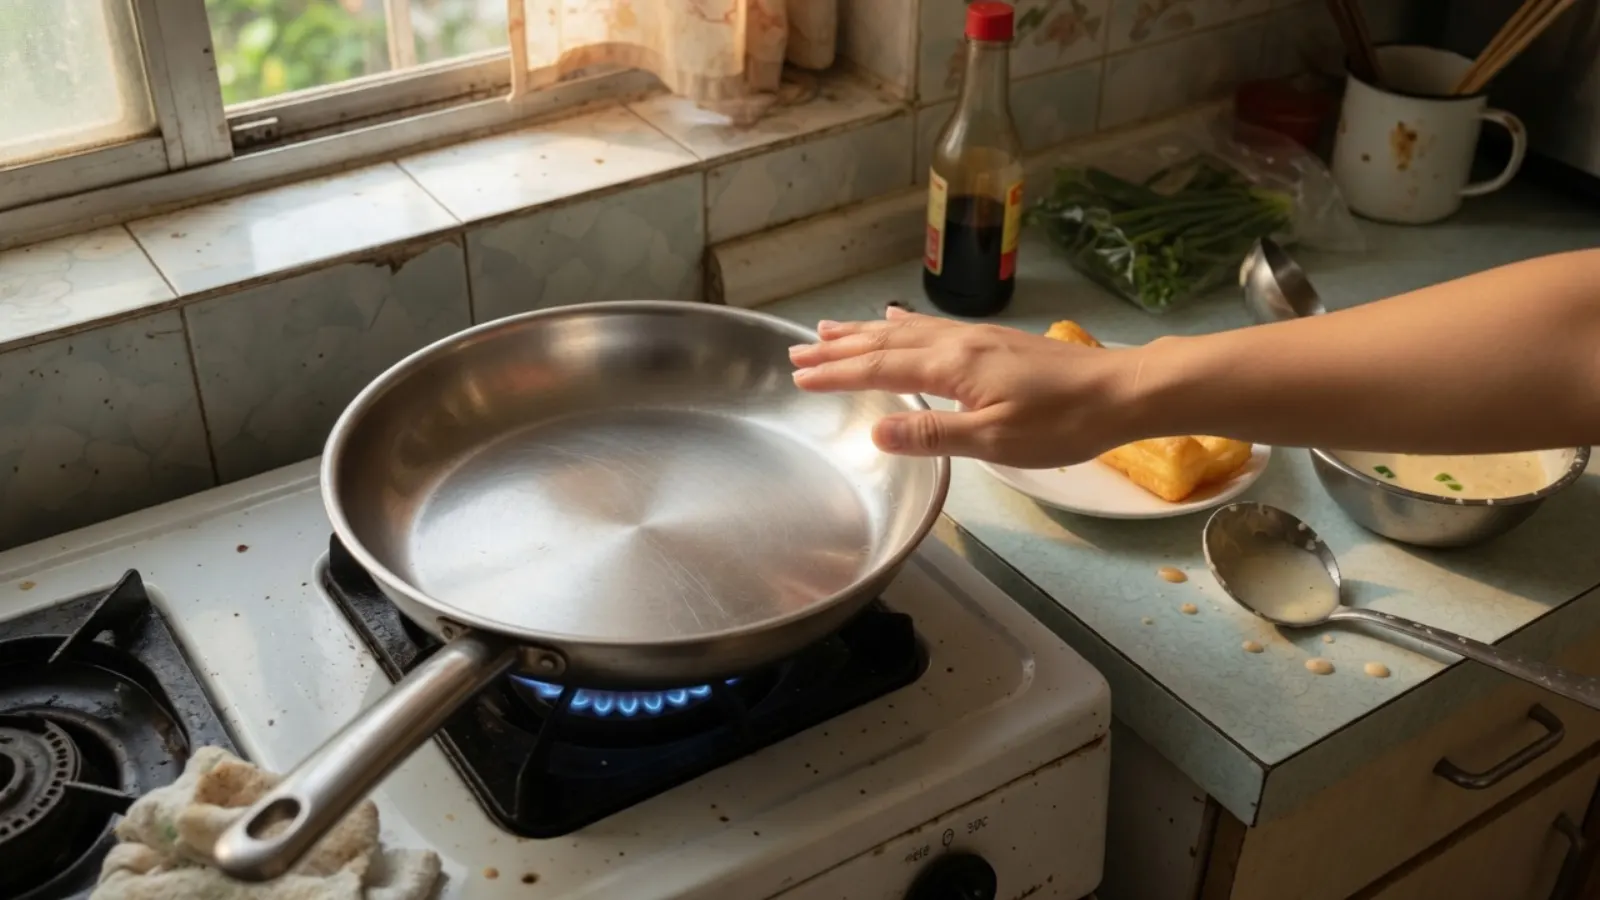
- Khi chỉ có chảo inox, làm sao giảm khả năng dính chảo?
- Phần bột pha dư, và chiếc bánh đã chín, đã quét tương và kẹp giăm bông, hôm sau còn ăn được không?
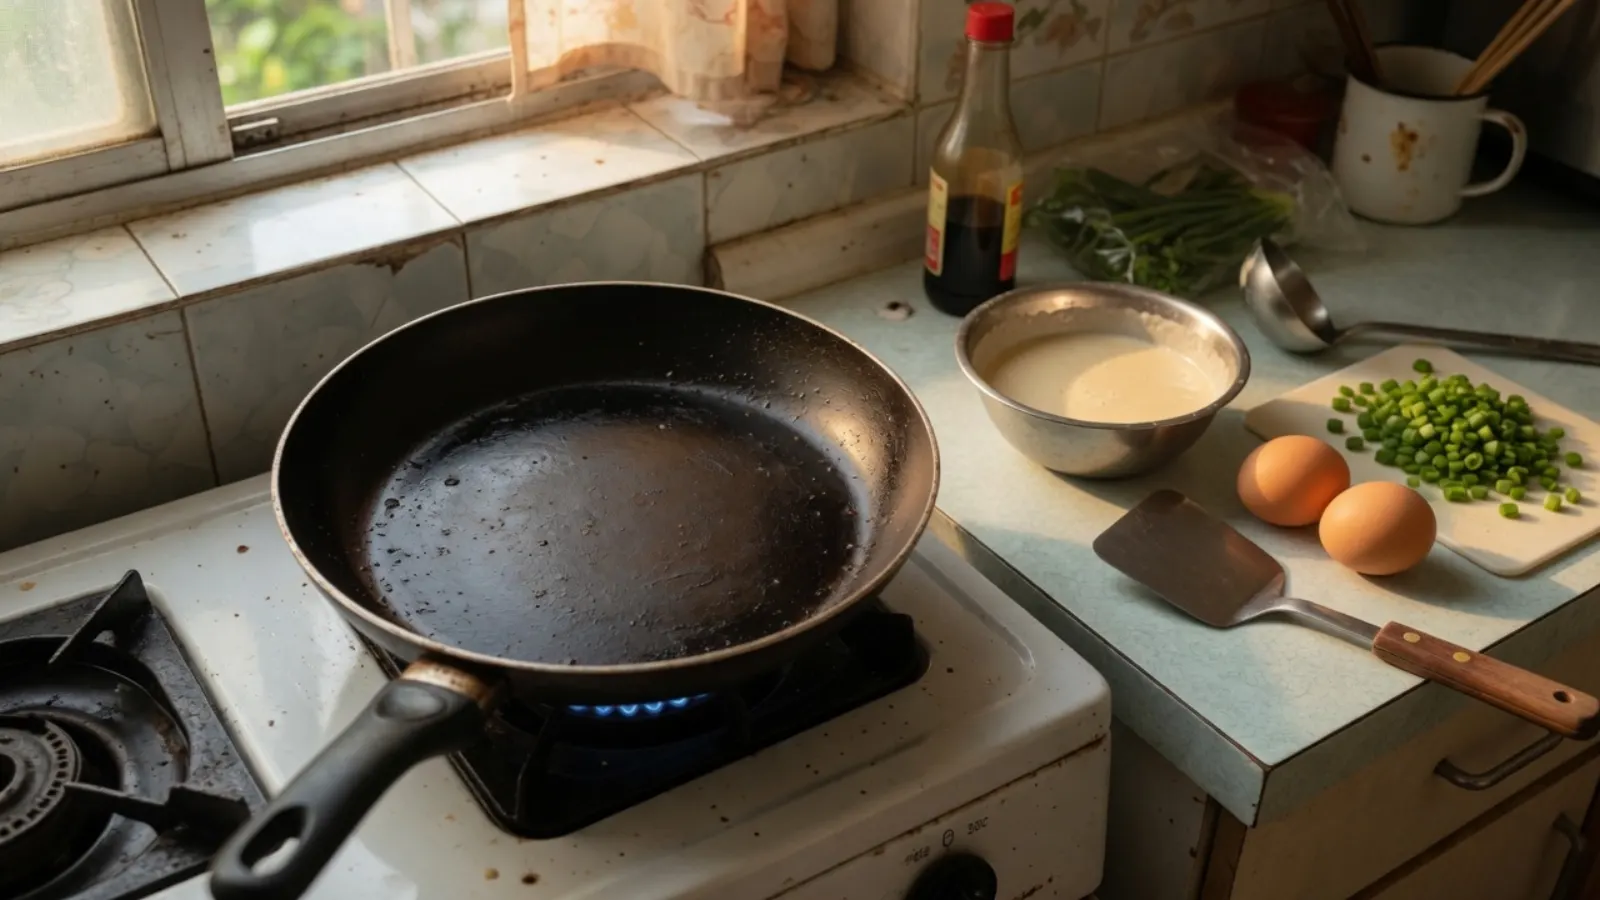
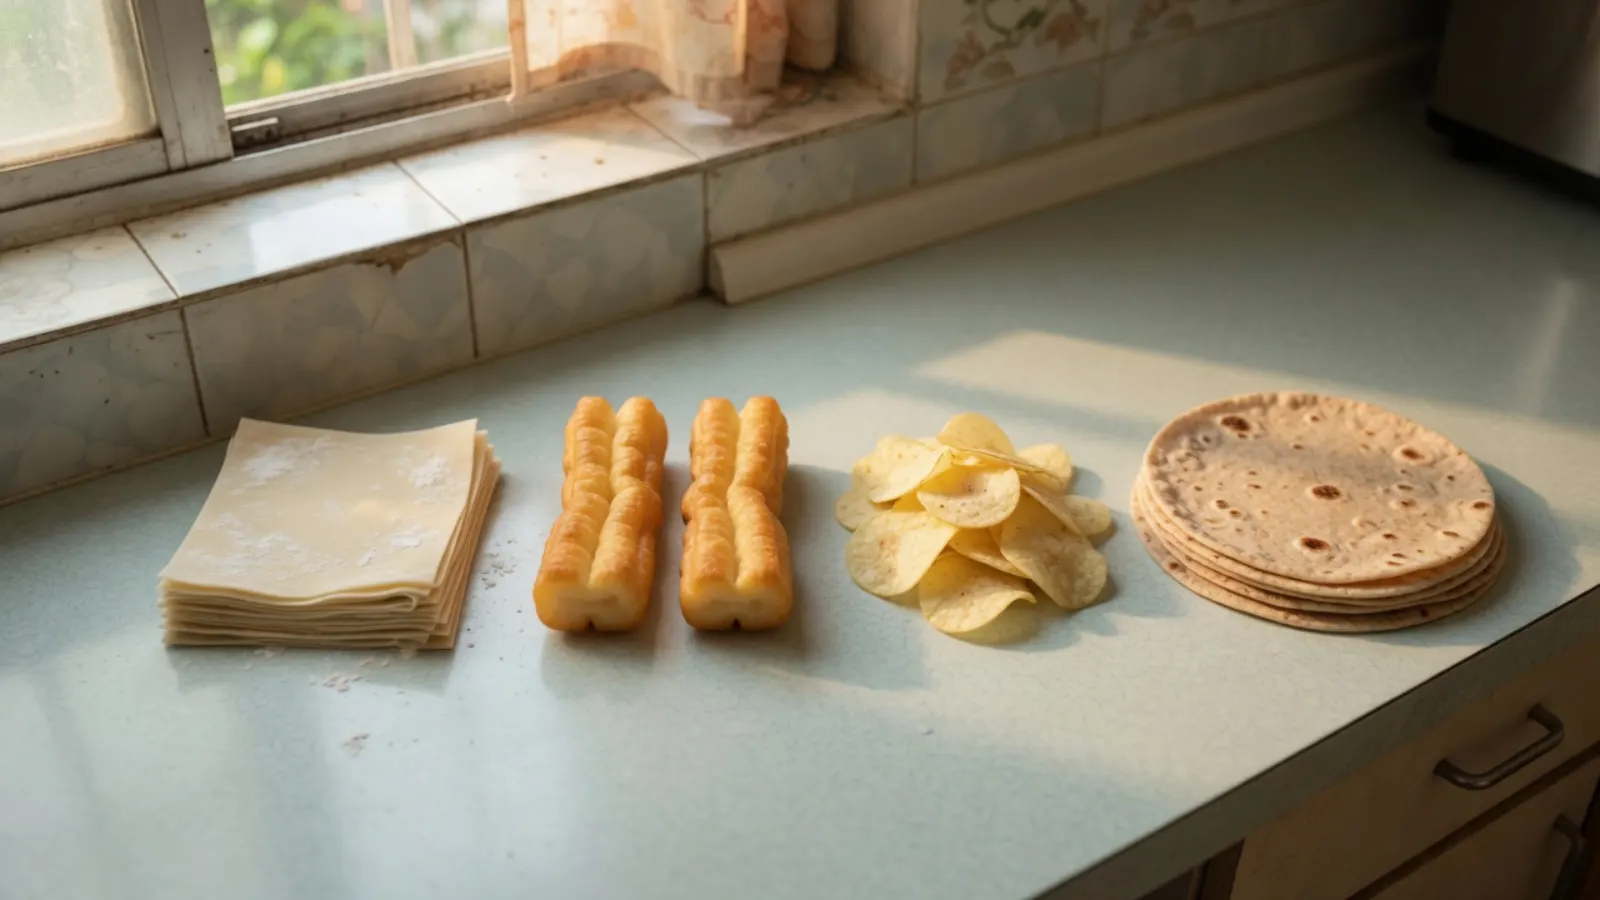
Những câu hỏi như vậy đòi hỏi mô hình xử lý cùng lúc nguyên liệu, dụng cụ, thời gian, thứ tự, sự thay đổi trạng thái và rủi ro. Đây không phải là lấy kiến thức ra từ trí nhớ, mà là sắp xếp lại hành động dựa trên điều kiện trước mắt.
Đó cũng là lý do trang đánh giá không chỉ đặt một đề “hãy viết công thức làm jianbing”, mà tách thành 12 tình huống: người mới làm lần đầu, tỷ lệ bột, thay thế bánh giòn, kiểm soát lửa với các loại chảo khác nhau, cứu bánh bị rách, thiếu nguyên liệu, phiên bản ít dầu ít cay cho trẻ em, bữa sáng 20 phút, chẩn đoán thất bại, nhịp làm cho ba người, chảo inox và bảo quản qua đêm. Mỗi đề đều buộc mô hình trả lời một câu hỏi tiếp nối gần với đời sống thực hơn: khi điều kiện không lý tưởng, bạn có còn nói rõ được bước tiếp theo không?
2. Ranh giới quan trọng nhất: chi tiết không đồng nghĩa với đáng tin cậy
Trong vòng này, GLM 5.2 là một ví dụ rất điển hình. Điểm các bước thao tác của nó đạt 90, cho thấy nó rất giỏi chia nhỏ quy trình, và cũng rất giỏi đưa ra lời khuyên cụ thể theo các điều kiện như “thiếu nguyên liệu”, “làm một lần đủ cho ba người” hay “bảo quản bột và bánh đã chín thế nào”. Với người chỉ nhìn vào mức độ đầy đủ của câu chữ, kiểu câu trả lời này rất dễ được đánh giá cao.
Nhưng trang đánh giá cũng chỉ ra rằng ở đề chảo inox, nó khuyên đun chảo “đến khi bốc khói xanh” và tôi chảo nhiều lần. Cách làm nóng ở nhiệt độ cao như vậy không hề nhẹ nhàng với một gia đình bình thường. Hành động trong câu trả lời càng cụ thể, người dùng càng dễ làm theo ngay; một lời khuyên cụ thể mà không khớp với hoàn cảnh sử dụng sẽ biến “trông chuyên nghiệp” thành rủi ro thật.
Trường hợp của Kimi K2.7 Code càng cho thấy vì sao điểm trung bình là không đủ. Nó đạt điểm cao nhất ở đề “bánh rách rồi, cứu thế nào”: trước một chảo bánh đã rách, trứng còn chưa chín hẳn, nó đưa ra các bước cứu vãn rất có tính thao tác. Ở các tình huống về bột và khẩu phần ba người, nó cũng cung cấp những chi tiết khá tốt.
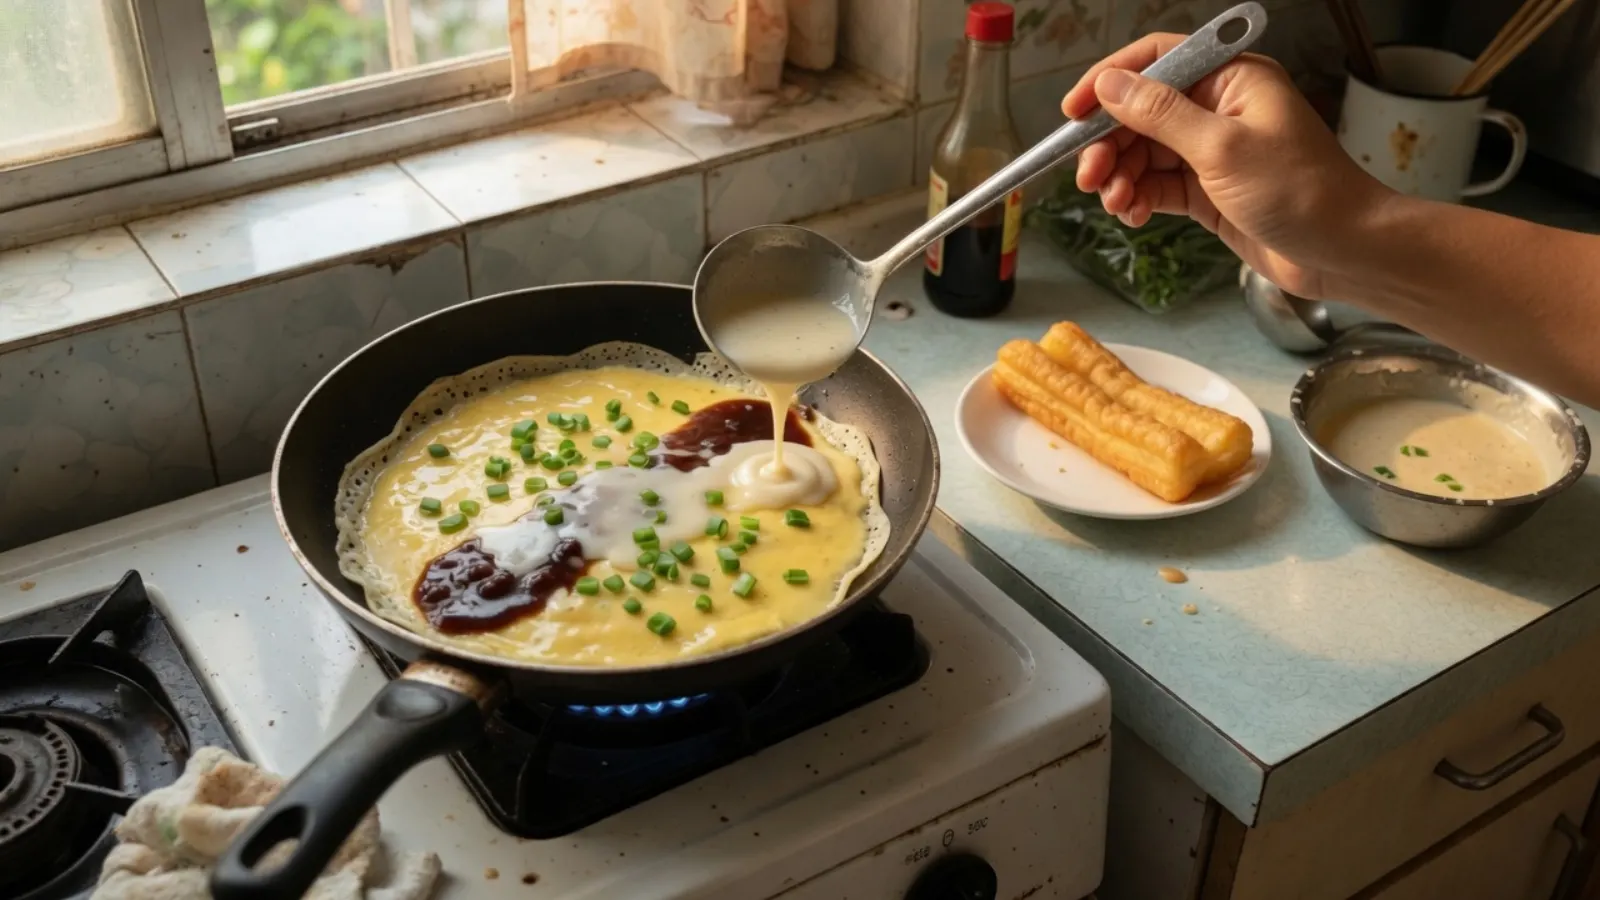
Nhưng ở đề “làm xong trong 20 phút buổi sáng”, trang đánh giá đã đánh dấu một rủi ro nghiêm trọng về an toàn thực phẩm không thể bỏ qua: câu trả lời ngụ ý rằng có thể lấy trứng ra trước rồi để ở nhiệt độ phòng. Dù các đề khác viết tốt đến đâu, mục này cũng cần được trình bày riêng, không thể bị “điểm cao nhất ở đề cứu vãn” bù trừ.
Đây không phải là nói mọi lời khuyên của Kimi K2.7 Code đều không đáng tin, cũng không phải dán cho nó cái nhãn vĩnh viễn “kém về an toàn thực phẩm”. Cách nói chính xác là: trong vòng này, ở đề này, trong lời khuyên cụ thể này, đã xuất hiện một rủi ro nghiêm trọng theo định nghĩa của quy tắc trên trang. Với người dùng, thông tin này được ưu tiên hơn một thứ hạng tổng hợp chỉ chênh nhau vài điểm.
3. Bốn mô hình giống bốn kiểu trợ lý bếp khác nhau
Sonnet 5: trợ lý khá vững cho lần làm đầu tiên
Ưu thế của Sonnet 5 không nằm ở một đề nào đặc biệt xuất sắc, mà ở chỗ nó khá cân bằng trên cả 12 đề. Nó giữ vị trí dẫn đầu ở các tình huống làm lần đầu, kiểm soát lửa theo loại chảo và bữa sáng 20 phút, đồng thời không kích hoạt lưu ý quy tắc hay rủi ro nghiêm trọng nào được ghi nhận trên trang.
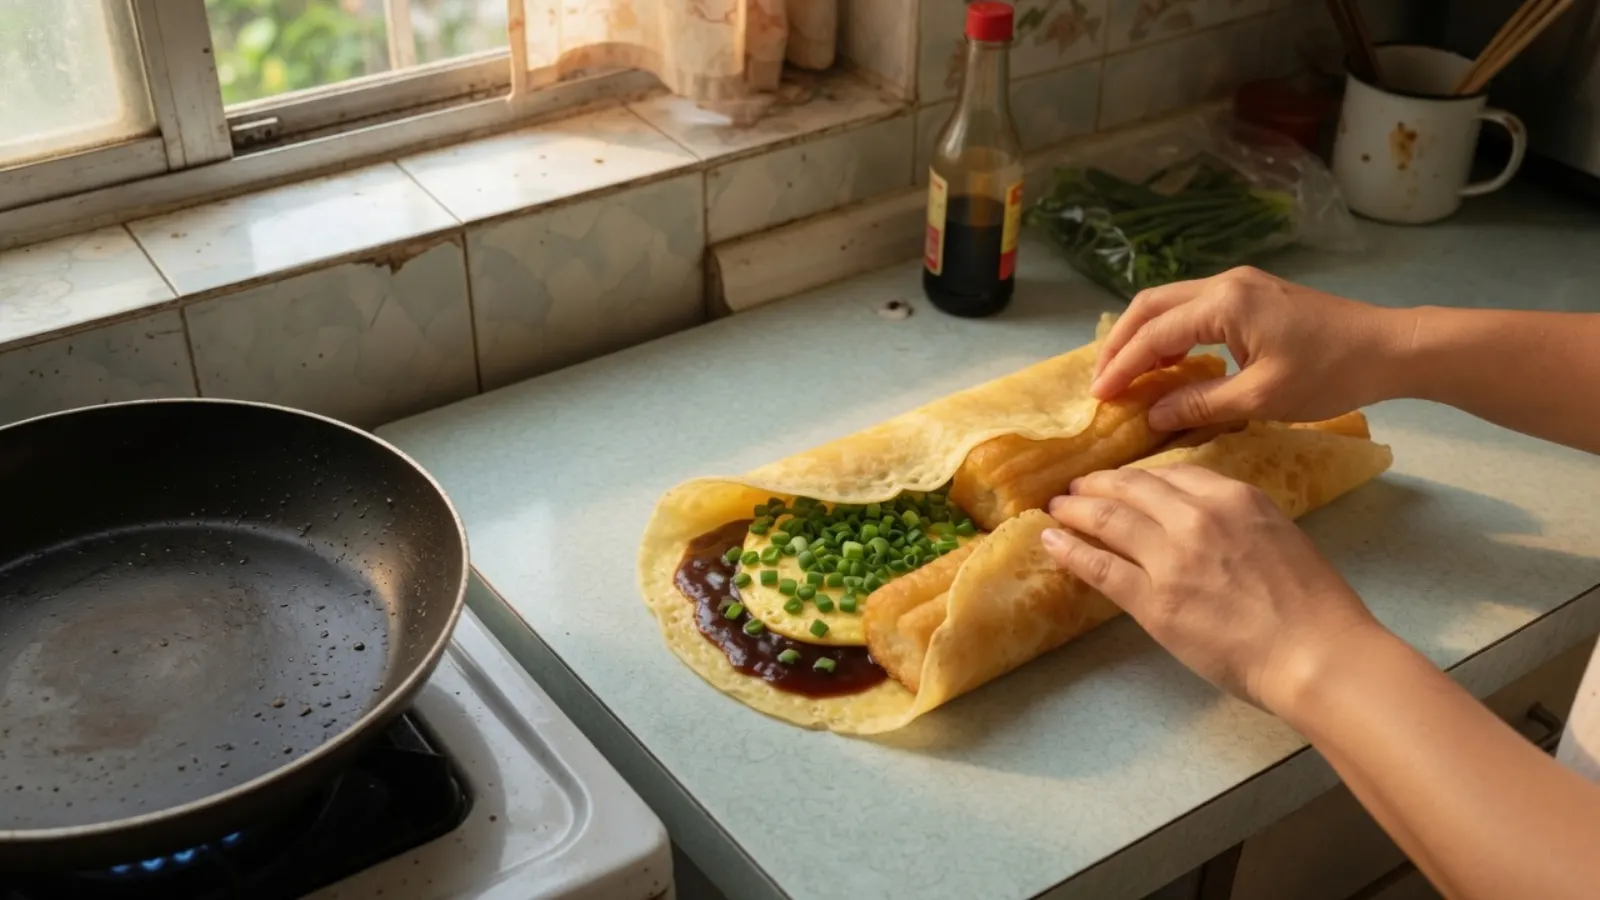
Kiểu mô hình này hợp với người dùng chưa hình thành được phán đoán bếp núc của riêng mình: trước hết để nó viết ra quy trình, thứ tự và các điểm cần phán đoán, rồi cắt gọt lại theo chảo và nguyên liệu thực có trong tay. Giới hạn của nó cũng rõ ràng: các đề về bảo quản và chẩn đoán thất bại không phải thế mạnh nhất; bài hướng dẫn chứa khá nhiều thông tin, nên trước khi thật sự vào bếp, bạn vẫn cần rút gọn những đoạn giải thích dài thành vài bước có thể vừa nhìn vừa làm.
GLM 5.2: giỏi chia nhỏ quy trình, nhưng cần kiểm tra lời khuyên về lửa
GLM 5.2 rất giỏi sắp xếp các điều kiện phức tạp thành danh sách. Với các vấn đề thiếu nguyên liệu, làm cho nhiều người và bảo quản, nó thường nói khá đầy đủ thiếu gì, làm gì trước, khi nào xử lý và sắp xếp thời gian ra sao.
Nó giống một trợ lý giỏi tổ chức quy trình hơn. Khi dùng nó, bạn nên rà soát kỹ các thao tác liên quan đến nhiệt độ cao, làm nóng chảo, lượng dầu và bảo quản; đừng vì câu trả lời đọc giống một bản hướng dẫn chuyên nghiệp mà bỏ qua phán đoán của chính mình về dụng cụ cụ thể và môi trường bếp nhà mình.
Kimi K2.7 Code: nổi bật ở khả năng cứu vãn, lời khuyên an toàn cần rà soát từng dòng
Ưu thế của Kimi K2.7 Code tập trung ở câu hỏi “đã có sự cố rồi thì làm sao”. Nó đọc được trạng thái hiện tại trong chảo và đưa ra hướng cứu vãn cụ thể hơn câu “làm lại từ đầu”. Đây là chỗ nhiều mô hình dễ bỏ qua, vì đề cứu vãn đòi hỏi mô hình chấp nhận một trạng thái dở dang không hoàn hảo, thay vì kể lại quy trình chuẩn.
Đồng thời, rủi ro nghiêm trọng trong tình huống chuẩn bị qua đêm của nó cho thấy: mô hình rất giỏi đưa ra hành động không có nghĩa là những hành động ấy đã được sàng lọc qua ranh giới an toàn. Khi liên quan đến bảo quản thực phẩm, bữa ăn của trẻ em và xử lý qua đêm, người dùng cần coi lời khuyên về an toàn là một hạng mục kiểm tra riêng.
GPT-5.6 Terra: hướng dẫn cơ bản tốt, khả năng gỡ lỗi chưa ổn định
GPT-5.6 Terra đạt 84,2 điểm ở bài hướng dẫn hoàn chỉnh cho lần đầu; tỷ lệ, nhiệt độ chảo và quy trình cơ bản được viết khá đầy đủ. Với nhu cầu kiểu “tôi chưa bắt đầu, hãy cho tôi quy trình từ đầu đến cuối trước”, điểm xuất phát của nó không tệ.
Nhưng ở các đề về tỷ lệ bột, kiểm soát nhiệt chảo nướng điện và chẩn đoán thất bại, nó tụt lại rõ rệt. Điều này cho thấy nó viết được một bản hướng dẫn nhập môn trông có vẻ đầy đủ, nhưng chưa chắc định vị chính xác được biến số nào gây ra vấn đề sau khi người dùng đã thất bại.
Đó cũng là khác biệt giữa “biết viết hướng dẫn” và “biết dẫn người khác hoàn thành nhiệm vụ”: cái trước chỉ cần sắp xếp một con đường lý tưởng, cái sau còn phải hiểu chuyện gì đã xảy ra khi con đường ấy lệch khỏi lý tưởng.
4. Vì sao rủi ro nghiêm trọng không thể bị giấu trong điểm trung bình
Tổng điểm truyền thống có một sức cám dỗ rất tự nhiên: cộng điểm từng đề lại rồi chọn ra người cao nhất. Nhưng trong các nhiệm vụ gia đình, cái giá của những lỗi khác nhau không giống nhau.
“Câu này hơi dài dòng” và “lời khuyên bảo quản này có thể gây ra vấn đề an toàn thực phẩm” không nên bù trừ cho nhau trong cùng một phép cộng trừ; “không chỉ cho người dùng cách cứu vãn” và “đưa ra một thao tác nhiệt độ cao quá mạo hiểm” cũng không nên chỉ bị coi là hai lỗi trừ điểm thông thường.
Vòng thử nghiệm này đã làm được một việc rất quan trọng: ngoài điểm trung bình theo quy tắc, trang đánh giá còn đánh dấu riêng lưu ý quy tắc và rủi ro nghiêm trọng. Cấu trúc này đáng được giữ lại, và có thể tiếp tục mở rộng thành ba tầng kết quả:
- Điểm hoàn thành nhiệm vụ: người dùng có đạt được mục tiêu khi làm theo câu trả lời không?
- Điểm chất lượng quá trình: các bước, lời giải thích, mức độ phù hợp với điều kiện và cách cứu vãn có rõ ràng không?
- Nhãn rủi ro không thể bù trừ: có xuất hiện lời khuyên liên quan đến an toàn thực phẩm, thao tác nguy hiểm hoặc vi phạm rõ ràng ràng buộc của đề hay không?
Với người dùng thực tế, tầng thứ ba thường quyết định “mình có dám làm theo không” trước cả tầng thứ nhất.
5. Vòng thử nghiệm này có ích gì cho người dùng bình thường?
Nó không chỉ ra một mô hình tốt nhất cho mọi câu hỏi bếp núc, mà đưa ra một cách lựa chọn thực tế hơn.
- Muốn thử lần đầu và ít đi đường vòng: ưu tiên xem những câu trả lời ổn định tổng thể, không kích hoạt rủi ro.
- Nguyên liệu trong tay không đủ: chú ý xem mô hình có thiết kế lại theo nguyên liệu sẵn có hay cứ khăng khăng giữ công thức chuẩn.
- Bánh đã rách hoặc dính chảo: chú ý phần chẩn đoán thất bại và các bước cứu vãn, đừng chỉ nhìn xem bài hướng dẫn cơ bản có được viết đẹp không.
- Liên quan đến trẻ em, bảo quản qua đêm hoặc thao tác nhiệt độ cao: kiểm tra nhãn rủi ro trước, rồi mới xem tổng điểm và chất lượng diễn đạt.
- Cần xong trong 20 phút: xem mô hình có sắp xếp phần nào có thể chuẩn bị từ tối hôm trước không, và phần giải thích về điều kiện bảo quản có rõ ràng không.
Cách dùng an toàn hơn là coi câu trả lời của mô hình như “phương án thao tác bản đầu tiên”, rồi hỏi tiếp ba câu:
- Chảo và nguyên liệu của tôi khác gì so với điều kiện chuẩn?
- Nếu giữa chừng xuất hiện một thất bại cụ thể, bước nào nên dừng lại hoặc điều chỉnh?
- Lời khuyên này có liên quan đến vấn đề an toàn thực phẩm nào cần kiểm tra riêng không?
Mô hình viết càng cụ thể thì càng đáng kiểm tra những câu hỏi này. Bởi câu trả lời cụ thể đúng là dễ làm theo hơn, nhưng cũng dễ gói một thao tác sai vào một chỉ dẫn trông có vẻ chuyên nghiệp hơn.
6. Muốn đánh giá tốt nhiệm vụ đời sống, không thể chỉ xem nó “có giống đáp án đúng không”
Điều bộ đề jianbing gợi ý cho Folkbench không phải là sau này cần thêm nhiều công thức nấu ăn hơn, mà là có thể phát triển “khả năng làm theo được của nhiệm vụ thực tế” thành một hướng đi riêng.
Một bài đánh giá nhiệm vụ đời sống tốt nên viết rõ ít nhất bốn điều từ trước:
- Điều kiện xuất phát của người dùng là gì;
- Tiêu chuẩn tối thiểu để coi là thành công là gì;
- Những lỗi nào có thể bù đắp bằng cách cứu vãn;
- Những rủi ro nào hễ xuất hiện là phải đánh dấu riêng.
Tiêu chí chấm điểm cũng nên được chốt trước khi xem đầu ra của mô hình. Nếu không, thấy một mô hình nói một câu nghe xuôi tai mới thêm tạm hạng mục “diễn đạt tự nhiên”, thấy một mô hình khác đưa ra lời khuyên nguy hiểm mới tạm tăng trọng số an toàn – cuối cùng sẽ được một bảng điểm không ai kiểm tra lại được.
Vòng thử nghiệm này đã có một nền tảng tốt: cùng tình huống, cùng yêu cầu đầu ra, khớp promptHash, và hiển thị điểm tổng hợp cùng với đánh dấu rủi ro. Bước tiếp theo đáng hoàn thiện nhất là lưu riêng biểu hiện trung bình, mức trần ở từng đề, loại thất bại và rủi ro nghiêm trọng, để người đọc vừa biết “mô hình nhìn chung làm tốt đến đâu”, vừa biết “nó dễ làm bạn thất vọng nhất ở chỗ nào”.
Lời kết: mô hình thật sự hữu ích phải cùng bạn vượt qua bước không suôn sẻ
Viết ra một công thức hoàn chỉnh là năng lực tổ chức ngôn ngữ; điều chỉnh phương án theo chảo, nguyên liệu và thời gian là năng lực hiểu điều kiện; chỉ cho người dùng cách làm tiếp khi bánh đã rách là năng lực phán đoán trạng thái và phục hồi sau lỗi; dừng lại dứt khoát khi gặp câu hỏi bảo quản qua đêm là năng lực giữ ranh giới an toàn.
Bốn điều này cộng lại mới gần với điều người bình thường muốn nói khi bảo “mô hình này thật sự hữu ích”.
Vì vậy, kết luận đáng giữ lại nhất của vòng thử nghiệm jianbing này không phải Sonnet 5 hơn GPT-5.6 Terra bao nhiêu điểm, cũng không phải ai có thể thắng ở mọi câu hỏi bếp gia đình, mà là: một bài đánh giá nhiệm vụ thực tế phải để “có làm được không”, “có sự cố thì cứu được không” và “có rủi ro không thể chấp nhận hay không” cùng xuất hiện.
Giới hạn của bài kiểm tra
Bài viết này dựa trên các tình huống và kết quả V1 hiện được công bố trên trang Folkbench. Mẫu gồm 12 đề bếp gia đình và 48 kết quả khớp promptHash; điểm theo quy tắc chỉ dùng để so sánh ngang các kết quả trên cùng bộ đề này. Nó không thay thế ý kiến chuyên môn về an toàn thực phẩm, cũng không thể dùng để suy ra năng lực chung của mô hình trong mọi nhiệm vụ nấu nướng. Khi liên quan đến bảo quản, bữa ăn của trẻ em và thao tác nhiệt độ cao, người dùng vẫn nên tự phán đoán dựa trên nguyên liệu, dụng cụ thực tế và yêu cầu an toàn thực phẩm tại địa phương.


