
一個模型能寫出一份步驟完整、語氣耐心的煎餅果子教學,不代表新手真的能照著做成功。
真實的家庭廚房有很多變數:鍋子的尺寸和材質不同,麵糊可能太稠或太稀,火候會在攤餅、下蛋、翻面之間變化,薄脆不一定買得到,早上可能只有 20 分鐘。第一次失敗之後,使用者需要的也不是另一份漂亮的食譜,而是有人能判斷「剛才為什麼會破」,並告訴他這一鍋還有沒有救。
所以,這次 煎餅果子製作評測 真正測的,不是模型會不會背一份食譜,而是它能不能把知識變成家庭廚房裡可以執行、可以調整、出了問題還能繼續走下去的方案。
先看結論:平均分數之外,差異藏在失敗和風險裡
這輪測試設定了 12 個家庭廚房情境,四個模型一共留下 48 筆 promptHash 相符的結果。頁面的規則評分從五個角度檢視回答:步驟能不能照著做、有沒有廚房常識、出了狀況會不會處理、表達是否清楚,以及有沒有把自己寫成一個過度自信的「老師傅」。
頁面公布的綜合分數如下:
| 模型 | 綜合分數 | 12 題中得分居首(含並列) | 頁面標記的規則提示或硬性風險 |
|---|---|---|---|
| Sonnet 5 | 80.4 | 6 題 | 無 |
| GLM 5.2 | 79.3 | 5 題 | 1 項規則提示 |
| Kimi K2.7 Code | 77.6 | 3 題 | 1 項規則提示、1 項硬性風險 |
| GPT-5.6 Terra | 75.6 | 0 題 | 無 |
Sonnet 5 以 80.4 分領先,整體上更像一份可以交給新手的教學:第一次製作、鍋具控火和 20 分鐘早餐等情境都相對穩定。GLM 5.2 只落後 1.1 分,操作步驟分數卻達到 90 分,是全場最高。Kimi K2.7 Code 的綜合分數較低,但在「攤破了怎麼救」這類需要臨場補救的情境裡表現最好。GPT-5.6 Terra 的首次完整教學得分達到 84.2,卻在麵糊比例、電烤盤控火和失敗診斷題上出現明顯短板。
表面上看,這是一張四個模型的成績單。更值得關注的,其實是它把一個常被忽略的事實攤在眼前:可執行性不是單一能力。模型可能擅長把步驟寫清楚,卻不擅長診斷失敗;也可能很會補救,卻在安全邊界上留下不容忽視的問題。
一、家庭廚房不是食譜展示台
如果只問「煎餅果子怎麼做」,模型很容易給出一份看起來完整的標準答案:準備麵粉、調麵糊、預熱鍋子、攤餅、打蛋、撒蔥花、刷醬、放薄脆,然後捲起來。
這份答案在文字層面可能沒有明顯錯誤,但它沒有回答新手真正會遇到的幾個問題:
- 家裡只有 26 公分的不沾鍋,沒有攤餅刮板,湯杓和鍋鏟夠不夠用?
- 麵糊到底要稀到什麼程度?為什麼同樣的水粉比例,有人攤出來很厚,有人一鏟就破?
- 沒有薄脆時,餛飩皮、油條、洋芋片和一般薄餅分別會帶來什麼結果?
- 平底鍋和電烤盤的火候怎麼判斷?蛋下鍋後,什麼時候可以捲?
- 餅已經破了,蛋還沒完全凝固,應該繼續攤、補一杓麵糊,還是直接重來?
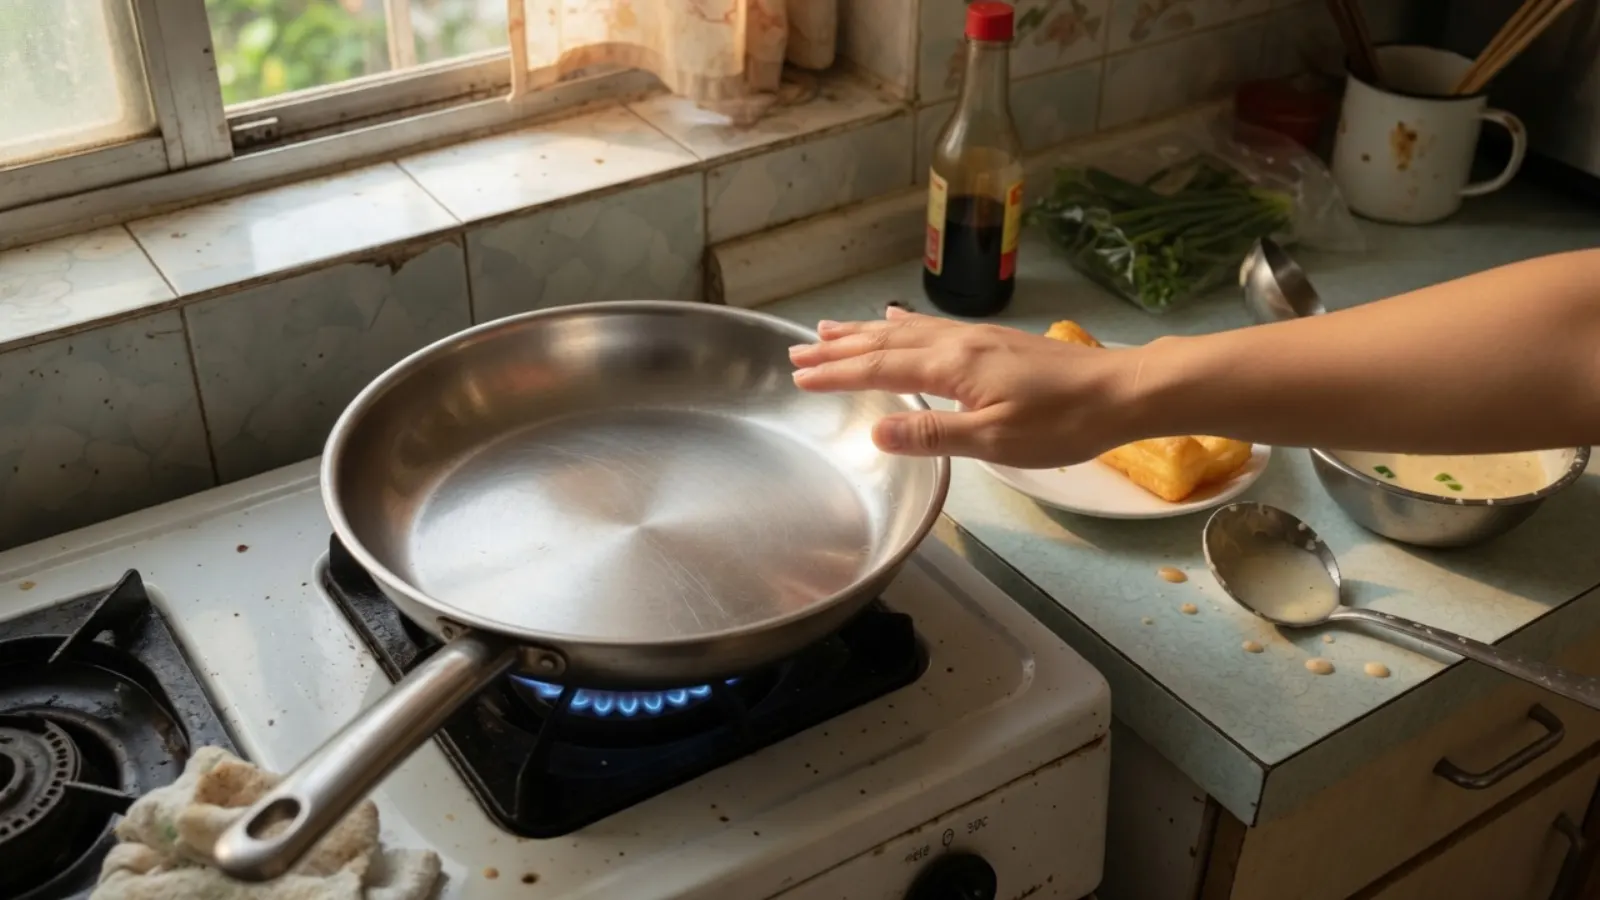
- 只有不鏽鋼鍋時,怎樣降低沾鍋的機率?
- 調多的麵糊,和已經刷醬、夾了火腿的熟餅,隔天還能不能吃?
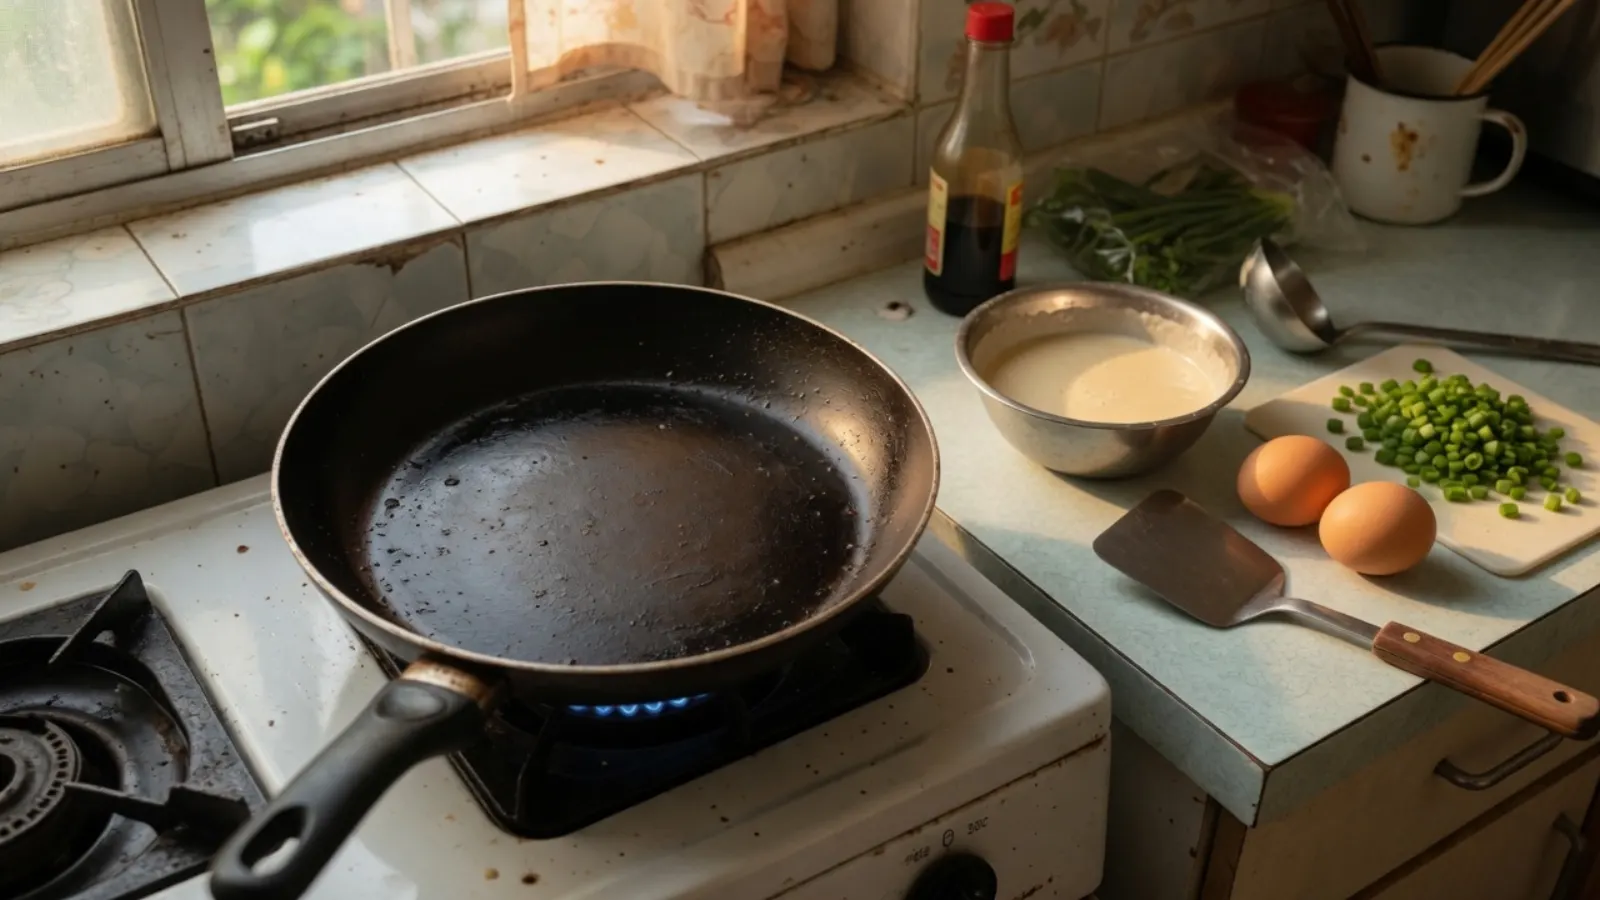
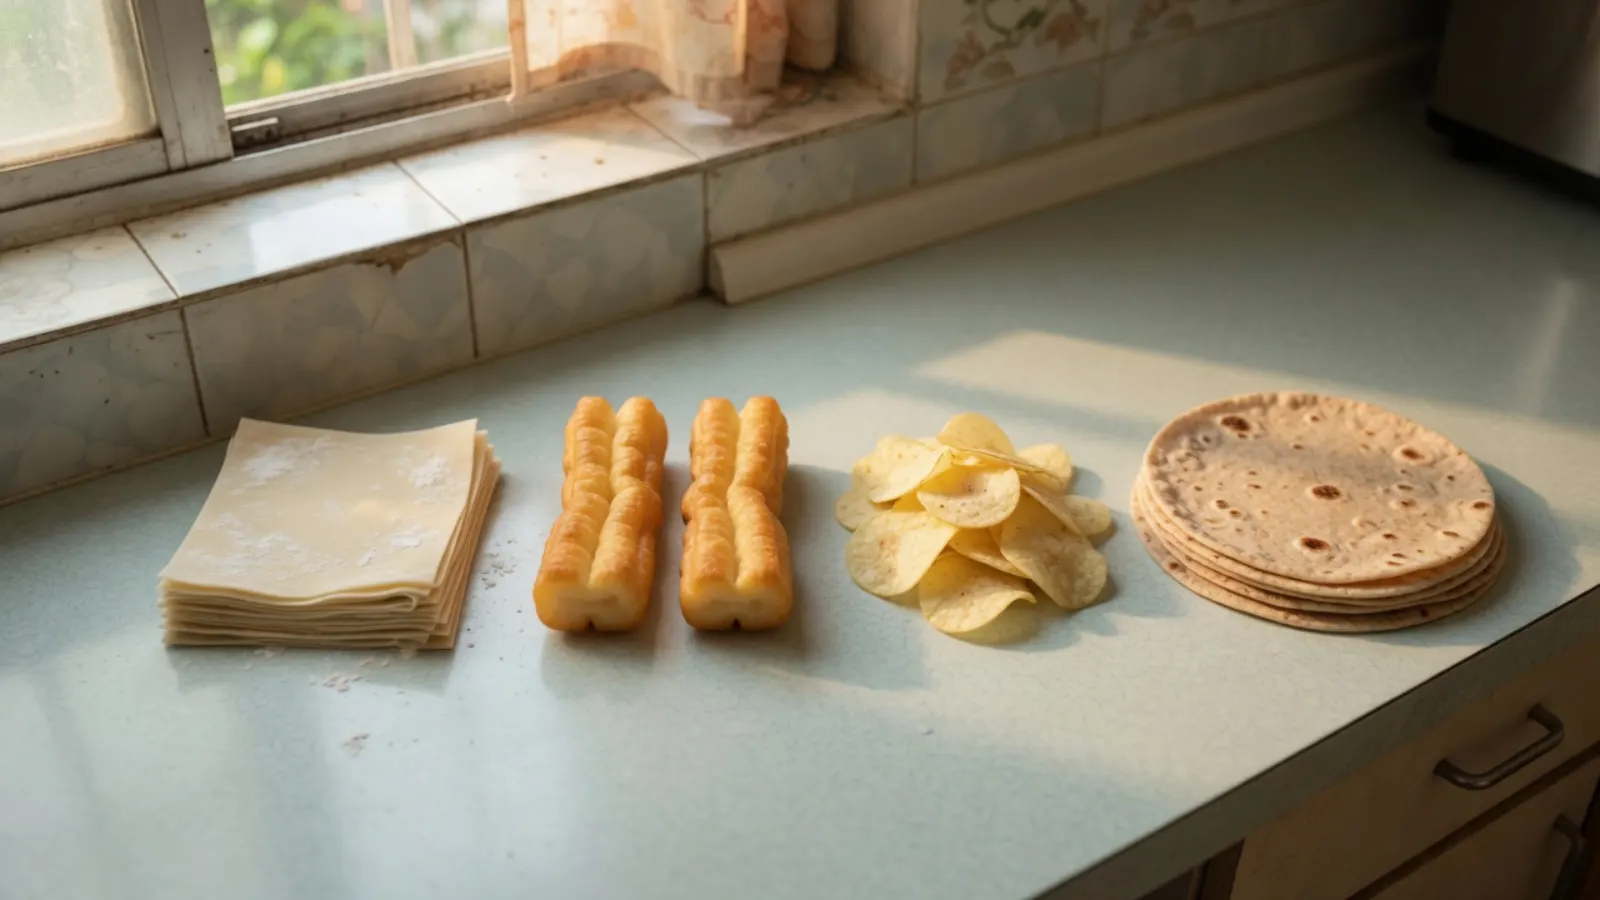
這類問題要求模型同時處理食材、工具、時間、順序、狀態變化和風險。它不是把知識從記憶裡取出來,而是要根據當下的條件重新組織行動。
這也是為什麼頁面沒有只出一題「請寫一份煎餅果子食譜」,而是拆成 12 個情境:新手第一次做、麵糊比例、薄脆替代、不同鍋具控火、攤破補救、食材不足、兒童少油少辣版、20 分鐘早餐、失敗診斷、三人份節奏、不鏽鋼鍋和隔夜保存。每道題都在逼模型回答一個更貼近真實生活的追問:在條件不理想時,還能不能把下一步說清楚?
二、最重要的分界線:詳細不等於可靠
這輪結果裡,GLM 5.2 是一個很好的例子。它的操作步驟分數達到 90 分,說明它很會把流程拆開,也很會針對「食材不夠」「一次做三人份」「麵糊和熟餅怎麼保存」等條件提出具體建議。對只看文字完整度的人來說,這類回答很容易拿到高評價。
但頁面同時指出,它在不鏽鋼鍋題裡建議「燒到冒青煙」,並重複養鍋。這種高溫預熱方式對一般家庭並不溫和。回答裡的動作越具體,使用者越可能直接照做;具體建議如果和使用情境不相符,就會把「看起來很專業」變成實際的風險。
Kimi K2.7 Code 的情況更能說明平均分數為什麼不夠用。它在「攤破了怎麼救」一題得分最高,面對一鍋已經破掉、蛋還沒完全凝固的半成品時,給出了很有操作感的補救步驟。它在麵糊和三人份情境裡也提供了不錯的細節。
但在「早上 20 分鐘內完成」這一題裡,頁面標記了一個不容忽視的食品安全硬性風險:回答暗示雞蛋可以提前拿出來,放在室溫下。無論其他題寫得多好,這一項都應該單獨呈現,不能被「補救題得分最高」抵銷。
這不是在說 Kimi K2.7 Code 的所有建議都不可靠,也不是替它貼上「食品安全能力差」的永久標籤。準確的說法是:在這一輪、這一道題、這一個具體建議裡,出現了頁面規則所定義的硬性風險。 對使用者而言,這條資訊的優先順序,高於只差幾分的綜合排名。
三、四個模型更像四種不同的廚房助手
Sonnet 5:比較穩的第一次製作助手
Sonnet 5 的優勢不在於某一道題特別驚豔,而是 12 道題整體比較均衡。它在第一次製作、鍋具控火和 20 分鐘早餐等情境保持領先,而且沒有觸發頁面記錄的規則提示或硬性風險。
這類模型適合還沒建立自己廚房判斷的使用者:先讓它把流程、順序和判斷節點寫出來,再依照自己手邊的鍋具和食材刪減。它的限制也很明確:保存和失敗診斷題並不是它最強的部分;教學的資訊量偏大,真正下廚前,仍然需要把長篇解釋濃縮成幾張能邊看邊做的步驟卡。
GLM 5.2:流程拆解強,但要檢查火候建議
GLM 5.2 很擅長把複雜條件整理成清單。面對食材不足、多人份和保存問題,它常常能把缺什麼、先做什麼、什麼時候處理、怎麼安排時間說得相當完整。
它更像一個擅長整理流程的助手。使用時,應該重點複核高溫、預熱、油量和保存相關的動作,不要因為回答寫得很像專業教學,就略過對實際器具和家庭環境的判斷。
Kimi K2.7 Code:補救能力突出,安全建議要逐條複核
Kimi K2.7 Code 的優勢集中在「已經出問題了怎麼辦」。它能看出鍋裡現在處於什麼狀態,並提供比「重新來一遍」更具體的補救路徑。這是很多模型容易忽略的地方,因為補救題要求模型接受一個不完美的中間狀態,而不是重新講一遍標準流程。
同時,它在隔夜準備情境中的硬性風險也說明:模型很會給出動作,不代表這些動作都經過了安全邊界的篩選。涉及食物保存、兒童飲食和隔夜處理時,使用者需要把安全建議當成獨立的檢查項目。
GPT-5.6 Terra:基礎教學不錯,疑難排解不夠穩定
GPT-5.6 Terra 的首次完整教學得分達到 84.2,比例、鍋溫和基礎流程都寫得相當完整。對於「我還沒開始做,先給我一份從頭到尾的流程」這種需求,它的起點不差。
但在麵糊比例、電烤盤控火和失敗診斷題裡,它的表現明顯落後。這說明它能寫出一份看起來完整的入門說明,卻不一定能在使用者已經失敗之後,準確找出是哪個變數出了問題。
這也是「會寫教學」和「會帶人完成任務」的差別:前者只需要安排一條理想路徑,後者還要理解偏離理想路徑之後發生了什麼。
四、為什麼硬性風險不能被平均分數掩蓋
傳統的總分有一個很自然的誘惑:把每道題的分數加起來,再挑出最高分。但在家庭任務裡,不同錯誤的代價並不相同。
「這句話有點囉唆」與「這個保存建議可能帶來食品安全問題」,不應該在同一道加減法裡互相抵銷;「沒有告訴使用者怎麼補救」與「給出一個過於激進的高溫動作」,也不應該只被當成兩個普通的扣分項目。
這輪測試已經在做一件很重要的事:頁面除了公布規則平均分數,也另外標出規則提示和硬性風險。這個結構值得保留,還可以進一步擴展成三層結果:
- 任務完成分數:使用者能不能照著回答達成目標;
- 過程品質分數:步驟、解釋、條件適用和補救是否清楚;
- 不可抵銷的風險標籤:是否出現食品安全、危險操作或明顯違反題目限制的建議。
對真實使用者來說,第三層往往比第一層更早決定「我敢不敢照著做」。
五、這輪測試對一般使用者有什麼用?
它沒有選出一個在所有廚房問題上都最好的模型,而是提供了更實際的選擇方式。
- 想第一次嘗試、希望少走冤枉路:優先看整體穩定、沒有觸發風險的回答。
- 手邊食材不齊:重點看模型會不會根據現有食材重新設計,而不是堅持標準配方。
- 已經攤破或沾鍋:重點看失敗診斷和補救步驟,不要只看基礎教學寫得漂不漂亮。
- 涉及兒童、隔夜保存或高溫操作:先檢查風險標籤,再看總分和表達品質。
- 要在 20 分鐘內完成:看模型有沒有安排前一晚就能準備的部分,以及它對保存條件的說明是否明確。
比較穩妥的使用方式,是把模型的回答當作「第一版操作方案」,再繼續追問三個問題:
- 我的鍋具和食材與標準條件有什麼不同?
- 如果中途出現某個具體的失敗,應該在哪一步停下或調整?
- 這條建議是否涉及需要另外查證的食品安全問題?
模型寫得越具體,越值得檢查這些問題。因為具體的回答確實比較容易執行,也比較容易把一個錯誤動作包裝成看似專業的指示。
六、把生活任務測好,不能只看「像不像正確答案」
煎餅果子這組題帶給 Folkbench 的啟發,不是以後要繼續增加更多食譜,而是可以把「現實任務的可執行性」當作一個獨立方向繼續發展。
一項好的生活任務評測,至少應該事先寫清楚四件事:
- 使用者的起始條件是什麼;
- 任務成功的最低標準是什麼;
- 哪些錯誤可以透過補救彌補;
- 哪些風險一旦出現,就必須單獨標記。
評分標準也應該在看到模型輸出之前就凍結。否則,看到某個模型說出一句很順耳的話,才臨時增加「表達自然」這一項;看到另一個模型給出危險建議,才臨時調高安全權重,最後只會得到一張無法複查的成績單。
這輪測試已經有很好的基礎:統一情境、統一輸出要求、比對 promptHash、同時呈現綜合分數和風險提示。下一步最值得繼續完善的,是把平均表現、單題上限、失敗類型和硬性風險分開儲存,讓讀者知道「模型整體表現如何」,也知道「它最可能在哪裡讓您失望」。
結語:真正有用的模型,要能陪您走過不順利的那一步
寫出一份完整的食譜,是語言組織能力;根據鍋具、食材和時間調整方案,是理解條件的能力;在餅已經破掉之後告訴使用者怎麼繼續,是狀態判斷和錯誤復原能力;遇到隔夜保存問題時明確停下來,是安全邊界能力。
這四件事疊加在一起,才更接近一般人說的「這個模型真的有用」。
所以,這輪煎餅果子測試最值得留下的結論,不是 Sonnet 5 比 GPT-5.6 Terra 高多少分,也不是誰能在所有家庭廚房問題上勝出,而是:一項現實任務的評測,必須讓「能不能做成」「出了問題能不能救」和「有沒有無法接受的風險」同時呈現。
測試邊界
本文依據 Folkbench 頁面目前公布的 V1 情境和結果撰寫。樣本是 12 道家庭廚房題、48 筆 promptHash 相符的結果,規則分數只用於這組同題結果的橫向比較。它無法取代食品安全專業意見,也不能據此推論模型在所有烹飪任務上的普遍能力。涉及保存、兒童飲食和高溫操作時,使用者仍應依實際食材、器具和當地的食品安全規範,自行獨立判斷。


