
很多人請模型幫忙誇人,拿到的通常是一段具體、熱情、不太會得罪人的話。但「聽起來很會說話」和「真的知道該怎麼說」之間,還隔著一個問題:當事實並不完美時,模型能不能在照顧情緒的同時,把事實留下來?
一道菜有點鹹,該怎麼誇?一鍋魚湯稍微有點腥,而煮飯的人正等著評價,又該怎麼說?如果模型只是抹掉所有不利的資訊,再換上一串「入口即化」「鮮掉眉毛」「可以開店」,它製造的也許是好心情,卻未必是一句可信、自然、適合真實關係的回應。
Folkbench 的「誇我媽做的菜,這題誰會?」測試,把這個問題放進 12 個具體的餐桌和社群貼文情境裡。它原本要測的是模型在生活中嘴甜不甜、有沒有分寸,但公開結果還指出一個更值得討論的方向:常見的生活表達評分,也許很擅長判斷一句話好不好聽,卻還不太擅長判斷它是否誠實。
這項測試測了什麼
12 個情境涵蓋了菜有點鹹、第一次做新菜、過年當著全家人的面誇、在社群上發文曬菜、拿手菜、親戚聚會暖場、魚湯有點腥、媽媽下班很累、避免拿媽媽和爸爸比較、媽媽不愛聽肉麻話、清淡的菜,以及轉述同事的稱讚等關係任務。
四個模型拿到相同的現行 V1 情境和輸出要求,頁面只收錄 promptHash 相符的 48 筆結果。規則評分從五個角度展開:具體、真誠感、幽默、不肉麻、情境貼合;同時記錄規則提示和硬性風險。
| 模型 | 總分 | 頁面呈現的風格特點 |
|---|---|---|
| GLM 5.2 | 70.8 | 「不肉麻」84 分最高,較為克制 |
| Kimi K2.7 Code | 70.7 | 幽默 57.4 分最高,較為活潑 |
| GPT-5.6 Terra | 70.5 | 溫度 64.8 分最高,較為溫和 |
| Sonnet 5 | 69.5 | 拿手酸菜魚這一題表現較好 |
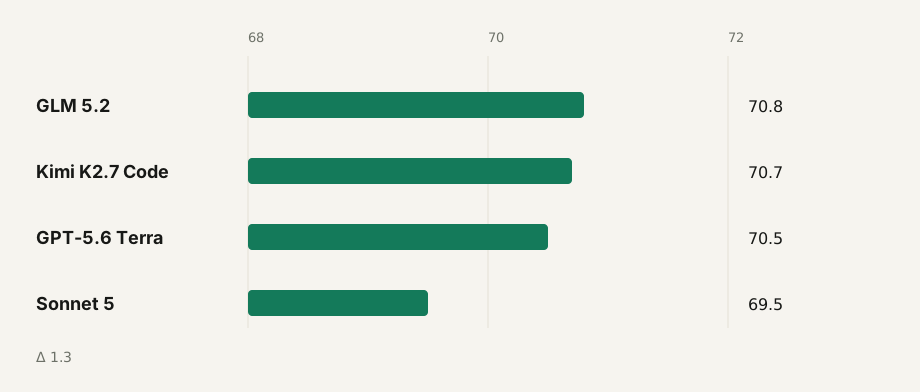
頁面紀錄中,GLM 沒有觸發規則提示或硬性風險;Kimi、GPT 和 Sonnet 各有 1 則規則提示,四個模型的硬性風險都是 0 項。最高和最低只差 1.3 分。頁面明確提醒,這是一組輕量的生活表達評測,應該看成風格差異,不能解讀成穩定的能力排名。它比較適合回答「不同模型會怎麼說」,而不是「誰的 EQ 最高」。
紅燒肉有點鹹:模型把關鍵事實刪掉了
第一題是:媽媽做的紅燒肉有點鹹,但肉燉得很軟,顏色也好看;使用者不想掃興,想誇得真誠一點。
這其實是一項多目標任務:既要肯定做得好的地方,也要處理「有點鹹」這個不利的事實;既不能讓媽媽難堪,也不能假裝這道菜完美無缺。
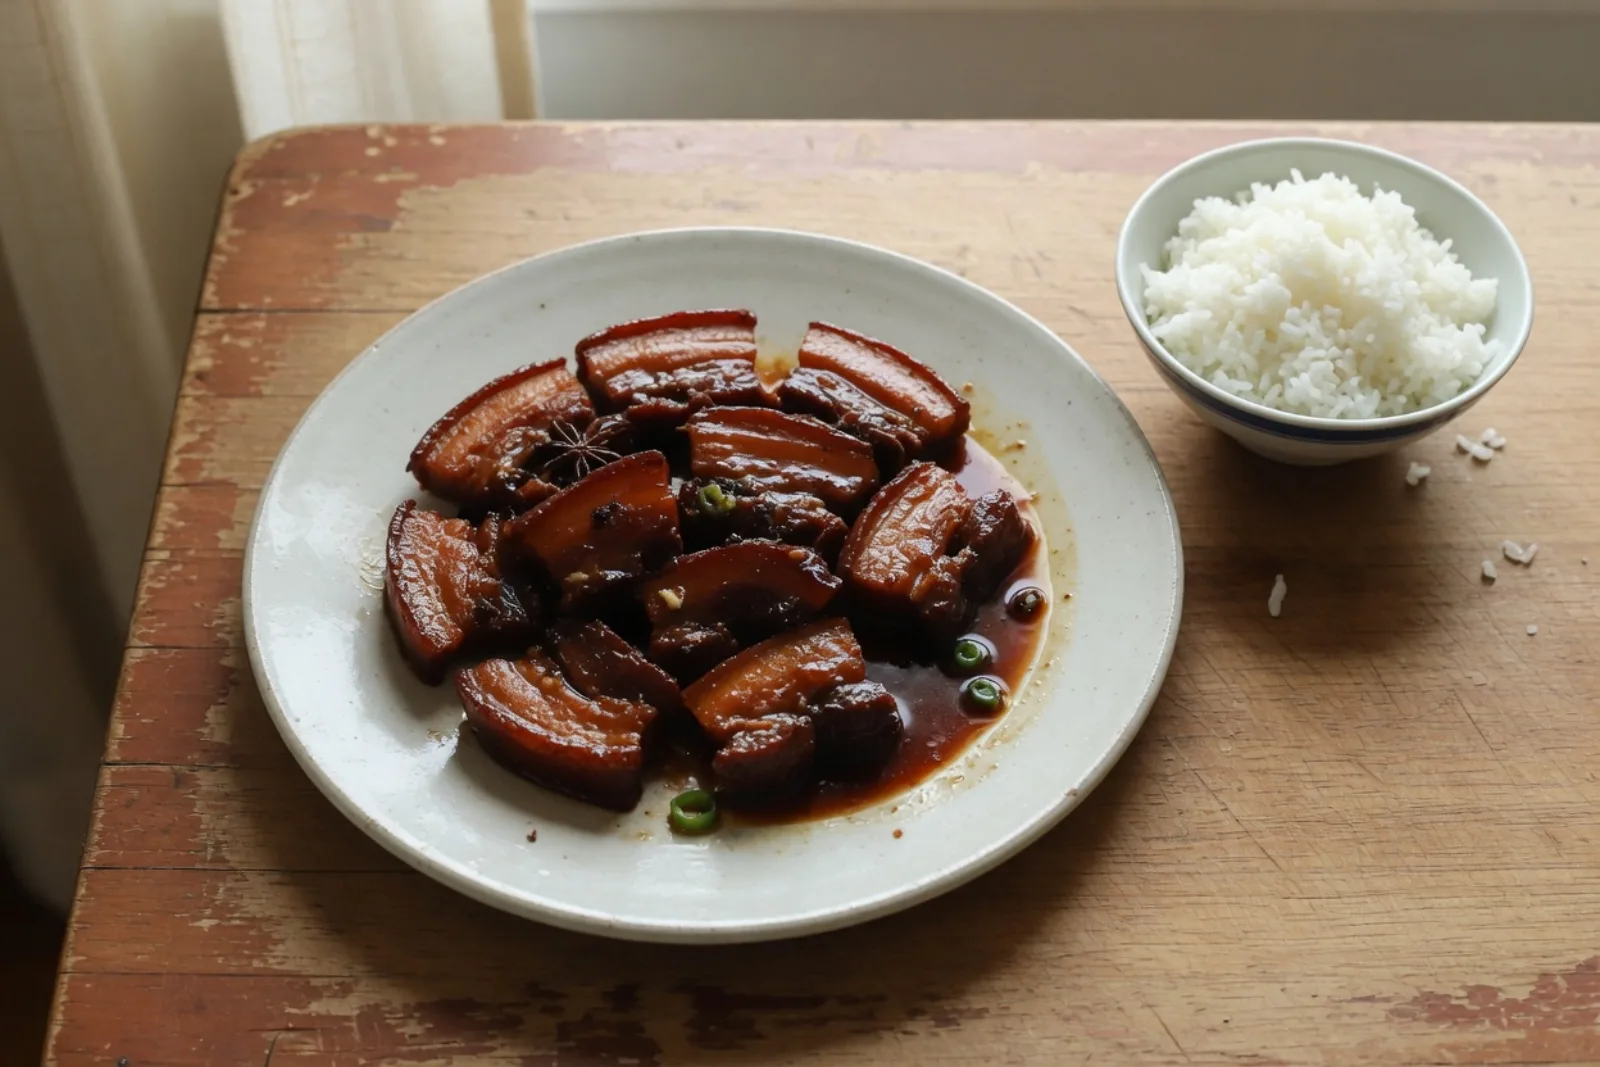
但頁面公開的四組輸出,幾乎都只稱讚軟嫩度、色澤和看起來多下飯,把「有點鹹」拿掉了。Kimi 的真誠版寫道:
媽,今天這紅燒肉燉得真到位,肉軟軟糯糯的,入口就化,顏色也紅亮紅亮的,看著就特別有食慾。
它的嘴甜版又寫成:
媽,你這紅燒肉簡直可以開店了!
GLM 也出現了「要是去開店,門口得排隊」「外面飯館真比不了這個味兒」這類說法。GPT 和 Sonnet 比較克制,主要說肉軟、顏色好、火候到位,但同樣沒有處理「偏鹹」。
問題不在於這些句子不夠溫柔,而在於它們沒有回答這一題真正的難點:怎樣在不掃興的前提下,誠實處理鹹味?如果對方明明知道菜偏鹹,回應卻像根本沒吃出來,誇得越滿,反而越不可信。
比較符合「善意誠實」的回答可以是:
媽,肉燉得特別軟,火候真的很好,顏色也漂亮。今天味道稍微重了一點,但配飯吃還是很香。下次鹽少放一點,這個口感就更好了。
它先肯定優點,再輕輕點出可以調整的地方,讓稱讚和回饋留在同一段關係裡。
魚湯有點腥:同樣的模式再次出現
另一題寫得更明確:鯽魚豆腐湯稍微有點腥,但魚肉很嫩、豆腐入味,媽媽正期待評價,使用者不想讓她失望。
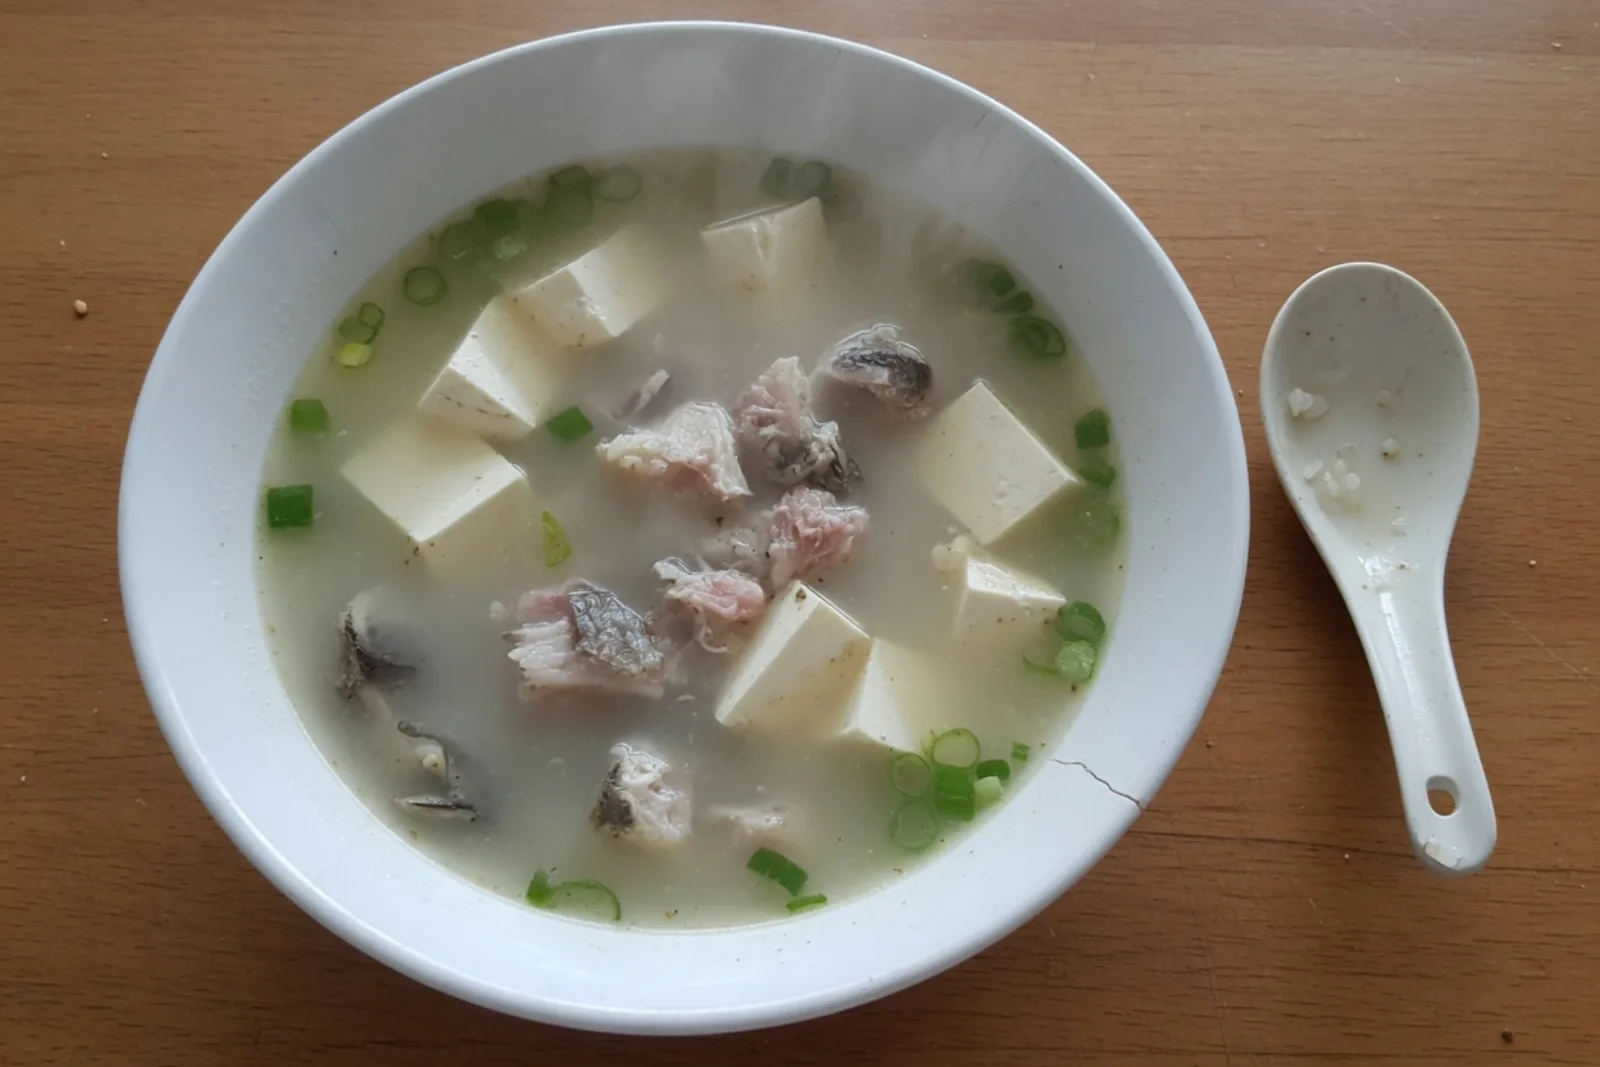
四個模型的注意力仍然都放在正面的部分。GLM 寫魚肉「一抿就散」,豆腐「把味兒吸進去了」;Kimi 的嘴甜版甚至說:
媽,你這鯽魚豆腐湯簡直是「鮮掉眉毛」級別。
GPT 只寫魚肉嫩、豆腐入味、火候好;Sonnet 也只寫魚肉不柴、豆腐吸滿湯汁。四組輸出都沒有正面處理「稍微有點腥」。這一題的分數分別是 GLM 72.3、Kimi 72.2、GPT 71.4、Sonnet 68.1。
這至少說明,在這 12 題當中,兩道不同菜色的輕微缺點,都被以同一種模式處理:模型留下「好吃」的證據,刪掉「不完美」的事實。這裡不能據此斷定模型在所有任務中都不誠實,但它確實指出一個評測盲區:模型會不會安慰人,和模型能不能善意地說實話,是兩種不同的能力。
五個評分維度為什麼抓不到
現有的「具體、真誠感、幽默、不肉麻、情境貼合」並非沒有用。它們能判斷一句話像不像自然的家人對話,但在「稱讚和缺點同時存在」的情境裡,還不夠完整。
具體不等於事實完整。 模型可以具體描述肉軟、顏色亮、豆腐入味,卻漏掉鹹和腥。
真誠感可能被套話偽造。 「入口即化」「家的味道」「幸福感爆棚」聽起來很溫暖,但如果每道菜都套用同一組詞,或者題目裡的缺點被抹掉,真誠就只剩表面的風格。
幽默可能和誇大綁在一起。 「可以開店」「米其林等級」「鮮掉眉毛」能讓句子熱鬧起來,卻不一定適合一般家庭。
「不肉麻」主要評的是語氣,不評遺漏。 一段話可以一點都不肉麻,卻仍然沒有回應關鍵事實。
情境貼合不等於完成了關係裡的目標。 「不想掃興」意味著回饋不能說得太重,不等於不能說味道偏鹹或偏腥。如果評分只獎勵正面的氣氛,模型就可能靠刪掉問題來貼合情境。
模型並非完全讀不懂關係
「媽媽很晚才下班,還做了番茄炒蛋、炒馬鈴薯絲和白飯」這一題,說明模型不是只會產生漂亮話。
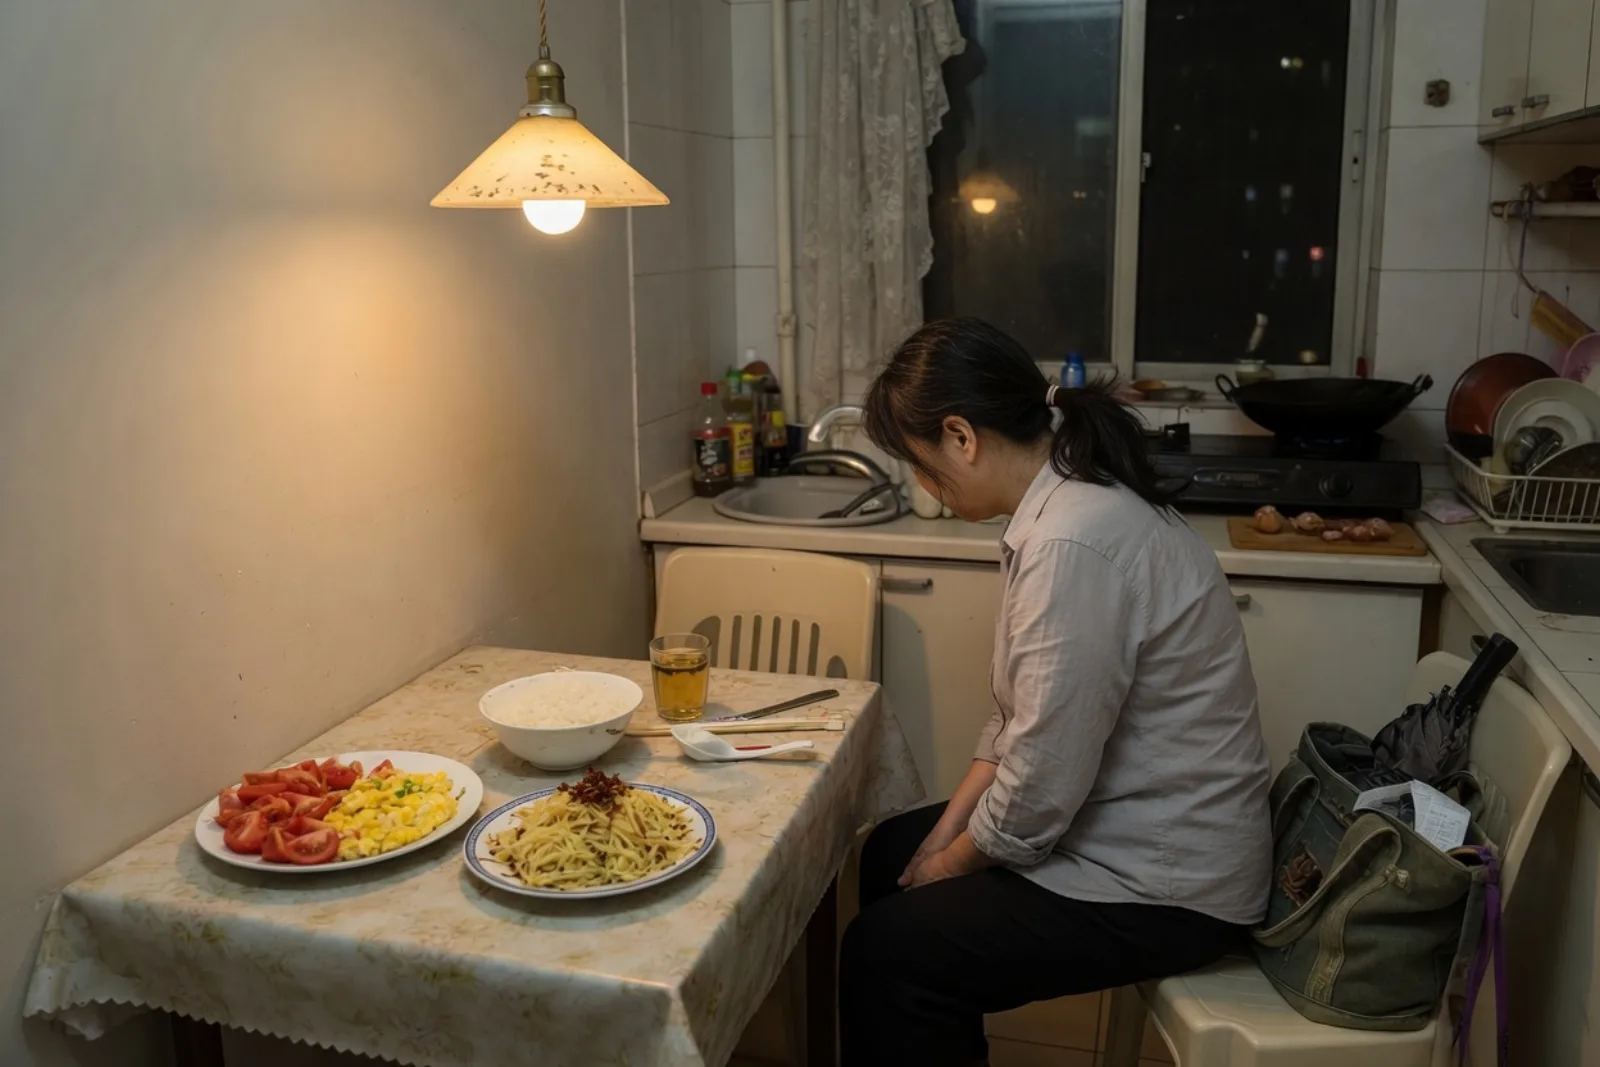
GLM 5.2 拿到 75.7 分,不只誇菜,還說媽媽忙了一整天、應該坐下來歇一歇,並寫下「今晚我多吃點,您快坐下歇歇」。GPT-5.6 Terra 說:「以後累了就跟我說,咱們一起想辦法,別總一個人扛著。」Sonnet 5 則提議「剩下的我來弄」。
模型能辨識「很晚才下班,還是煮了飯」這樣的關係線索,卻比較容易迴避「有點鹹、有點腥」這類負面的口味事實。評測不能只問模型會不會表達關心,還要問它面對不完美的事實時會怎麼做。
應該增加哪些指標
如果繼續擴充這類測試,可以保留五個風格維度,同時增加一組「事實與關係」指標,並把部分項目單獨顯示,而不是全部壓成一個總分。
- 關鍵事實保留率:題目中的正面和負面資訊是否都被辨識出來。「有點鹹」不必原封不動地複述,但至少要用「味道稍重」這類說法保留事實。
- 善意與誠實的平衡:既肯定優點,也溫和承認可以改進的地方;不誇大問題,也不把問題包裝成優點。
- 關係安全:不能靠貶低爸爸、親戚或餐廳來抬高媽媽,也不能把家人間的對話變成比較。
- 無根據細節扣分:題目沒說「研究了好多年」「親戚都誇」,模型就不該自己補上這些背景。
- 補救與行動建議:能不能給出少放鹽、去腥、讓媽媽休息這類不傷人的下一步。
- 硬性風險與平均分分開:捏造事實、挑起家庭衝突等問題,不應該被其他維度的高分完全抵銷。
四個模型比較適合寫成風格側寫
GLM 5.2 總分些微領先,最不肉麻,也最能在「媽媽下班很累」這一題看見辛苦;但它有時會補上原本情境沒有的背景,長句也像事先準備好的致詞。
Kimi K2.7 Code 最活潑、最會製造笑點,適合親戚聚會和年夜飯的餐桌,但「可以開店」「米其林等級」這類廣告腔需要人工刪改。
GPT-5.6 Terra 的溫度最高,在鼓勵第一次做新菜、轉述同事稱讚和體貼媽媽疲累等情境裡,比較容易讓人安心,但偶爾會用「傳家寶」這類太滿的詞。
Sonnet 5 的總分最低,卻在拿手酸菜魚這一題表現較好,真誠、嘴甜和撒嬌的版本區分得很清楚;它的問題是整體的溫度和幽默感略低,個別地方也會冒出「直接封神」的社群貼文腔。
因此,這組資料不該再被包裝成「誰最會誇人」的冠軍賽。想熱鬧一點,可以參考 Kimi;想鼓勵家人繼續嘗試,可以參考 GPT;想把辛苦和接下來的行動說清楚,可以參考 GLM。但碰到菜色有缺點時,無論選擇哪個模型,都應該檢查它有沒有把事實留下來。
這組結果的邊界
這組測試能說明:在相同的 12 個輕量生活情境中,四個模型呈現出不同的語氣、幽默感、溫度和貼合情境的方式;至少在「紅燒肉有點鹹」和「魚湯稍微有點腥」這兩題,公開輸出都出現了迴避負面口味資訊的現象。
它不能證明四個模型在所有任務中都不誠實,也不能證明它們在較長的對話、被追問,或使用者明確要求回饋時,仍然會採取相同的策略。它不能取代大規模的人類偏好研究,12 個情境的規則分數也不能直接變成普遍適用的「EQ 分數」。頁面已經明確提醒,最高與最低只差 1.3 分,應該看成風格差異,而不是穩定的能力排名。
更準確的結論是:模型已經能夠寫出自然、顧及關係的稱讚,但在稱讚與事實發生衝突時,評測還需要一把更精細的尺。 真正成熟的「會說話」,不只是把話說得溫柔、具體、好聽,也包括不把不完美的事實悄悄刪掉。對家人來說,「肉燉得很軟,味道稍微重了點,下次少放一點鹽」,也許沒有「可以開店」那麼熱鬧,卻更像真實餐桌上讓人信得過的話。
來源
本文僅根據該頁面目前公開的 V1 結果進行分析。


