很多人让模型处理职场冲突时,问的是:“老板这样说,我应该怎么回?”
这看起来像一道润色题,实际上更接近一个多目标约束问题。回复不能只做到礼貌,还要同时完成几件互相牵制的事:不能默认接受不准确的指责,不能把现场变成对抗,不能把自己该承担的部分全部推开,也不能把别人的责任一股脑揽到自己身上。与此同时,回复还要留下必要的事实、时间和下一步,让事情继续往前走。
Folkbench 的“老板阴阳怪气,这题谁会?”测试,测的正是这一层能力。它没有让模型泛泛回答“遇到职场 PUA 怎么办”,而是给出 12 个带有具体背景、权力关系和交付约束的场景,要求模型写出普通人真的敢发、又不至于把事情闹大的回复。
这不是“怎么回怼老板”的测试
12 个场景覆盖了几类常见压力:群里被暗示“最近挺轻松”、公开场合被问“是不是不想干了”、项目结果不好后被说“应该早想到”、需求变化没有同步却被要求主动跟进、上游缺资料导致方案空缺、贡献被老板轻描淡写、客户面前被说“不太熟”、绩效只得到“主动性不足”的模糊评价、周末被要求“顺手看一下”、临时改优先级后的书面留痕,以及“年轻人多吃点苦”背后的排期协商。
测试怎么进行
四个模型看到的是完全相同的当前 V1 场景和输出要求,页面只收录 promptHash 匹配的 48 条结果,也就是 12 道题分别得到四个模型的回答。
规则评分从五个角度判断:
- 能不能直接发;
- 有没有保护自己的事实和责任边界;
- 会不会把事情进一步闹大;
- 有没有分寸感;
- 下一步是否清楚。
页面同时记录规则提示和硬性风险。规则分只用于这 12 道同题结果的横向比较,不代表模型普遍具备某种职场能力,也不是劳动法律建议。
结果:平均分接近,能力画像不同
| 模型 | 规则平均分 | 得分居首题数(含并列) | 硬性风险 | 规则提示 |
|---|---|---|---|---|
| GPT-5.6 Sol | 74.3 | 5/12 | 0 | 0 |
| Kimi K2.7 Code | 72.5 | 4/12 | 0 | 1 |
| Opus 4.8 | 72.2 | 2/12 | 0 | 5 |
| GLM 5.2 | 70.2 | 2/12 | 0 | 6 |
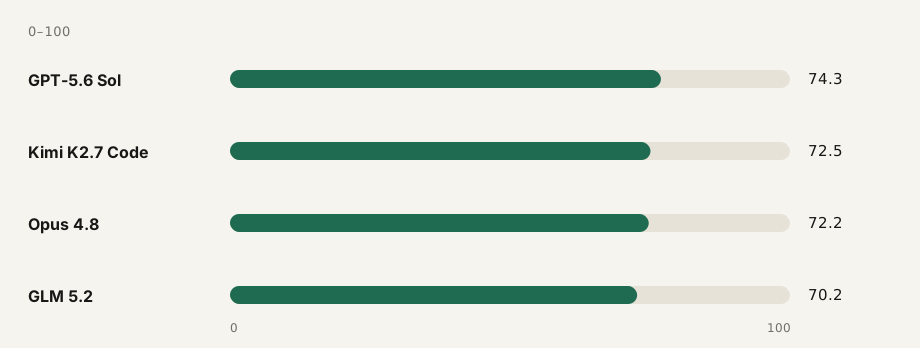
GPT-5.6 Sol 只比第二名高 1.8 分,但页面显示它在“直接可发”、边界和下一步三项上都排在四个模型第一,尤其适合需要把优先级、时间点和责任关系说清楚的场景。
Kimi K2.7 Code 的场景识别分为 80.7,是四个模型最高;但“下一步”只有 58.3 分,有时已经准确发现问题,却没有把负责人、时间或确认动作钉住。
Opus 4.8 的降温处理分为 70.3,略高于其他模型,在“周末顺手看一下”和“年轻人多吃点苦”这类边界题中表现突出。不过页面也记录了 4 题出现模板式开头、1 题留下未替换占位符,复制前必须通读。
GLM 5.2 在资料缺失和群里认错等题中擅长列事实、缺口和后续动作,但 6 题带有“可以这样回”一类的模板提示,整体模板感更重。
四个场景,四种职场难题
“你最近看起来挺轻松”:不能接下错误标签
用户正在修改周五交给客户的方案,没有及时回复群里一条非紧急消息,老板说“你最近看起来挺轻松啊”。
Sol 的回复没有争辩“我一点也不轻松”,而是说明自己正在集中修改方案,结构和核心数据已经核完,预计 17:00 发第一版,并补充如果有更紧急的事项可以调整优先级。
这段话先解释未及时回复的客观原因,再用进度和交付时间证明工作正在推进,最后把对话从“你是不是偷懒”转回“现在什么事情更优先”。它没有接受“轻松”这个隐含判断,也没有在群里公开拆穿老板的讽刺。
“主动性不足”:把模糊标签变成行为标准
绩效面谈里,老板只说“你态度没问题,就是主动性还差点”,绩效表上也只有“主动性不足”,下个考核周期是 6 周。
Kimi 没有马上反驳,也没有空泛地说“我会努力改进”,而是追问“主动性”具体指什么:是遇到问题先自己想办法,还是主动同步;是跨部门协作不够积极,还是没有主动争取新任务。随后它继续追问下个周期的合格标准和优秀标准,希望把评价落实到每周或每个项目节点。
这把一个很难反驳的性格标签,转换成可以举例、观察和复盘的行为标准。Sol 的版本则进一步提出每周汇报风险、发现问题时给出备选方案、第 3 周中期回顾等动作,说明“识别问题”和“推进问题”是两种能力。
“方案怎么还这么空”:责任边界要靠事实建立
活动方案缺少上游确认的活动范围、最近 30 天转化数据和预算上限,但目录、流程和不依赖数据的通用部分已经完成,资料清单也发过两次。老板却在群里说:“方案怎么还这么空?你推进得不够积极吧。”
GLM 在这道题得到 81.4 分,是四个模型最高。它先写已完成的部分,再列出三项缺口,说明此前的发送和提醒记录,最后给出“明天 17:00 前反馈、资料到位后两个工作日内补齐”的计划;如果正式资料暂时给不了,也可以先提供范围或暂定值,方案按假设推进。
这类回复没有把“资料没给”写成情绪控诉,而是把它变成一个可以被项目成员共同处理的依赖项。责任边界不是靠一句“这不是我的错”建立的,而是靠完成记录、依赖关系和时间节点建立的。
“年轻人多吃点苦”:把价值判断还原成排期问题
用户同时负责本周五上线的会员结算、下周二交付的运营报表,以及没有外部依赖的后台样式优化。老板说“年轻人多吃点苦是好事”,用户希望争取合理排期,但不想把话说绝。
Opus 在这道题得到 82.1 分,为全场单题最高。它没有对“吃苦”展开价值争论,而是把三项工作按截止时间列出来:会员结算第一优先,运营报表第二优先,后台样式优化顺延一周;如果样式优化也有硬性时间要求,再重新调整。
有效的回复不是反驳这句话,而是把“你愿不愿意吃苦”换成“有限时间里,哪些交付最值得优先保证”。
四个模型分别像什么
GPT-5.6 Sol:稳定的交付型回复。 它常把内容落到事实、时间和下一步,留痕、客户现场和排期确认较稳。页面也提醒,Sol 的回复有时偏长,绩效和责任争议场景仍需要用户补上更明确的标准、负责人和截止时间。
Kimi K2.7 Code:读得懂场景,但要检查闭环。 它擅长读出一句话背后的关系和压力,尤其适合处理绩效面谈、会议追问等微妙场景。使用时要额外检查:负责人、时间点、确认动作是否都写清楚。
Opus 4.8:会降温,但复制前需要清理。 它善于给对方台阶,处理拒绝周末工作、争取排期等边界问题。不过表达更长,模板痕迹更明显,使用时应删掉解释、括号和占位符,再确认消息是否符合真实关系。
GLM 5.2:清单化推进强,但要去掉讲解腔。 它很会拆解“已完成—缺口—责任—下一步”,适合项目推进和延期复盘。问题是答案与教学说明常常混在一起,最好明确要求“只输出最终可发送文本”。
普通人可以复用的四步框架
无论使用哪个模型,都可以按下面的顺序组织职场回复:
- 确认事实:写清正在做什么、已经完成什么、变化何时发生;
- 承认可控部分:如果排期没留缓冲、风险提示太晚,就承认具体行为,不笼统认领全部责任;
- 把边界写成安排:说明依赖项、优先级、受影响交付和新的时间点,而不是只说“这不是我的责任”;
- 给出下一步并请求确认:明确谁做什么、什么时候完成、条件变化后如何调整。
可以把它压缩成一句话:
确认事实 → 说明约束 → 提出安排 → 请求确认。
“复制粘贴安全”也应该成为评测指标
模型输出即使判断正确,也可能不适合直接发送。真正的风险不只在事实错误或语气不当,也在于消息可能带着“可以这样回”“下面是原因”、没有替换的姓名、括号说明,甚至一整段只应该给用户看的分析。
因此,现实任务评测至少要区分两件事:模型有没有提出正确的沟通策略,以及模型有没有把最终消息和解释清楚分开。前者是建议质量,后者是复制粘贴安全性。Folkbench 把“能不能直接发”列为独立评分维度,正是因为用户需要的不只是听起来聪明的答案,而是一条可控、可修改、可发送的工作文本。
这组结果的边界
这组结果能说明,在当前 V1 的 12 个具体场景中,四个模型对事实、边界、关系和下一步的处理方式存在可观察差异:Sol 更稳定地给出可交付回复,Kimi 更擅长读取场景,Opus 更会降温和协商边界,GLM 更善于清单化推进。
它不能说明某个模型在所有职场沟通中都更好,也不能说明某个模型“更懂人情世故”。样本量、题面、模型版本、输出要求和评分规则都会影响结果。Sol 只比 Kimi 高 1.8 分,不支持“全面碾压”的结论。页面的规则分也不是劳动法律意见,涉及绩效、纪律、薪酬或劳动争议的真实决定,不能只依赖模型生成的一条消息。
“老板阴阳怪气”这个标题容易让人想到回怼技巧,但这组测试真正测出的,是另一种更难的能力:在不对等的关系里,既不把自己交给模糊标签,也不把沟通推向公开冲突,还能让事情留下记录、得到确认并继续推进。