一个模型能写出一份步骤完整、语气耐心的煎饼果子教程,不等于新手真的能照着做成功。
真正的家庭厨房有很多变量:锅的尺寸和材质不同,面糊可能太稠或太稀,火候会在摊饼、下蛋、翻面之间变化,薄脆不一定买得到,早上还可能只有 20 分钟。第一次失败之后,用户需要的也不是另一份漂亮菜谱,而是有人能判断“刚才为什么会破”,并告诉他这一锅还能不能救。
所以,这次 煎饼果子制作评测 真正测的,不是模型会不会背一份菜谱,而是它能不能把知识变成家庭厨房里可以执行、可以调整、出了问题还能继续走下去的方案。
先看结论:平均分之外,差异藏在失败和风险里
这轮测试设置了 12 个家庭厨房场景,四个模型一共留下 48 条 promptHash 匹配结果。页面的规则评分从五个角度观察回答:步骤能不能照着做、有没有厨房常识、会不会处理翻车、表达是否清楚,以及有没有把自己写成一个过度自信的“老师傅”。
页面公布的综合分如下:
| 模型 | 综合分 | 12 题中得分居首(含并列) | 页面标记的规则提示或硬性风险 |
|---|---|---|---|
| Sonnet 5 | 80.4 | 6 题 | 无 |
| GLM 5.2 | 79.3 | 5 题 | 1 项规则提示 |
| Kimi K2.7 Code | 77.6 | 3 题 | 1 项规则提示、1 项硬性风险 |
| GPT-5.6 Terra | 75.6 | 0 题 | 无 |
Sonnet 5 以 80.4 分领先,整体上更像一份可以交给新手的教程:首次制作、锅具控火和 20 分钟早餐等场景都比较稳。GLM 5.2 只落后 1.1 分,操作步骤分却达到 90 分,是全场最高。Kimi K2.7 Code 的综合分更低,但在“摊破了怎么救”这类需要临场补救的场景里表现最好。GPT-5.6 Terra 的首次完整教程得分达到 84.2,却在面糊比例、电饼铛控火和失败诊断题上出现明显短板。
表面上看,这是一张四个模型的成绩单。更值得关注的,其实是它把一个常被忽略的事实摆了出来:可执行性不是一个单一能力,模型可能擅长把步骤写清楚,却不擅长诊断失败;也可能很会补救,却在安全边界上留下不能忽略的问题。
一、家庭厨房不是菜谱展示台
如果只问“怎么做煎饼果子”,模型很容易给出一份看起来完整的标准答案:准备面粉、调面糊、预热锅、摊饼、打蛋、撒葱、刷酱、放薄脆,然后卷起来。
这份答案在文字层面可能没有明显错误,但它没有回答新手真正会遇到的几个问题:
- 家里只有 26 厘米不粘锅,没有摊饼刮板,汤勺和锅铲够不够用?
- 面糊到底应该稀到什么程度?为什么同样的水粉比例,有人摊出来很厚,有人一铲就破?
- 没有薄脆时,馄饨皮、油条、薯片和普通薄饼分别会带来什么结果?
- 平底锅和电饼铛的火候怎么判断?鸡蛋下锅后,什么时候可以卷?
- 饼已经破了,蛋还没有完全凝固,应该继续摊、补一勺面糊,还是直接重来?
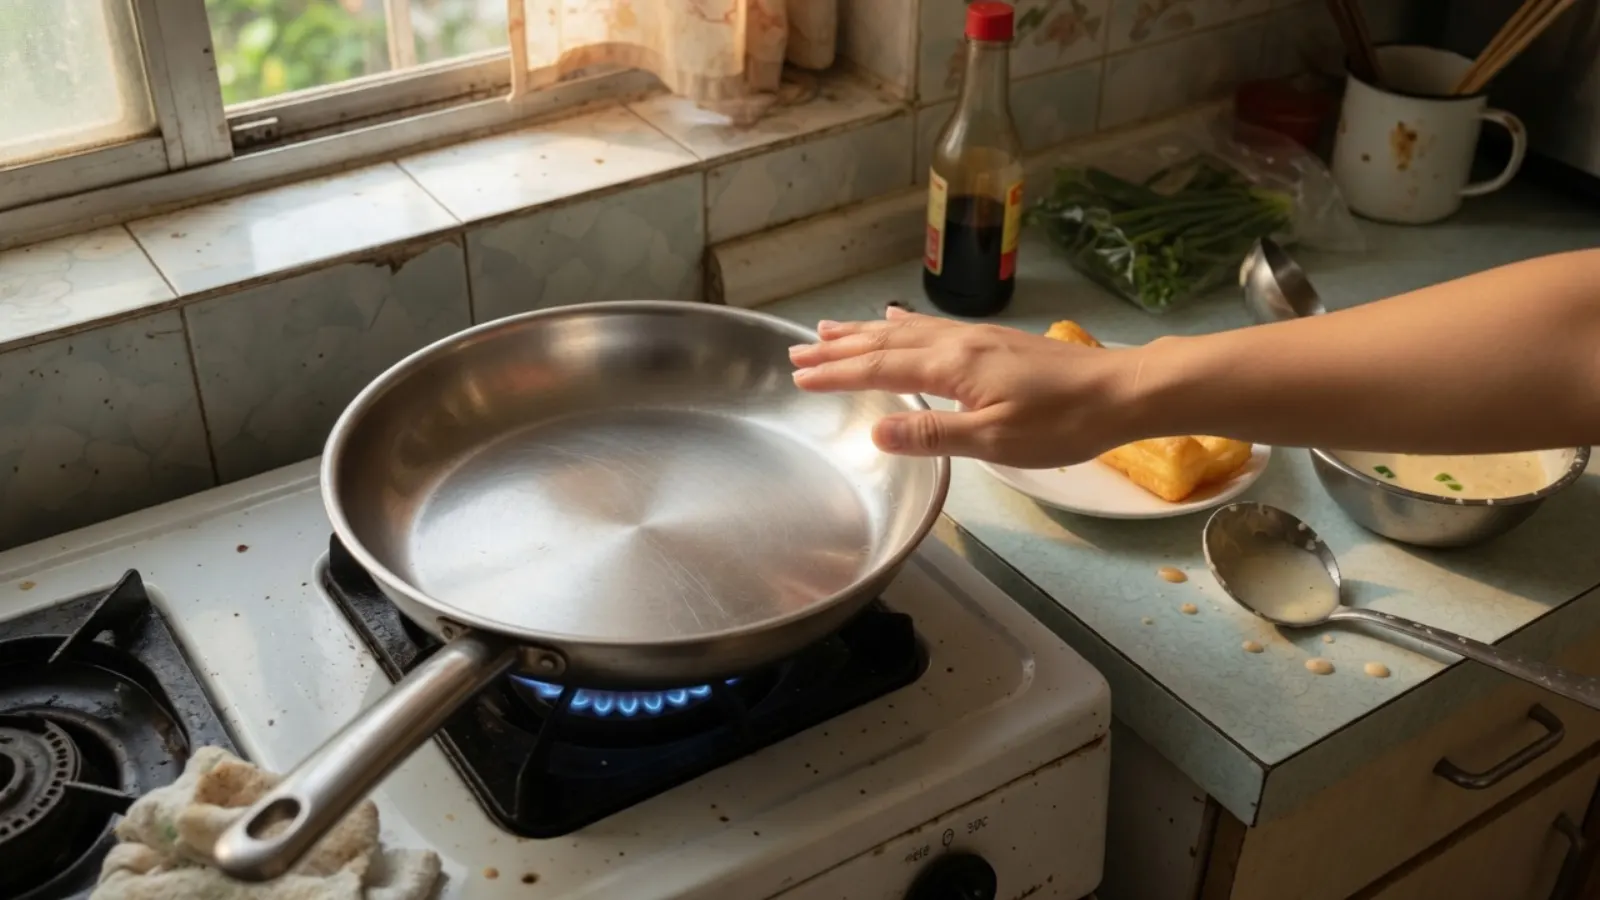
- 只有不锈钢锅时,怎样降低粘锅概率?
- 调多的面糊和已经刷酱夹火腿的熟饼,第二天还能不能吃?
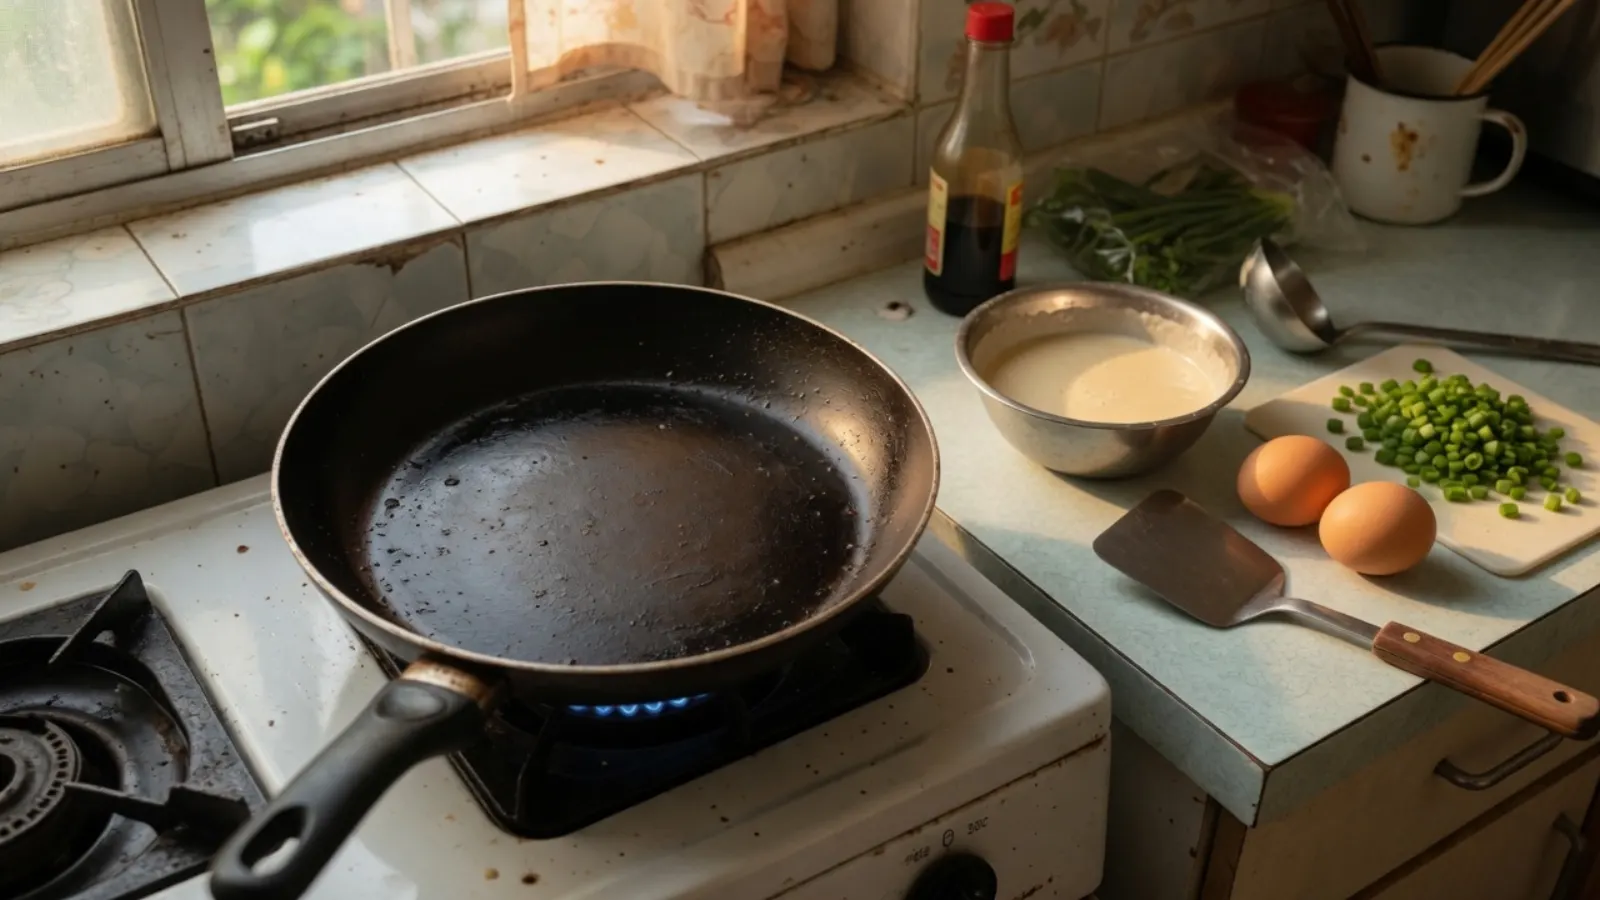
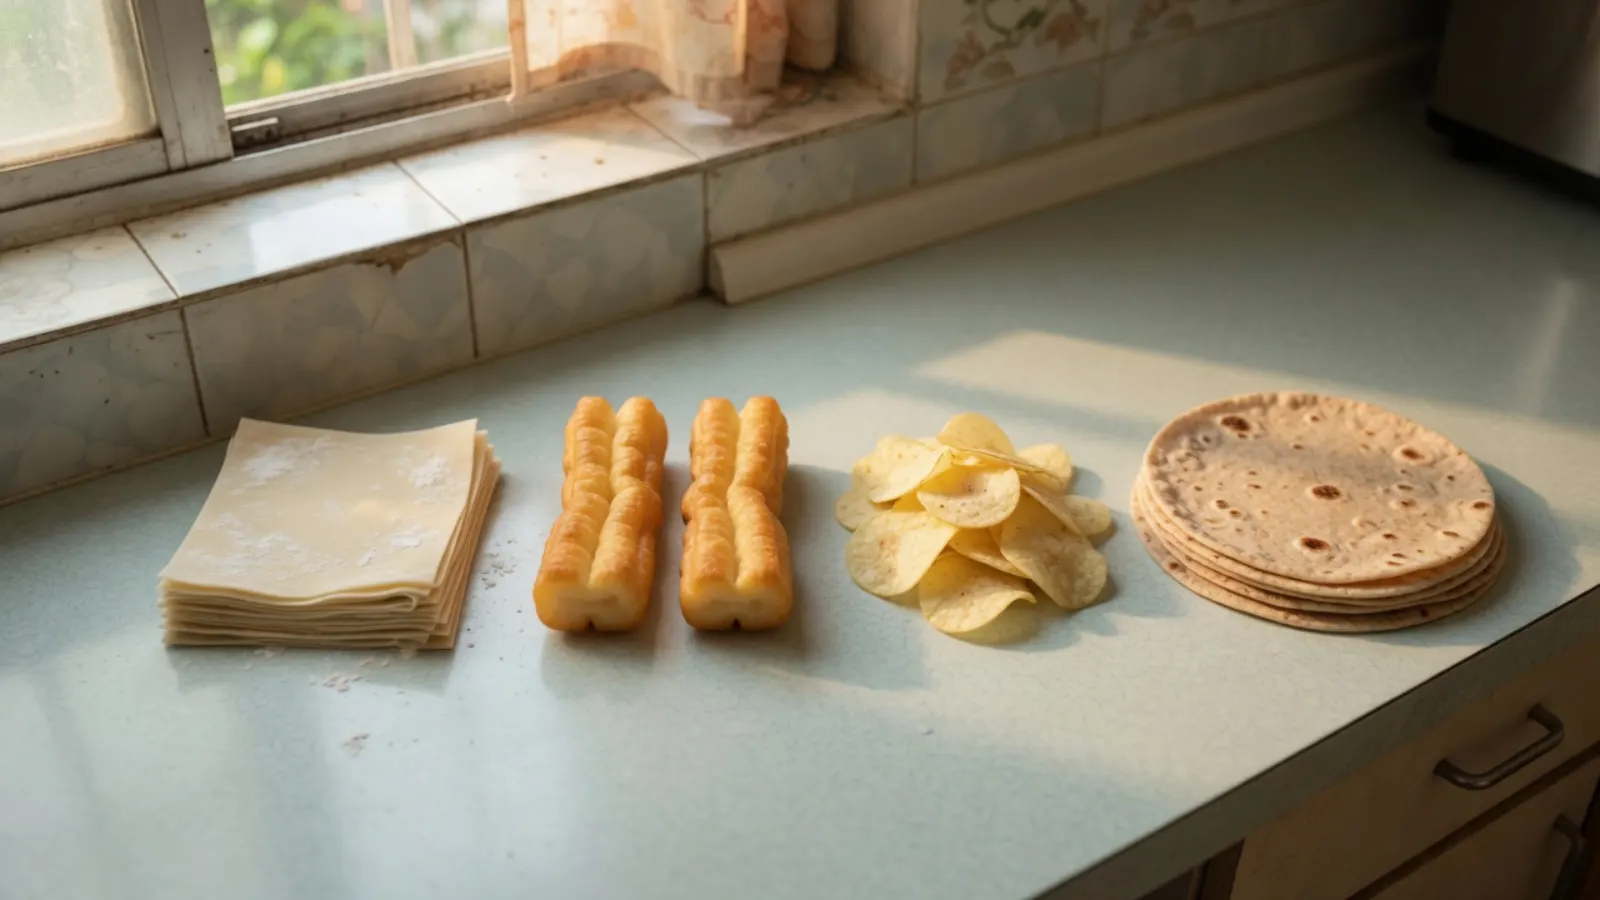
这类问题要求模型同时处理材料、工具、时间、顺序、状态变化和风险。它不是把知识从记忆里取出来,而是要根据当前条件重新组织行动。
这也是为什么页面没有只设置“请写一份煎饼果子食谱”,而是拆成了 12 个场景:新手第一次做、面糊比例、薄脆替代、不同锅具控火、摊破补救、材料不足、儿童少油少辣版、20 分钟早餐、失败诊断、三人份节奏、不锈钢锅和隔夜保存。每道题都在逼模型回答一个更接近真实生活的追问:在条件不理想时,你还能不能把下一步说清楚?
二、最重要的分界线:详细不等于可靠
这轮结果里,GLM 5.2 是一个很好的例子。它的操作步骤分达到 90 分,说明它很会把流程拆开,也很会根据“材料少”“一次做三个人的量”“面糊和熟饼怎么保存”等条件给出具体建议。对于一个只看文字完整度的人来说,这类回答很容易获得高评价。
但页面同时指出,它在不锈钢锅题里建议“烧到冒青烟”,并重复养锅。这种高温预热方式对普通家庭并不温和。回答里的动作越具体,用户越可能直接照做;具体建议如果没有和使用场景匹配,就会把“看起来专业”变成实际风险。
Kimi K2.7 Code 的情况更能说明平均分为什么不够用。它在“摊破了怎么救”一题得分最高,面对一锅已经破掉、蛋还没有完全凝固的半成品时,给出了很有操作感的补救步骤。它在面糊和三人份场景里也提供了不错的细节。
但在“早上 20 分钟搞定”这一题里,页面标记了一个不能忽略的食品安全硬风险:回答暗示鸡蛋可以提前取出后在室温放置。无论其他题写得多好,这一项都应该单独呈现,不能被“补救题得分最高”抵消。
这不是在说 Kimi K2.7 Code 的所有建议都不可靠,也不是在给它贴上“食品安全能力差”的永久标签。准确的说法是:在这一轮、这一道题、这一个具体建议里,出现了页面规则定义的硬风险。 对用户而言,这条信息的优先级高于几分之差的综合排名。
三、四个模型更像四种不同的厨房助手
Sonnet 5:比较稳的第一次制作助手
Sonnet 5 的优势不是某一道题特别惊艳,而是 12 道题里整体比较均衡。它在首次制作、锅具控火和 20 分钟早餐等场景保持领先,并且没有触发页面记录的规则提示或硬性风险。
这类模型适合用户还没有形成自己的厨房判断时使用:先让它把流程、顺序和判断节点写出来,再根据自己手头的锅具和材料删减。它的限制也很明确:保存和失败诊断题并不是最强,教程信息量较大,真正下厨前仍然需要把长段解释压缩成几步可以看着执行的步骤卡。
GLM 5.2:流程拆解强,但要检查火候建议
GLM 5.2 很擅长把复杂条件整理成清单。对于材料不足、多人份和保存问题,它常常会把缺什么、先做什么、什么时候处理、如何安排时间说得比较完整。
它更像一个善于整理流程的助手。使用它时,用户应该重点复核高温、预热、油量和保存相关的动作,不要因为回答写得很像专业教程,就跳过对具体器具和家庭环境的判断。
Kimi K2.7 Code:补救能力突出,安全建议要逐条复核
Kimi K2.7 Code 的优势集中在“已经出问题了怎么办”。它能读出锅里现在处于什么状态,并提供比“重新来一遍”更具体的补救路径。这是很多模型容易忽略的地方,因为补救题要求模型接受一个不完美的中间状态,而不是重新讲标准流程。
同时,它在隔夜准备场景中的硬风险说明:模型很会给出动作,并不等于这些动作都经过了安全边界的筛选。涉及食物保存、儿童饮食和隔夜处理时,用户需要把安全建议当成独立检查项。
GPT-5.6 Terra:基础教程不错,排错能力不够稳定
GPT-5.6 Terra 的首次完整教程得分达到 84.2,比例、锅温和基础流程写得比较完整。对于“我还没有开始做,先给我一份从头到尾的流程”这种需求,它的起点不差。
但在面糊比例、电饼铛控火和失败诊断题里,它的表现明显落后。这说明它能写出一份看起来完整的入门说明,却不一定能在用户已经失败之后,准确定位是哪一个变量出了问题。
这也是“会写教程”和“会带人完成任务”的差异:前者只需要组织一条理想路径,后者还要理解偏离理想路径之后发生了什么。
四、为什么硬风险不能被平均分隐藏
传统的总分有一个很自然的诱惑:把每道题的分数加起来,再选出一个最高分。但家庭任务里,不同错误的代价并不相同。
“这句话有点啰嗦”与“这个保存建议可能带来食品安全问题”,不应该在同一条加减法里相互抵消;“没有告诉用户如何补救”与“给出一个过于激进的高温动作”,也不应该只被当作两个普通扣分项。
这轮测试已经在做一件很重要的事:页面除了公布规则平均分,也单独标出规则提示和硬性风险。这个结构值得保留,并且可以继续扩展成三层结果:
- 任务完成分:用户能不能按照回答完成目标;
- 过程质量分:步骤、解释、适配和补救是否清楚;
- 不可抵消的风险标签:是否出现食品安全、危险操作或明显违反题目约束的建议。
对真实用户来说,第三层往往比第一层更先决定“我敢不敢照着做”。
五、这轮测试对普通用户有什么用?
它没有给出一个在所有厨房问题上都最好的模型,而是提供了更实际的选择方式。
- 想第一次尝试、希望少走弯路:优先看整体稳定、没有触发风险的回答。
- 手头材料不全:重点看模型是否会根据现有材料重新设计,而不是坚持标准配方。
- 已经摊破或粘锅:重点看失败诊断和补救步骤,不要只看基础教程写得是否漂亮。
- 涉及儿童、隔夜保存或高温操作:先检查风险标签,再看总分和表达质量。
- 要在 20 分钟内完成:看模型是否安排了前一晚可以准备的部分,以及它对保存条件的说明是否明确。
更稳妥的使用方式,是把模型回答当作“第一版操作方案”,继续追问三个问题:
- 我的锅具和材料与标准条件有什么不同?
- 如果中途出现某个具体失败,哪一步应该停止或调整?
- 这条建议有没有涉及需要单独核查的食品安全问题?
模型越是写得具体,越值得检查这些问题。因为具体回答确实更容易执行,也更容易把一个错误动作包装成看似专业的指令。
六、把生活任务测好,不能只看“像不像正确答案”
煎饼果子这组题给 Folkbench 的启发,不是以后要继续增加更多菜谱,而是可以把“现实任务的可执行性”作为一个独立方向继续发展。
一项好的生活任务评测,至少应该提前写清楚四件事:
- 用户的起始条件是什么;
- 任务成功的最低标准是什么;
- 哪些错误可以通过补救弥补;
- 哪些风险一旦出现就必须单独标记。
评分标准也应该在看模型输出之前冻结。否则,看到某个模型说出一句很顺耳的话,才临时增加“表达自然”这一项;看到另一个模型给出一个危险建议,才临时把安全权重调高,最后会得到一张无法复查的成绩单。
这轮测试已经有一个很好的基础:统一场景、统一输出要求、匹配 promptHash、同时展示综合分和风险提示。下一步最值得继续完善的,是把平均表现、单题上限、失败类型和硬风险分开保存,让读者知道“模型总体表现如何”,也知道“它最可能在哪里让你失望”。
结语:真正有用的模型,要能陪你走过不顺利的那一步
写出一份完整菜谱,是语言组织能力;根据锅具、材料和时间调整方案,是条件理解能力;在饼已经破掉之后告诉用户怎么继续,是状态判断和错误恢复能力;面对隔夜保存问题时明确停下来,是安全边界能力。
这四件事叠在一起,才更接近普通人说的“这个模型真的有用”。
所以,这轮煎饼果子测试最值得留下的结论,不是 Sonnet 5 比 GPT-5.6 Terra 高多少分,也不是谁可以在所有家庭厨房问题上胜出,而是:一个现实任务的评测,必须让“能不能做成”“出了问题能不能救”和“有没有不能接受的风险”同时出现。
测试边界
本文依据 Folkbench 页面当前公布的 V1 场景和结果撰写。样本是 12 道家庭厨房题、48 条 promptHash 匹配结果,规则分只用于这组同题结果的横向比较。它不能替代食品安全专业意见,也不能据此推导模型在所有烹饪任务中的普遍能力。涉及保存、儿童饮食和高温操作时,用户仍应根据实际食材、器具和当地食品安全要求做独立判断。