
Les scores officiels de Claude Haiku 5.5 sont publiés. Placez-les à côté de ceux de Haiku 4.5, de GPT-6 Luna et de Sonnet 5.5 : la question qui mérite d’être posée n’est pas de savoir s’il remporte chaque épreuve, mais jusqu’où Haiku 5.5 a repoussé les limites de ce qu’un petit modèle sait faire.
Le modèle publié par Anthropic s’appelle Claude Haiku 5.5. Son ID de modèle est claude-haiku-5-5. Il est sorti le 7 octobre 2026.
Anthropic le positionne sans détour : Haiku 5.5 est son petit modèle le plus rapide, le moins cher et le plus performant, conçu pour les tâches à fort volume, à faible latence et sensibles au coût. Les usages types cités sont la classification, l’extraction d’informations, le résumé, la compression du contexte, les requêtes de base de données, l’utilisation du navigateur et le rôle de sous-agent pour Sonnet 5.5 ou Opus 5.5.
Cet article s’appuie uniquement sur les benchmarks, les prix et les informations produit publiés par Anthropic. Il ne présente pas ce bulletin comme une expérience indépendante. L’objectif est de replacer les chiffres dans leur contexte (type de tâche, prix, rôle du modèle) pour voir où Haiku 5.5 excelle vraiment, et quelles tâches il ne faut toujours pas lui confier.
En bref : Haiku 5.5 n’est plus un petit modèle cantonné aux tâches simples
Rassemblez les chiffres officiels et le profil de Haiku 5.5 apparaît clairement :
- par rapport à Haiku 4.5, il progresse nettement sur chacun des principaux benchmarks publiés par Anthropic ;
- sur les épreuves présentées côte à côte, il devance GPT-6 Luna ;
- en travail intellectuel, en utilisation de l’ordinateur et sur certaines tâches de raisonnement, il se rapproche déjà de Sonnet 5.5 ;
- en programmation agentique complexe, il reste nettement derrière Sonnet 5.5 ;
- son principal atout tient à la combinaison de la vitesse, du prix et d’un taux de réussite des tâches désormais suffisamment élevé.
Mieux vaut voir Haiku 5.5 comme une couche d’exécution dont les capacités ont fait un bond que comme un modèle qui remplacerait Sonnet 5.5 sur toute la ligne.
Les benchmarks officiels comparés
Anthropic a publié les chiffres suivants dans l’annonce de Haiku 5.5. Les colonnes GPT-6 Luna et Sonnet 5.5 proviennent du même tableau comparatif.
| Benchmark | Haiku 5.5 | Haiku 4.5 | GPT-6 Luna | Sonnet 5.5 |
|---|---|---|---|---|
| GDPval-AA v2.1 : travail intellectuel | 1620 | 735 | 1437 | 1840 |
| AA-Briefcase v1.1 : travail intellectuel | 1578 | 614 | 1336 | 1824 |
| OSWorld 2.1 : utilisation de l’ordinateur | 72,4 % | 15,7 % | 48,9 % | 83,9 % |
| Humanity's Last Exam : sans outils | 45,9 % | 10,2 % | — | 56,9 % |
| Humanity's Last Exam : avec outils | 57,4 % | 18,7 % | — | 64,5 % |
| Terminal-Bench 4.0 : programmation agentique | 39,2 % | 0,0 % | 16,4 % | 70,6 % |
| FrontierCode 1.1 : programmation agentique | 46,4 % | — | 42,4 % | 52,1 % |
| Chartography : raisonnement visuel | 46,4 % | 6,4 % | 29,1 % | 61,6 % |
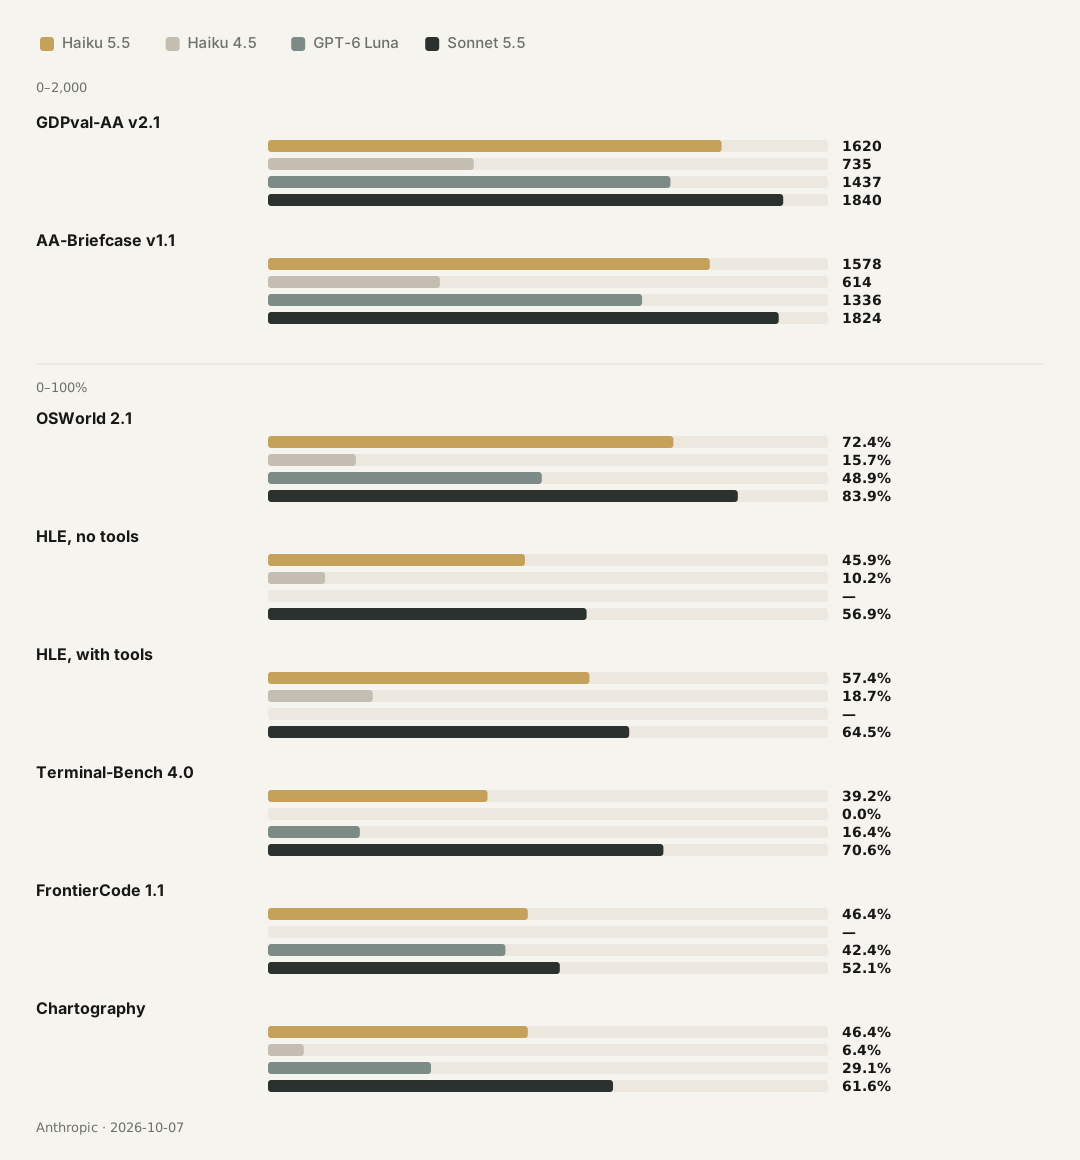
Ces chiffres ne se résument pas proprement à « Haiku 5.5 est deuxième ». Les benchmarks mesurent des capacités différentes. Le travail intellectuel s’intéresse à la qualité de ce qui est livré. OSWorld vérifie si le modèle sait piloter un vrai ordinateur. Terminal-Bench regarde s’il peut mener à bien un travail professionnel en plusieurs étapes dans un terminal. Humanity’s Last Exam penche vers les connaissances pointues et le raisonnement difficile.
Un tel écart d’une tâche à l’autre fait lui-même partie du résultat.
Premier changement : Haiku 5.5 a distancé la génération précédente
Il suffit de comparer Haiku 4.5 et Haiku 5.5 pour mesurer l’ampleur de la mise à niveau.
GDPval-AA v2.1 passe de 735 à 1620, soit environ 2,2 fois la génération précédente. AA-Briefcase passe de 614 à 1578, environ 2,6 fois. OSWorld passe de 15,7 % à 72,4 %. Terminal-Bench passe de 0,0 % à 39,2 %.
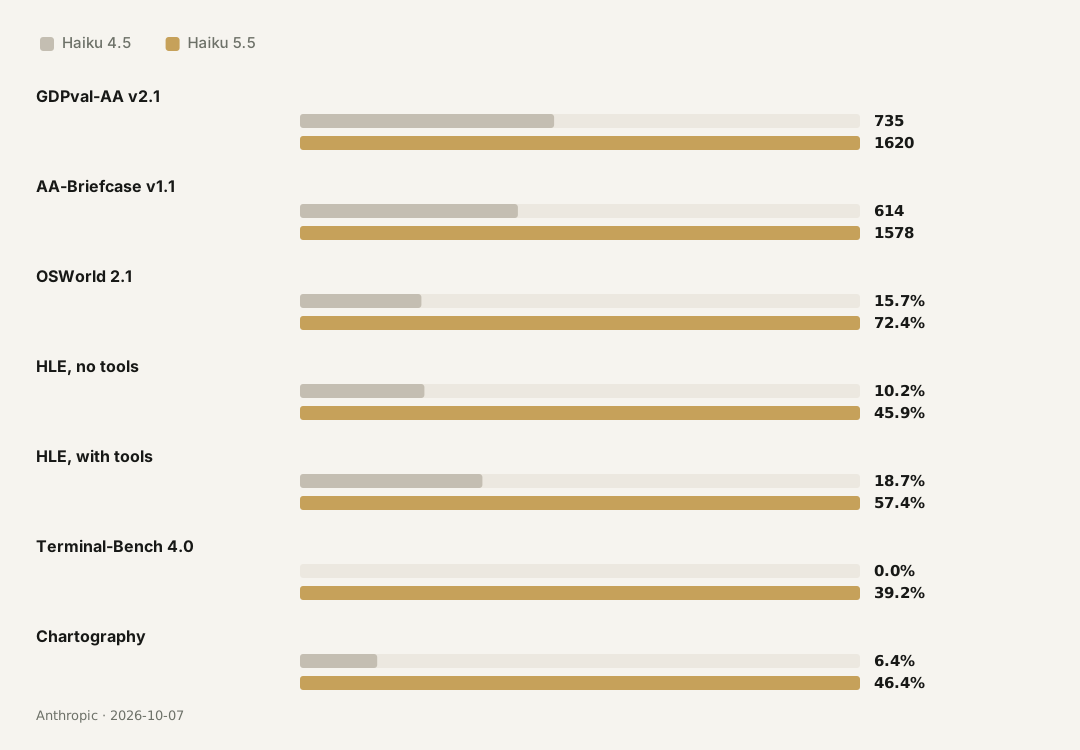
Il ne s’agit pas d’un progrès du type « les formulations sont plus jolies ». OSWorld et Terminal-Bench impliquent de longues chaînes d’actions. Le modèle doit comprendre la tâche, appeler des outils, traiter les retours et continuer après une erreur en cours de route. Les gains sur ces tests montrent que Haiku 5.5 n’est plus seulement un modèle pour la classification et les résumés courts.
OSWorld en est l’exemple le plus frappant. Il y a une vraie rupture entre les 15,7 % de Haiku 4.5 et les 72,4 % de Haiku 5.5. Même en tenant compte de la configuration du benchmark, du sous-ensemble hors ligne et des conditions de test d’Anthropic, le résultat indique un saut d’une génération entière pour l’utilisation de l’ordinateur.
Un gain sur une épreuve ne signifie pas que toutes les tâches de production ont progressé d’autant. Un benchmark mesure un ensemble de tâches précis. Un produit réel dépend aussi de la longueur du contexte, de la définition des outils, de la reprise sur erreur, de la latence réseau et de la qualité des données métier.
Deuxième changement : il est entré dans la zone de GPT-6 Luna
Sur les épreuves publiées par Anthropic, Haiku 5.5 obtient de meilleurs scores que GPT-6 Luna :
- GDPval-AA : 1620 contre 1437 ;
- AA-Briefcase : 1578 contre 1336 ;
- OSWorld : 72,4 % contre 48,9 % ;
- Terminal-Bench : 39,2 % contre 16,4 % ;
- Chartography : 46,4 % contre 29,1 %.
Cet ensemble suffit pour une affirmation prudente : Haiku 5.5 est entré dans la zone où s’affrontent les principaux modèles au meilleur rapport qualité-prix.
Deux réserves doivent l’accompagner.
Premièrement, les chiffres viennent de l’annonce d’Anthropic. Les entreprises ne lancent pas un benchmark, ne configurent pas un modèle, ne branchent pas les outils et ne calculent pas une statistique de la même manière. Le tableau permet de voir où le fabricant situe son produit. Ce n’est pas un classement tiers totalement indépendant et parfaitement symétrique.
Deuxièmement, « meilleur score que GPT-6 Luna » ne veut pas dire « meilleur que GPT-6 Luna sur toutes les tâches ». Le tableau officiel permet de comparer les épreuves publiées. Il ne permet pas d’étendre le résultat à des tâches qui n’ont pas été testées.
Une formulation juste serait :
Sur les épreuves comparatives publiées par Anthropic, Haiku 5.5 a obtenu de meilleurs scores que GPT-6 Luna. Un vrai choix doit encore tenir compte de la tâche, du prix, de la vitesse et de la manière dont le modèle est appelé.
Troisième changement : il se rapproche de Sonnet, mais la hiérarchie des modèles demeure
L’écart entre Haiku 5.5 et Sonnet 5.5 est lui aussi instructif.
Sur GDPval-AA v2.1, Haiku 5.5 obtient 1620 et Sonnet 5.5 1840. Sur AA-Briefcase, les deux scores sont de 1578 et 1824. Sur OSWorld, Haiku 5.5 atteint 72,4 % et Sonnet 5.5 83,9 %. Sur Humanity’s Last Exam sans outils, les scores sont de 45,9 % et 56,9 %. Avec outils, ils sont de 57,4 % et 64,5 %.
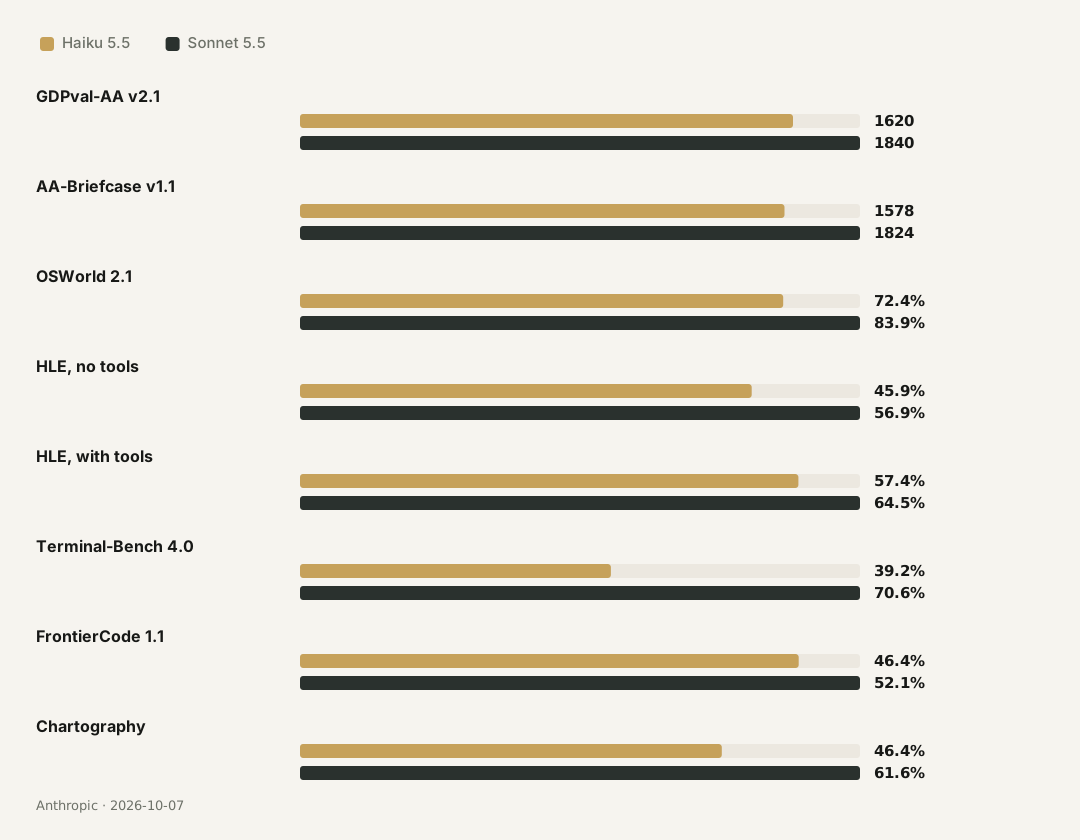
Ces écarts montrent que Haiku 5.5 peut déjà prendre en charge une part réelle du travail intellectuel et de l’utilisation de l’ordinateur. À mesure que le travail se complexifie, Sonnet 5.5 conserve un avantage constant.
C’est sur Terminal-Bench que l’écart mérite le plus d’attention. Haiku 5.5 obtient 39,2 %, Sonnet 5.5 70,6 %. Ce benchmark demande au modèle de mener à bien des tâches professionnelles complexes et en plusieurs étapes dans un environnement en ligne de commande, ce qui se rapproche de la programmation agentique de longue haleine. Haiku 5.5 y dépasse très largement Haiku 4.5, tout en restant loin de Sonnet 5.5.
Cela trace une limite claire pour le choix du modèle :
- pour un travail local, répétitif et vérifiable, Haiku 5.5 est intéressant ;
- pour un travail qui demande une planification à long terme, des modifications sur plusieurs fichiers et des reprises répétées après erreur, Sonnet 5.5 reste plus adapté ;
- un score proche sur certains benchmarks ne justifie pas de traiter les deux comme deux déclinaisons tarifaires d’un même modèle.
Après la baisse de prix, le chiffre à surveiller est le coût par tâche
Le prix est l’autre point fort de cette sortie.
Pour une requête de 100 000 tokens au plus, Haiku 5.5 facture 0,10 $ par million de tokens d’entrée et 0,50 $ par million de tokens de sortie. Au-delà de 100 000 tokens, ces prix passent à 0,50 $ et 2,50 $. Selon Anthropic, le coût moyen d’exécution de Haiku 5.5 est inférieur d’environ 75 % à celui de Haiku 4.5.
| Taille de la requête | Prix d’entrée | Prix de sortie | Lecture en cache |
|---|---|---|---|
| Jusqu’à 100 000 tokens | 0,10 $ / MTok | 0,50 $ / MTok | 0,01 $ / MTok |
| Plus de 100 000 tokens | 0,50 $ / MTok | 2,50 $ / MTok | 0,05 $ / MTok |
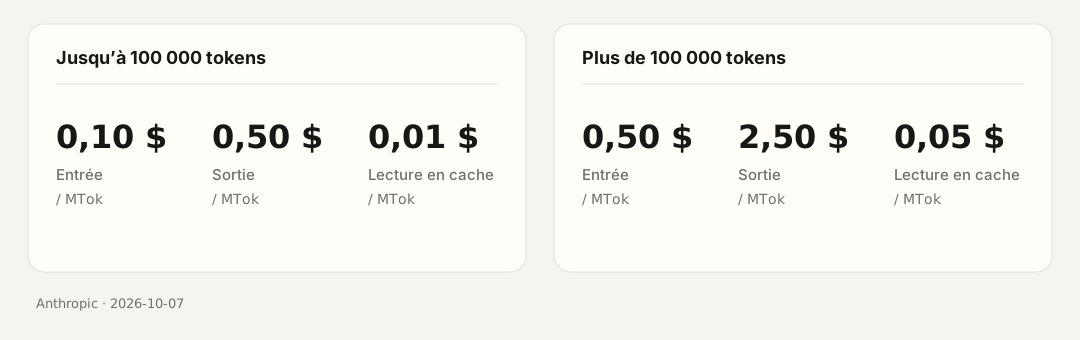
À première vue, l’entrée sous 100 000 tokens passe de 1 $ chez Haiku 4.5 à 0,10 $, et la sortie de 5 $ à 0,50 $, soit une baisse de 90 % du prix unitaire affiché. Anthropic précise toutefois que Haiku 5.5 utilise un tokeniseur plus récent : une même tâche peut donc consommer un peu plus de tokens. La baisse du coût moyen d’exécution est d’environ 75 %, et non de 90 % uniformément.
Un produit réel doit encore se poser trois questions :
- À quelle fréquence Haiku 5.5 termine-t-il la tâche dès le premier appel ?
- Combien de nouvelles tentatives faut-il après un échec ?
- Le résultat doit-il encore être relu et corrigé par Sonnet ou Opus ?
La mesure la plus utile est :
Coût par tâche réussie
= dépense totale pour accomplir le travail ÷ nombre de tâches réussies
Supposons qu’un appel à Haiku 5.5 coûte un dixième d’un appel à Sonnet, mais que la tâche demande deux nouvelles tentatives, ou que 20 % des requêtes finissent par être confiées à Sonnet. L’économie réelle est alors inférieure à l’écart affiché sur la grille tarifaire.
À l’inverse, si une tâche peut être vérifiée automatiquement et qu’un échec peut être relancé à faible coût, Haiku 5.5 peut offrir un avantage économique très net.
Au-delà de 100 000 tokens, le seuil tarifaire change l’architecture du produit
Sur la grille tarifaire de Haiku 5.5, la barre des 100 000 tokens est une vraie ligne de partage.
Pour les requêtes courtes et moyennes, le prix bas se fait facilement sentir. Les dépôts de code, les longues conversations, les bases de connaissances d’entreprise et les grands ensembles de documents approchent souvent les 100 000 tokens, voire les dépassent. Tout entasser dans une seule requête n’est pas forcément la meilleure conception.
Une architecture plus raisonnable fait généralement cinq choses :
- utiliser d’abord Haiku 5.5 pour classer les documents et filtrer ce qui est pertinent ;
- compresser la matière brute en un résumé structuré ;
- n’envoyer à un modèle plus grand que les passages liés à la question posée ;
- mettre en cache le contexte répété ;
- stocker une conversation en plusieurs tours comme un état consultable, au lieu de renvoyer tout le fil à chaque fois.
C’est aussi là que Haiku 5.5 se rapproche le plus d’une architecture d’agents. C’est un modèle bon marché pour répondre, et il peut servir de couche de base pour la compression du contexte, le tri des résultats de recherche et l’exécution de sous-tâches.
Un réglage d’effort rend un classement statique moins utile
Haiku 5.5 est le premier modèle Haiku doté d’un niveau d’effort réglable. Pour un même modèle, un système peut consacrer plus ou moins de calcul au raisonnement selon l’importance de la tâche, et arbitrer entre qualité, latence et coût.
Cela change la façon de lire un benchmark. Un score isolé indique le comportement du modèle dans une configuration donnée. Une courbe coût–qualité montre son comportement selon différents budgets.
Les tâches simples peuvent se contenter d’un effort faible :
- classification ;
- conversion de format ;
- extraction de champs fixes ;
- réécriture d’un texte court.
Les tâches intermédiaires peuvent recevoir un effort plus élevé :
- résumé d’un long document ;
- synthèse d’informations réparties sur plusieurs paragraphes ;
- travail en plusieurs étapes dans un navigateur ;
- tâches qui demandent de juger d’abord, puis d’appeler un outil.
Augmenter l’effort sur une tâche difficile ne remplace pas automatiquement Sonnet. L’écart sur Terminal-Bench le rappelle. Un budget de raisonnement plus important peut améliorer le résultat, mais il n’efface pas un écart en planification à long terme, en reprise sur erreur et en chaînes d’outils complexes.
Traduire les chiffres en une table de routage pratique
Pris ensemble, les scores officiels et le positionnement du produit permettent d’établir une première table de routage prudente :
| Tâche | Choix par défaut | Pourquoi |
|---|---|---|
| Classification, routage, étiquetage | Haiku 5.5 | Gros volume, format de sortie clair, facile à vérifier |
| Extraction de champs et nettoyage de données | Haiku 5.5 | Le périmètre de la tâche est explicite, et le travail se prête à un fort parallélisme |
| Résumés et compression du contexte | Haiku 5.5 | Gros avantage en prix et en vitesse |
| Parcours de navigateur courts ou en une étape | Haiku 5.5 | Le score OSWorld montre un net progrès en utilisation de l’ordinateur |
| Explication de code courante et petites corrections | Haiku 5.5 ou Sonnet 5.5 | Dépend des tests automatiques et du coût d’une erreur |
| Modifications sur de nombreux fichiers | Sonnet 5.5 | Terminal-Bench montre encore un net écart |
| Programmation agentique de longue haleine | Sonnet 5.5 ou Opus 5.5 | Demande une planification soutenue et une reprise sur erreur |
| Revue finale et décisions à fort enjeu | Sonnet 5.5 ou Opus 5.5 | Demande plus de stabilité et un raisonnement plus solide |
Cette table n’est pas une définition définitive de « là où s’arrête Haiku 5.5 ». C’est un premier ensemble de recommandations obtenu en réunissant les benchmarks officiels, le prix et le rôle du produit.
Un déploiement réel doit encore vérifier le travail sur ses propres tâches :
- le résultat atteint-il le niveau d’exigence métier ?
- un échec peut-il être détecté automatiquement ?
- une nouvelle tentative vaut-elle son coût après un échec ?
- la latence plus faible améliore-t-elle réellement le produit ?
- le prix bas est-il absorbé par un coût de relecture humaine plus élevé ?
Comment lire un benchmark officiel
Deux erreurs sont faciles à commettre avec les benchmarks d’un nouveau modèle.
La première consiste à fondre toutes les épreuves en un classement général unique. Le travail intellectuel, l’utilisation de l’ordinateur, le raisonnement ouvert et la programmation agentique sont des capacités différentes. Un total unique ne peut pas les représenter.
La seconde consiste à prendre un score officiel pour une conclusion sur la production. Un benchmark officiel repose sur une configuration de test déclarée. Un produit réel dépend aussi du prompt, des outils, du contexte, du réseau, des données et du mécanisme de reprise sur erreur.
Une lecture plus fiable se fait en trois étapes.
Commencer par le bond en capacités
Haiku 5.5 progresse-t-il de façon constante par rapport à Haiku 4.5 ? D’après le tableau officiel, oui. Le changement se voit notamment sur OSWorld, sur le travail intellectuel et sur les épreuves de programmation agentique.
Regarder ensuite les limites selon la tâche
A-t-il rattrapé le modèle plus grand ? Cela dépend de la tâche. Sur une partie du travail intellectuel et sur l’utilisation de l’ordinateur, il est déjà proche de Sonnet. En programmation agentique complexe, l’écart reste net.
Finir par le coût unitaire
Son intérêt dépend à la fois de la qualité, du prix, de la latence et de la reprise après un échec. Un score de benchmark ne suffit pas à dire si un produit doit changer de modèle.
Le verdict : la force de Haiku 5.5, c’est de pouvoir être utilisé en volume
Si la seule question est de savoir si Haiku 5.5 bat Sonnet 5.5, la réponse est simple : non. Les données officielles montrent déjà que Sonnet 5.5 reste devant en travail intellectuel, en utilisation de l’ordinateur, en raisonnement général et en programmation agentique.
Si la seule question est de savoir si Haiku 5.5 est plus fort que Haiku 4.5, la réponse est tout aussi claire : oui, et le gain est important.
La question qui mérite d’être posée est la troisième. Est-il déjà assez fort pour prendre en charge une grande quantité de travail local au sein des systèmes de production ?
Au vu des scores officiels et du prix, la réponse est probablement oui.
L’intérêt de Haiku 5.5, c’est qu’une série de tâches qui exigeaient auparavant un modèle de taille moyenne, sans justifier le prix d’un tel modèle, peut désormais passer par une couche d’exécution plus rapide et moins chère. Classification, extraction, résumés, compression du contexte, parcours de navigateur courts et sous-tâches d’agents peuvent tous devenir son terrain de prédilection.
Ce n’est pas le bulletin d’un nouveau « champion du classement des modèles ». C’est un bulletin sur la répartition du travail :
- Haiku 4.5 a montré qu’un petit modèle peut faire des tâches simples à bas coût ;
- Haiku 5.5 commence à montrer qu’un petit modèle peut aussi prendre en charge une partie du travail qui demande des outils et plusieurs étapes ;
- Sonnet 5.5 se charge toujours de la planification, de la programmation et du travail intellectuel les plus complexes ;
- Opus 5.5 reste chargé des tâches longues et difficiles, où une erreur coûte cher.
L’enjeu de l’évaluation des modèles se déplace lui aussi : de « qui a le meilleur score » vers « quel modèle vaut le plus la peine d’être appelé, et pour quelle tâche ».


