
La vraie question, avec Kimi K3.1 Pro, est de savoir s’il peut mener une longue tâche jusqu’au bout : comprendre un projet, modifier du code, utiliser des outils et se rattraper quand le résultat échoue. Un premier écran séduisant ne couvre qu’une petite partie de ce travail. Après la dixième révision, les fonctionnalités d’origine marchent-elles encore, et le livrable passe-t-il la validation ?
Les modèles traités ici sont Kimi K3.1 Pro et Kimi K3.1 Pro Highspeed. Les sources ont été vérifiées le 23 octobre 2026. Les résultats chiffrés proviennent de documents officiels. Pour cet article, Folkbench n’a pas appelé ces modèles ni relancé leurs benchmarks, et ne leur attribue pas de score indépendant.
Commencer par identifier le modèle
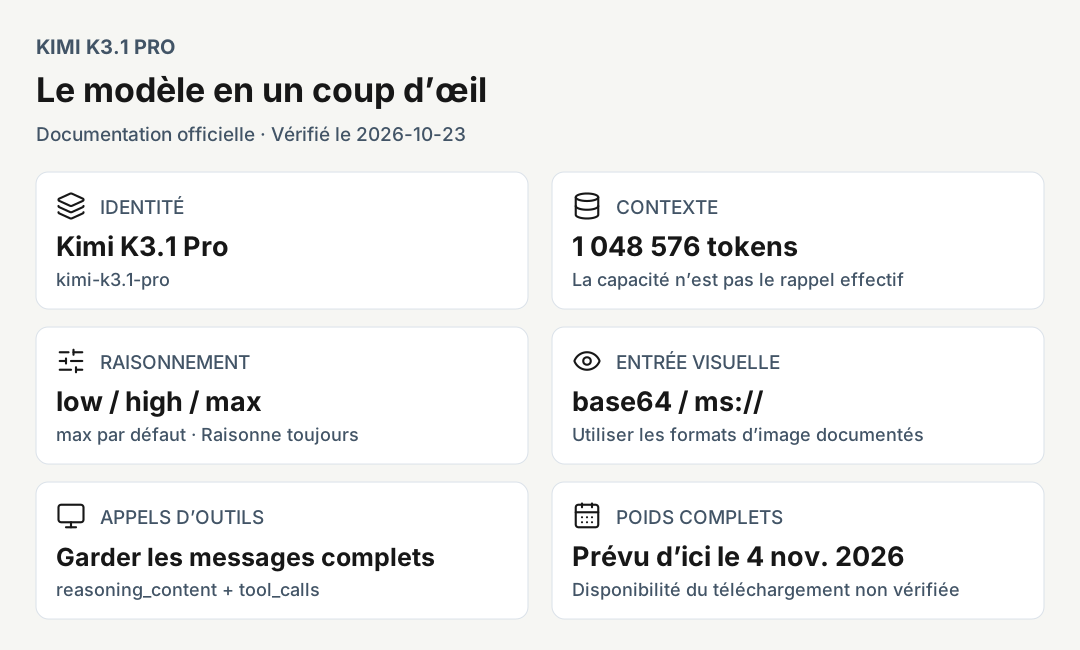
| Élément | Documentation vérifiée |
|---|---|
| ID d’API standard | kimi-k3.1-pro |
| ID d’API Highspeed | kimi-k3.1-pro-highspeed |
| Positionnement officiel | Modèle phare pour la programmation, la création 3D et la recherche financière |
| Taille annoncée | Classe 3T ; cela ne dit rien des paramètres actifs par requête |
| Fenêtre de contexte | 1 048 576 tokens |
| Effort de raisonnement | low, high, max ; max par défaut |
| Vision et outils | Entrée visuelle, appels d’outils et sortie en flux |
| Poids | Le blog technique prévoit les poids complets d’ici le 4 novembre 2026 ; la disponibilité du téléchargement n’a pas été vérifiée ici |
L’identité et le positionnement proviennent de la liste des modèles, la taille exacte du contexte de la documentation de facturation, et les capacités de l’interface du guide de démarrage rapide. Le blog technique décrit un post-entraînement sur K3 et fournit le calendrier de publication des poids. Un numéro de version ne suffit pas à établir une nouvelle architecture sous-jacente ; un calendrier de publication ne prouve pas que le déploiement local est déjà possible.
Deux benchmarks, deux questions différentes
Ces chiffres sont la comparaison publiée dans le blog technique de Kimi. Les colonnes des concurrents proviennent aussi de cette page, et non d’une expérience menée par Folkbench dans un environnement commun.
| Évaluation | Kimi K3.1 Pro | Claude Opus 5.5 | GPT-6 Astra |
|---|---|---|---|
| Terminal-Bench 4.0 | 65,7 % | 66,4 % | 58,2 % |
| BenchCAD, avec outils, Voxel IoU | 92,7 % | 96,2 % | 95,9 % |
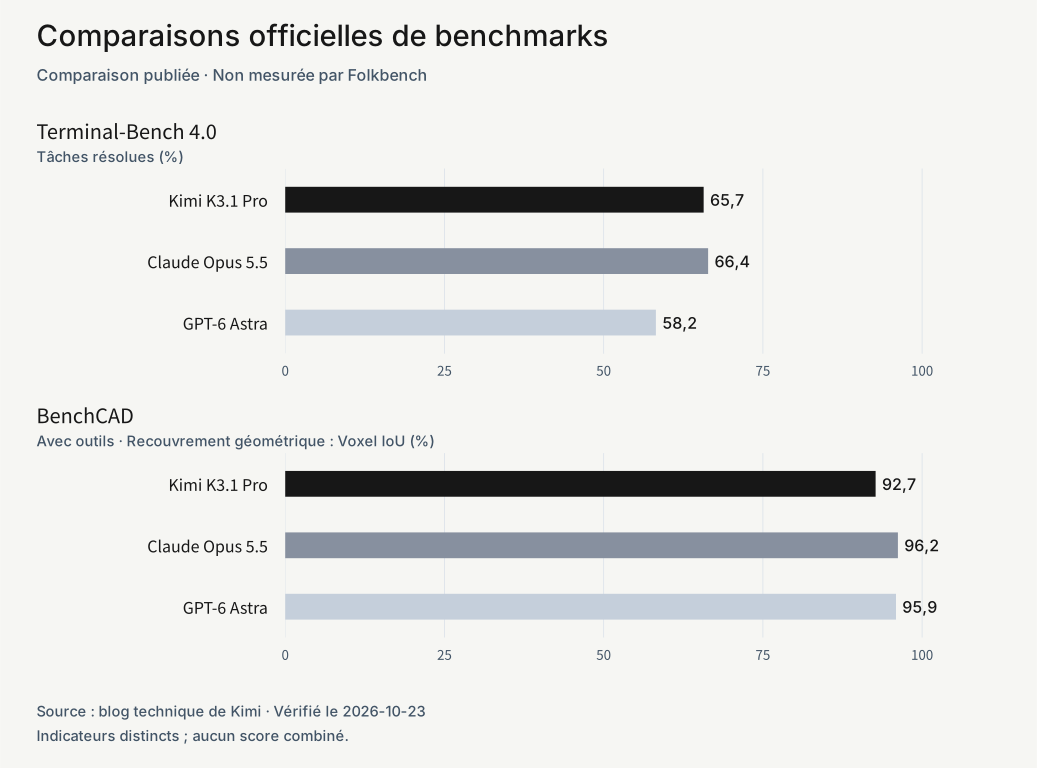
Les notes de bas de page indiquent l’effort max par défaut. Le passage de Kimi sur Terminal-Bench utilise Claude Code ; les résultats des concurrents sont repris de leurs annonces ou de classements. BenchCAD teste les modèles ouverts sur un sous-ensemble de 1 000 cas, en utilisant aussi Claude Code pour la configuration avec outils. Ces conditions doivent accompagner les scores.
Programmation : un score proche exige quand même une validation à l’échelle du projet
65,7 % et 66,4 % diffèrent de 0,7 point de pourcentage. Les deux sont proches dans ce tableau publié. Sans budgets identiques, nombre de répétitions et estimation de l’incertitude, cela ne suffit pas pour affirmer une capacité égale. De même, un score supérieur à celui d’un autre modèle sur une évaluation ne prouve pas une supériorité sur l’ensemble des tâches de programmation.
Dans les vrais projets, la reprise après erreur compte. Une demande peut exiger de modifier une interface, de mettre à jour les appelants et de préserver la compatibilité, le tout sans casser le comportement existant. La quantité de code générée au premier essai en dit peu sur ces obligations. Le modèle doit comprendre ce que signifie un test qui échoue, au lieu de supprimer une assertion, d’affaiblir une condition ou d’abandonner une fonctionnalité pour passer au vert.
Avant de migrer, rejouez une tâche déjà résolue dont les critères de validation sont clairs. Figez la révision du dépôt et les exigences, laissez chaque candidat travailler seul, puis examinez les résultats des tests, l’étendue des modifications et les corrections manuelles. Ce relevé éclaire une décision mieux qu’une démonstration soignée. Il s’agit d’un exercice de validation proposé, pas d’une expérience réalisée pour cet article.
3D : le recouvrement géométrique n’est qu’une partie du livrable
L’indicateur BenchCAD utilisé ici est le Voxel IoU. Une valeur de 92,7 % n’est ni un taux de réussite des tâches de 92,7 %, ni une note de qualité artistique. La géométrie, les matériaux, l’éclairage, l’animation, la possibilité de modifier le modèle et les tolérances de fabrication demandent chacun des vérifications différentes.
Pour une scène Three.js, vérifiez que les interactions fonctionnent, ainsi que les performances sur l’appareil et le chargement des ressources. Pour une pièce modifiable, vérifiez les cotes, le comportement après un changement de paramètres et les fichiers exportés. Un rendu convaincant sous un angle peut cacher des surfaces manquantes, des géométries qui s’interpénètrent ou une topologie inutilisable.
Notre appréciation éditoriale, à partir de ces résultats officiels : K3.1 Pro mérite d’être envisagé pour les longues tâches de programmation et la modélisation programmatique. Savoir s’il peut remplacer une solution existante doit dépendre des livrables du projet visé.
Un contexte d’un million de tokens répond à une question de capacité
Le nombre de fichiers qui tiennent dans 1 048 576 tokens dépend du contenu et de la tokenisation. Ce n’est pas un nombre fixe de mots ou de lignes. La capacité ne garantit pas non plus que le modèle trouve les bons éléments, retienne chaque contrainte ou suive l’objectif initial après de nombreux appels d’outils.
Envoyer un dépôt entier peut faire entrer, à côté du code utile, des fichiers générés, de la documentation obsolète et des instructions contradictoires. Précisez la révision actuelle, les fichiers concernés, le comportement qui ne doit pas changer et le point d’entrée de la validation. Un contexte utile compte plus qu’un contexte gonflé sans discernement.
Il y a aussi un coût récurrent. La documentation officielle des modèles de réflexion exige de conserver le raisonnement des messages assistant précédents ; il continue d’occuper le contexte et d’être facturé. Une réponse visible courte peut donc s’accompagner d’une facture de tokens bien plus lourde.
Les réglages de l’API peuvent changer l’expérience
Le guide sur l’effort de raisonnement indique que K3.1 Pro raisonne toujours et utilise max par défaut. Choisir low réduit l’effort ; cela ne désactive pas la réflexion. Alignez l’effort avant de comparer la latence, sinon une différence de vitesse apparente peut refléter des budgets différents.
Lors de la migration, vérifiez trois points :
- Utilisez
reasoning_effortau premier niveau de la requête au lieu de reprendre la configurationthinkingde K2. - Conservez les messages assistant complets dans les boucles d’outils, y compris
reasoning_contentettool_calls. Ne garder que le texte final supprime un historique obligatoire. - Pour la vision, suivez le guide de démarrage rapide : utilisez du base64 ou des références de fichiers
ms://, sans supposer que n’importe quelle URL d’image publique est acceptée.
Un relais ajoute ses propres questions : conserve-t-il les champs, tronque-t-il les réponses, remappe-t-il le nom du modèle, omet-il les informations de consommation ? Une réponse texte réussie ne prouve pas que la boucle d’outils de l’agent qui l’entoure fonctionne correctement.
Le coût se calcule sur la tâche entière
Lors de cette vérification, la page de tarifs officielle et sa version Markdown n’ont pas renvoyé de ligne de prix complète et vérifiable pour K3.1 Pro. Nous ne publions donc aucun tarif en dollars et ne lui substituons ni les prix de K3 ni ceux des relais. Cela ne prouve pas que les prix officiels ne sont pas publiés ; cela décrit ce que cet article a pu vérifier.
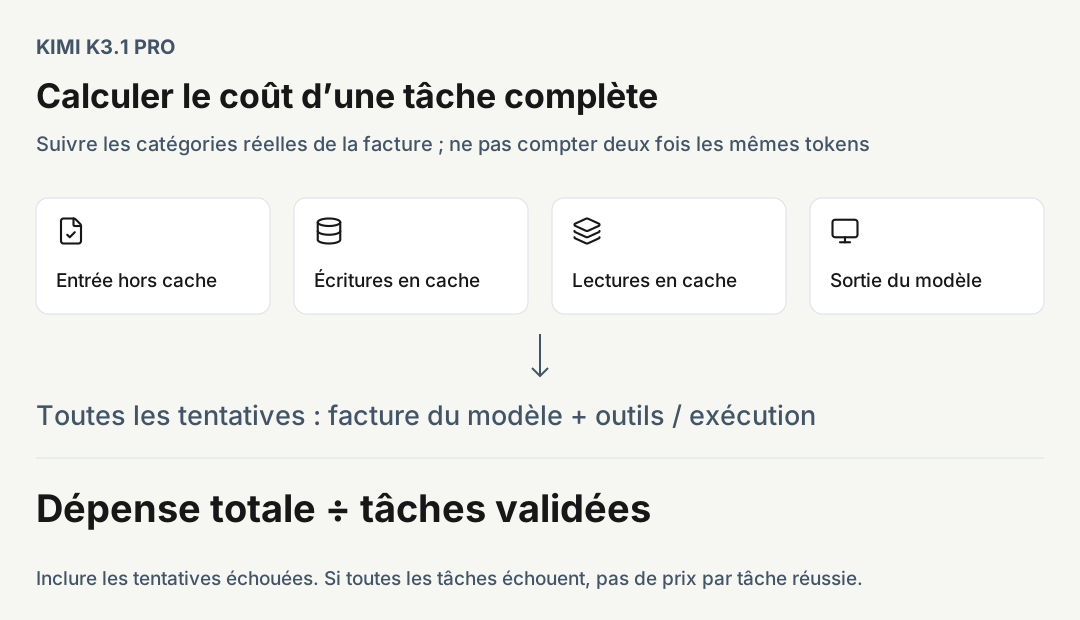
La structure de facturation est documentée : l’utilisation de l’API est facturée séparément de l’abonnement Kimi et de Kimi Code ; les écritures en cache varient selon le TTL, tandis que les succès de cache et l’entrée hors cache relèvent de catégories de facturation distinctes. Le guide de démarrage rapide décrit une tarification sans paliers liés à la longueur du contexte. Le guide du cache documente la réutilisation et la durée de conservation.
Pour évaluer une tâche à contexte long, séparez les défauts de cache, les écritures, les lectures et la sortie générée. Les services d’outils, les environnements d’exécution et les nouvelles tentatives échouées peuvent alourdir la dépense. Suivez les catégories réelles de la facture pour ne pas compter deux fois les mêmes tokens.
Pour un achat, une mesure utile est la dépense totale du lot divisée par le nombre de tâches validées. Les tentatives échouées restent au numérateur ; si toutes les tâches échouent, il n’y a pas de prix par tâche réussie à indiquer. C’est une méthode de comparaison suggérée, pas un résultat mesuré par Folkbench.
La liste des modèles présente Highspeed comme conservant les mêmes capacités, avec une vitesse environ 2 à 3 fois supérieure. C’est une affirmation du fournisseur, pas une mesure de bout en bout d’un flux de travail. Si la génération représente la moitié du temps total, ramener cette moitié au tiers fait passer le temps total de 1 à environ 0,67 : la vitesse globale n’est multipliée que par 1,5 environ. Ce calcul hypothétique illustre un goulot d’étranglement, pas une latence observée chez Kimi.
Par où commencer l’évaluation
| Travail | Capacité à examiner | Un résultat de validation utile |
|---|---|---|
| Modifications sur plusieurs fichiers de code | Contraintes, outils et reprise après erreur | Tests réussis, fonctionnalités préservées, corrections manuelles acceptables |
| 3D programmatique et interaction web | Relations spatiales, scripts et itérations | Fichiers modifiables, interactions fonctionnelles, performances suffisantes |
| Recherche multidocument et tableurs | Recherche et recoupement des éléments de preuve | Citations traçables, unités cohérentes, calculs reproductibles |
| Extraction simple ou classification fréquente | Latence et coût par tâche | Une dépense plus faible au même seuil de qualité |
Les trois premiers correspondent à son positionnement, mais le positionnement ne garantit pas la qualité. En recherche, une prose fluide et de nombreuses citations ne remplacent pas la vérification : chaque source appuie-t-elle bien chaque affirmation, les dates et les unités concordent-elles, les formules du tableur peuvent-elles être recalculées ? Pour une classification simple, un modèle phare qui tourne par défaut en max n’est pas forcément économique.
L’appréciation de Folkbench
Les documents officiels donnent à K3.1 Pro une raison crédible d’entrer dans une évaluation sérieuse : ses résultats en programmation et en modélisation programmatique se situent près de concurrents solides. Sa valeur pratique dépend de sa capacité à transformer ces aptitudes en livrables validés, avec vos entrées, vos outils et votre budget.
Cet article ne dispose ni de relevés d’appels indépendants, ni d’essais répétés, ni de distributions des échecs, ni de prix unitaires vérifiés : il ne propose donc ni score composite ni verdict sur le meilleur rapport qualité-prix. Certains passages du guide de démarrage rapide consacrés aux benchmarks contiennent encore des espaces réservés et diffèrent en version du blog technique. Les deux comparaisons ci-dessus s’appuient uniquement sur le blog, sans mélanger les versions.
Pour les flux de travail de code, poursuivez avec le [guide d’évaluation en ingénierie logicielle de Folkbench](/fr/blog/ai-api-relay-software-engineering-evaluation-guide). Sur d’autres modèles, voir aussi [Claude Opus 5.5](/fr/blog/claude-opus-5-5-review-pricing) et [GPT-6.1 Sol](/fr/blog/gpt-6-1-sol-review-pricing). Sol n’est pas le GPT-6 Astra du tableau ; leurs identités et leurs scores ne sont pas interchangeables.


