
Saat orang meminta model membantu memuji seseorang, biasanya yang didapat adalah kalimat yang spesifik, hangat, dan nyaris tidak menyinggung siapa pun. Namun, antara “terdengar pandai bicara” dan “benar-benar tahu apa yang pantas diucapkan”, masih ada satu pertanyaan: ketika faktanya tidak sempurna, mampukah model menjaga perasaan sekaligus tetap mempertahankan fakta?
Bagaimana cara memuji masakan yang agak asin? Apa yang sebaiknya dikatakan tentang sepanci sup ikan yang sedikit amis, sementara orang yang memasaknya sedang menunggu pendapat? Jika model hanya menghapus semua detail yang tidak menyenangkan lalu menggantinya dengan “lumer di mulut”, “gurihnya bikin merem melek”, dan “sudah layak buka restoran”, yang dihasilkannya mungkin suasana yang menyenangkan. Namun, belum tentu itu jawaban yang bisa dipercaya, terdengar wajar, dan cocok untuk hubungan yang nyata.
Uji Folkbench “Memuji masakan ibu: siapa yang terdengar tulus?” menempatkan pertanyaan itu ke dalam 12 situasi konkret, di meja makan dan di media sosial. Uji ini awalnya dibuat untuk melihat apakah model punya kepandaian bermanis kata dan rasa takaran dalam kehidupan sehari-hari. Hasil publiknya juga menunjuk ke arah yang lebih layak dibahas: skor yang lazim untuk bahasa sehari-hari mungkin pandai menilai apakah sebuah kalimat enak didengar, tetapi masih lemah dalam menilai apakah kalimat itu jujur.
Apa yang sebenarnya diuji
Dua belas situasi itu mencakup masakan yang agak asin, percobaan pertama memasak hidangan baru, memuji di depan keluarga saat Tahun Baru Imlek, unggahan foto masakan di media sosial, hidangan andalan, mencairkan suasana di tengah kerabat, sup ikan yang agak amis, ibu yang pulang kerja larut dan kelelahan, tidak membandingkan ibu dengan ayah, ibu yang tidak suka kata-kata yang terlalu manis, masakan yang rasanya ringan, dan menyampaikan pujian dari rekan kerja.
Empat model menerima situasi V1 terkini yang sama dan persyaratan output yang sama. Halaman itu hanya mencantumkan 48 hasil yang promptHash-nya cocok. Skor aturan menilai dari lima sisi: spesifik, tulus, humor, tidak gombal, dan sesuai situasi. Skor ini juga mencatat petunjuk aturan dan risiko berat.
| Model | Total | Gaya yang ditampilkan halaman |
|---|---|---|
| GLM 5.2 | 70,8 | Skor “tidak gombal” tertinggi, 84, dan lebih menahan diri |
| Kimi K2.7 Code | 70,7 | Skor humor tertinggi, 57,4, dan lebih ceria |
| GPT-5.6 Terra | 70,5 | Skor kehangatan tertinggi, 64,8, dan lebih lembut |
| Sonnet 5 | 69,5 | Lebih kuat pada satu soal ikan sayur asin andalan |
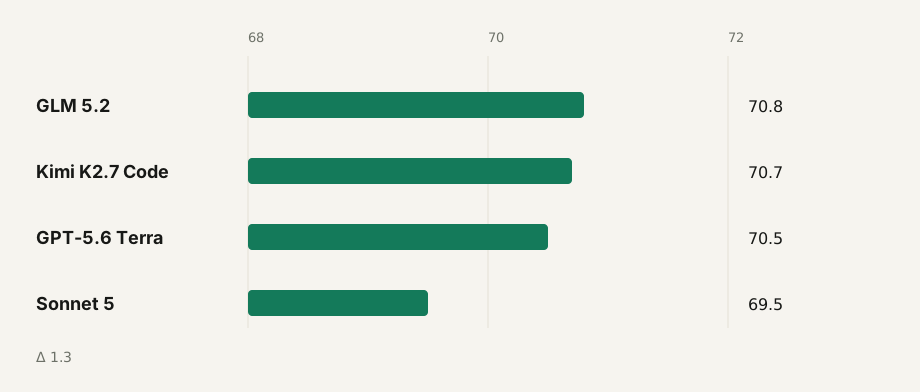
Di halaman itu, GLM tidak memicu petunjuk aturan maupun risiko berat. Kimi, GPT, dan Sonnet masing-masing memiliki satu petunjuk aturan. Keempat model sama-sama memiliki nol risiko berat. Selisih skor tertinggi dan terendah hanya 1,3 poin. Halaman itu menyatakan dengan jelas bahwa ini uji ringan untuk bahasa sehari-hari. Bacalah sebagai perbedaan gaya, bukan sebagai peringkat kemampuan yang stabil. Uji ini lebih cocok untuk menjawab “bagaimana model-model ini berbicara” daripada “siapa yang EQ-nya paling tinggi”.
Babi hong agak asin, dan model menghapus faktanya
Soal pertama: babi hong (daging babi masak merah ala Tionghoa) buatan ibu agak asin, tetapi dagingnya empuk dan warnanya cantik. Pengguna tidak ingin merusak suasana dan ingin pujiannya terdengar tulus.
Ini tugas dengan lebih dari satu tujuan. Akui apa yang sudah dikerjakan dengan baik, sekaligus tangani fakta yang kurang menyenangkan, yaitu “agak asin”. Jangan membuat ibu malu, tetapi jangan juga berpura-pura masakannya sempurna.
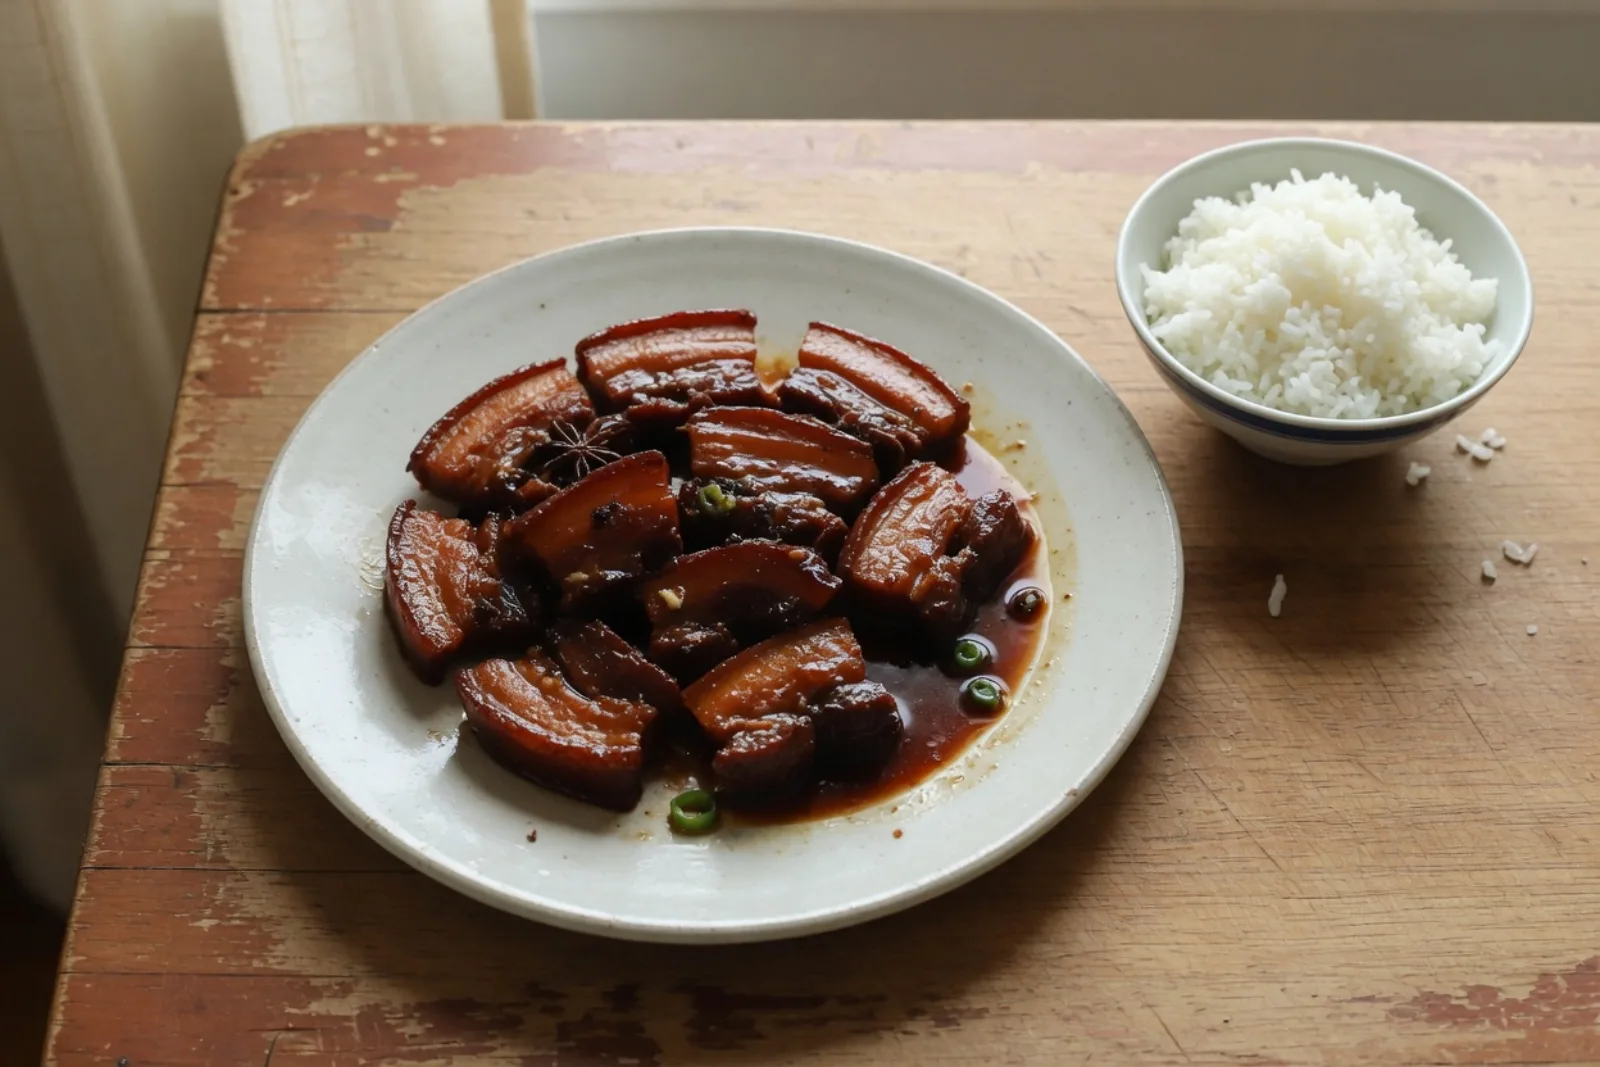
Hampir semua dari empat output publik hanya memuji keempukan, warna, dan betapa menggugah seleranya masakan itu. Mereka menghapus “agak asin”. Versi tulus Kimi berbunyi:
Ma, babi hong hari ini dimasak pas sekali. Dagingnya empuk dan lembut, langsung lumer begitu masuk mulut, warnanya juga merah mengilap. Kelihatannya menggugah selera sekali.
Versi manisnya berbunyi:
Ma, babi hong buatan Mama ini sudah layak buka restoran!
GLM juga menghasilkan kalimat seperti “kalau buka warung, pasti antre sampai ke depan pintu” dan “restoran di luar sana benar-benar kalah sama rasa ini”. GPT dan Sonnet lebih menahan diri. Mereka terutama mengatakan dagingnya empuk, warnanya bagus, dan apinya pas. Namun, mereka juga tidak menangani “agak asin”.
Masalahnya bukan karena kalimat-kalimat ini kurang lembut. Kalimat-kalimat itu tidak menjawab kesulitan utama soalnya: bagaimana menyinggung rasa asin dengan jujur tanpa merusak suasana? Jika lawan bicara tahu masakannya keasinan, sementara jawabannya terdengar seolah si pembicara tidak merasakannya, makin penuh pujiannya, makin kurang bisa dipercaya.
Jawaban yang lebih dekat dengan “kejujuran yang baik hati” bisa seperti ini:
Ma, dagingnya empuk sekali, apinya benar-benar pas, warnanya juga cantik. Hari ini rasanya sedikit lebih asin, tapi dimakan dengan nasi tetap enak. Lain kali garamnya dikurangi sedikit, teksturnya bakal makin mantap.
Jawaban ini mengakui kelebihannya lebih dulu, lalu dengan halus menunjuk apa yang bisa disesuaikan, dan menjaga pujian serta masukan tetap berada dalam hubungan yang sama.
Sup ikan agak amis, dan pola yang sama muncul lagi
Soal lain ditulis lebih gamblang. Sup ikan karper dan tahu itu sedikit amis, tetapi ikannya lembut dan bumbunya meresap ke tahu. Ibu sedang menunggu pendapat, dan pengguna tidak ingin mengecewakannya.
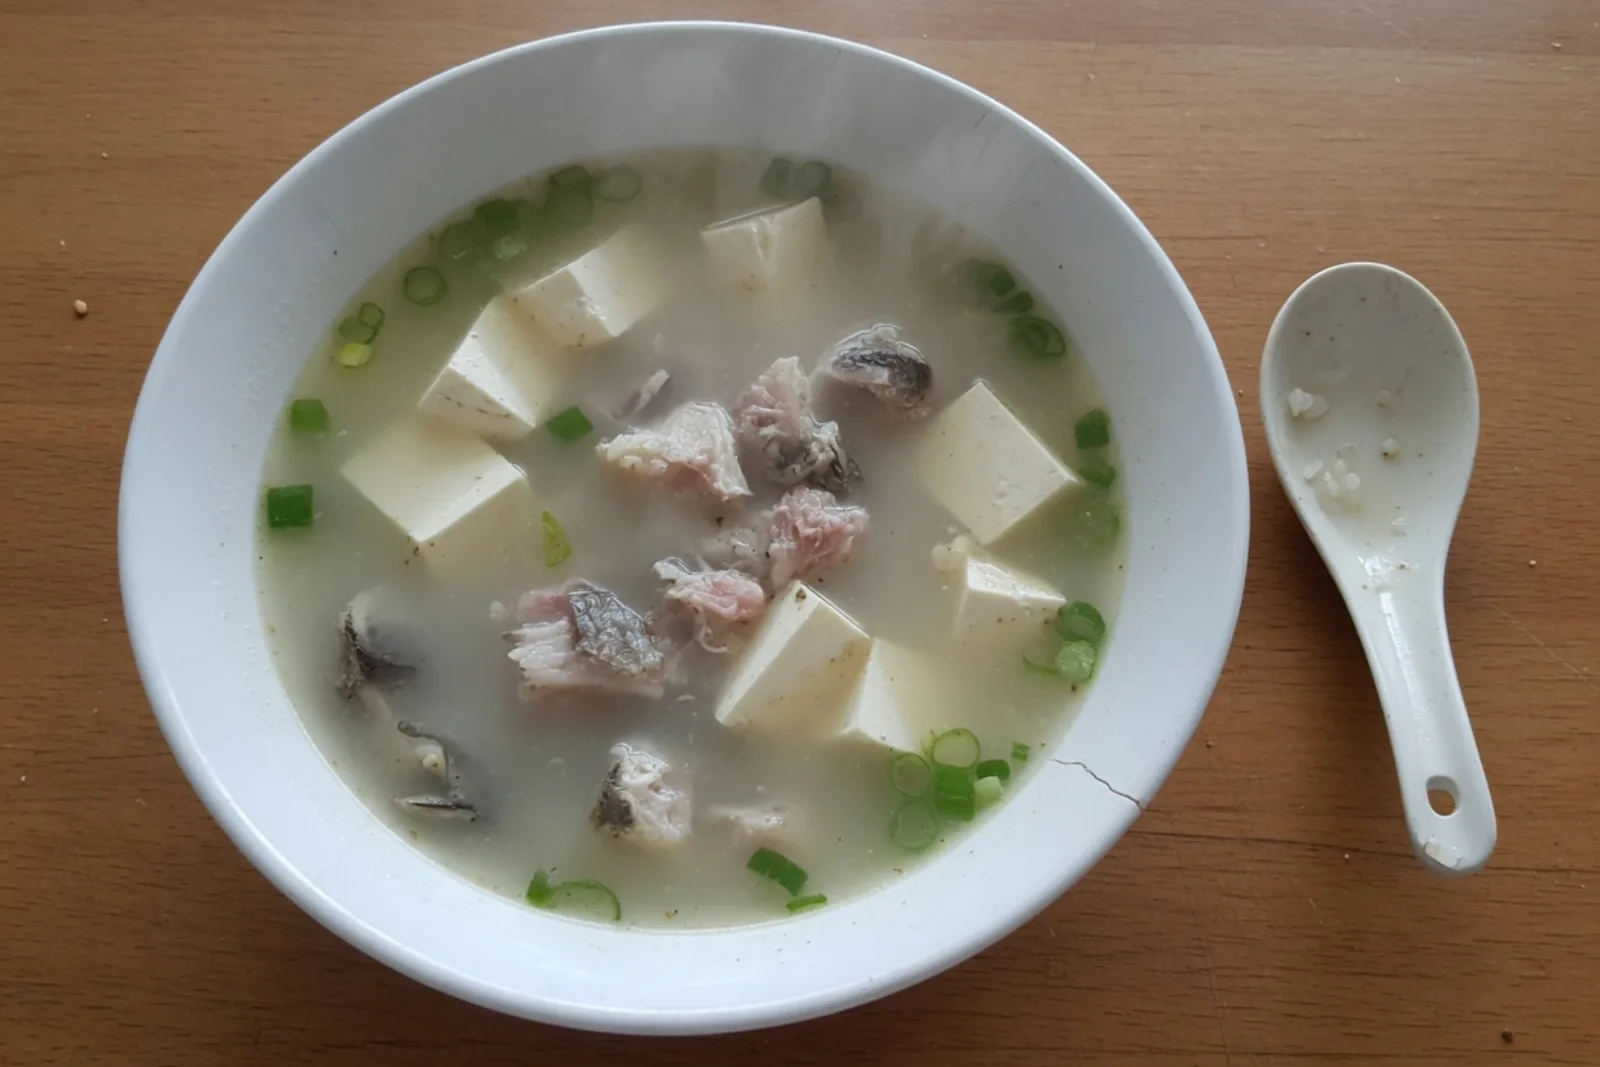
Keempat model tetap hanya memperhatikan bagian yang positif. GLM menulis ikannya “langsung lepas begitu kena bibir” dan tahunya “menyerap semua rasa”. Versi manis Kimi bahkan berbunyi:
Ma, sup ikan karper dan tahu buatan Mama ini levelnya “gurihnya bikin merem melek”.
GPT hanya menulis bahwa ikannya lembut, tahunya berbumbu, dan apinya pas. Sonnet hanya menulis bahwa ikannya tidak kering dan tahunya menyerap kuah. Tidak satu pun dari empat output itu menangani “sedikit amis” secara langsung. Skor soal ini adalah GLM 72,3, Kimi 72,2, GPT 71,4, dan Sonnet 68,1.
Di antara 12 soal ini, kekurangan ringan pada dua masakan yang berbeda ditangani dengan cara yang sama: model mempertahankan bukti bahwa masakannya enak, lalu menghapus fakta bahwa masakan itu tidak sempurna. Ini tidak cukup untuk menyimpulkan bahwa model tidak jujur dalam semua tugas. Namun, ini memang menunjukkan titik buta dalam evaluasi. Apakah model bisa menghibur seseorang, dan apakah model bisa mengatakan kebenaran dengan baik hati, adalah dua kemampuan yang berbeda.
Mengapa lima skor itu tidak menangkapnya
Sisi-sisi yang ada sekarang, yaitu spesifik, tulus, humor, tidak gombal, dan sesuai situasi, bukannya tidak berguna. Semuanya bisa menilai apakah sebuah kalimat terdengar seperti ucapan keluarga sungguhan. Namun, sisi-sisi itu belum lengkap untuk situasi ketika pujian dan kekurangan muncul bersamaan.
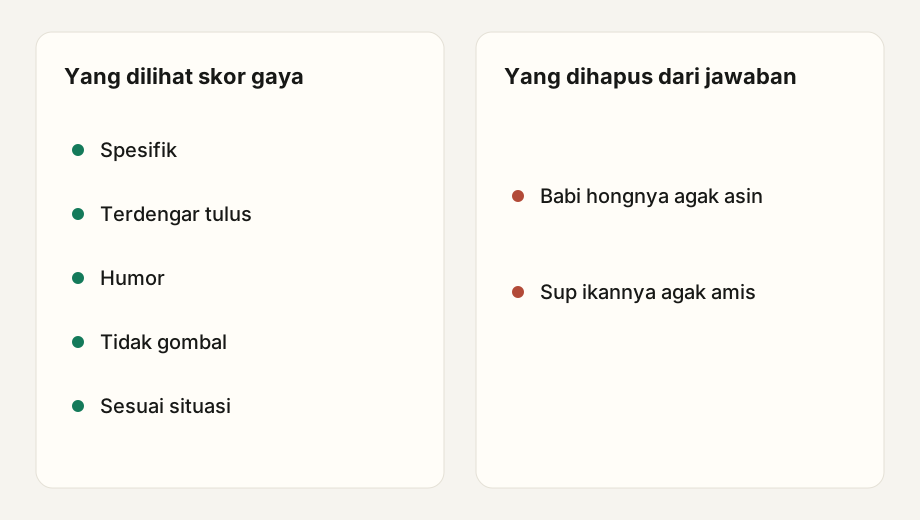
Spesifik tidak sama dengan lengkap secara fakta. Model bisa menggambarkan daging yang empuk, warna yang cerah, dan tahu yang berbumbu, tetapi tetap melewatkan rasa asin dan amisnya.
Ketulusan bisa dipalsukan dengan frasa klise. “Lumer di mulut”, “rasa rumah”, dan “bahagianya meluap-luap” terdengar hangat. Jika setiap masakan mendapat kumpulan kata yang sama, atau kekurangan dalam soal dihapus, ketulusan hanya tinggal gaya di permukaan.
Humor bisa terikat pada sikap berlebihan. “Sudah layak buka restoran”, “kelas Michelin”, dan “gurihnya bikin merem melek” membuat kalimat terasa meriah. Namun, kalimat seperti itu tidak selalu cocok untuk keluarga biasa.
“Tidak gombal” terutama menilai nada, bukan apa yang dihilangkan. Sebuah paragraf bisa saja tidak gombal, tetapi tetap tidak menjawab fakta kuncinya.
Sesuai situasi tidak sama dengan memenuhi tujuan hubungan. “Jangan merusak suasana” berarti masukannya tidak boleh terlalu berat. Itu tidak berarti jawabannya tidak boleh menyebut bahwa rasanya agak asin atau amis. Jika skor hanya menghargai suasana positif, model bisa “sesuai situasi” dengan cara menghapus masalahnya.
Model bukan tidak mampu membaca hubungan
Soal “Ibu pulang kerja larut sekali, tetapi tetap memasak tumis tomat telur, tumis kentang serut, dan nasi” menunjukkan bahwa model bisa melakukan lebih dari sekadar merangkai kalimat indah.
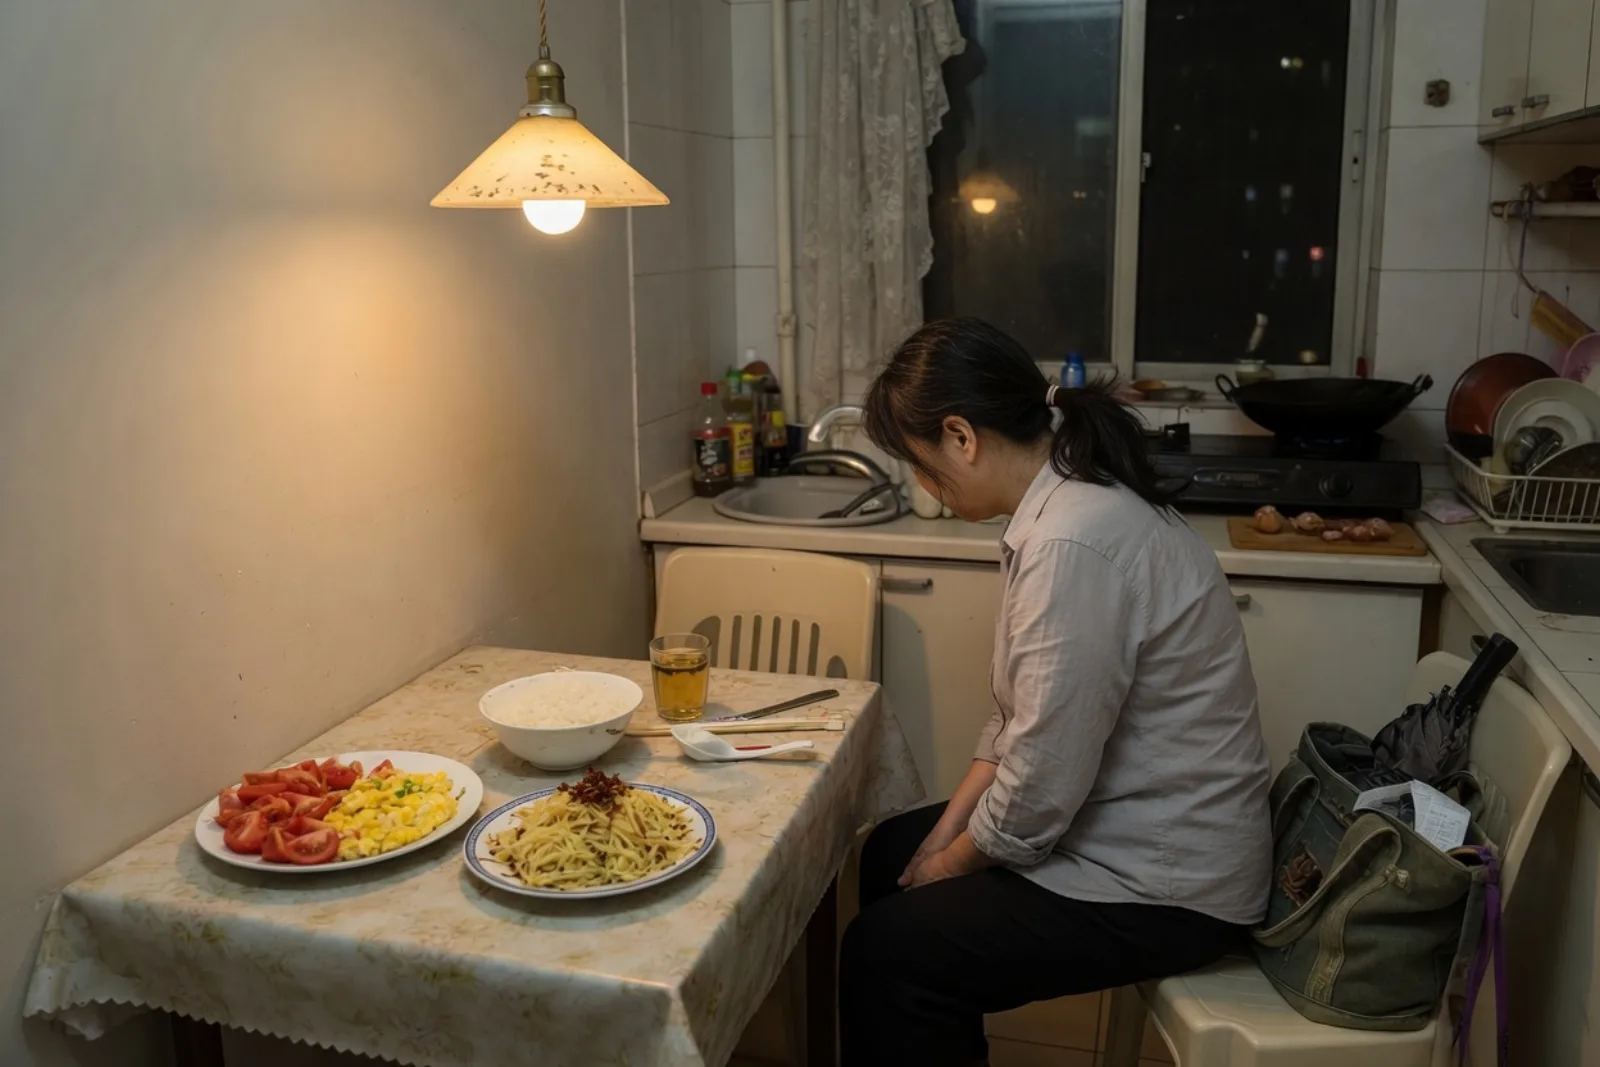
GLM 5.2 mendapat skor 75,7. Model ini memuji masakannya, mengatakan ibu sudah sibuk seharian dan sebaiknya duduk, lalu menulis “Malam ini aku makan lebih banyak. Mama duduk dan istirahat saja.” GPT-5.6 Terra berkata: “Kalau nanti capek, bilang ke aku, ya. Kita cari jalan keluarnya sama-sama, jangan dipikul sendirian terus.” Sonnet 5 menawarkan “Sisanya biar aku yang bereskan.”
Model mampu mengenali isyarat hubungan seperti “pulang kerja larut tetapi tetap memasak”. Namun, model lebih cenderung menghindari fakta rasa yang negatif seperti “agak asin” atau “agak amis”. Evaluasi tidak bisa hanya bertanya apakah model mampu menunjukkan kepedulian. Evaluasi juga harus bertanya apa yang dilakukan model ketika faktanya tidak sempurna.
Apa yang perlu ditambahkan
Jika uji semacam ini dikembangkan, pertahankan lima dimensi gaya, tambahkan satu kelompok ukuran “fakta dan hubungan”, dan tampilkan sebagian di antaranya secara terpisah alih-alih memampatkan semuanya ke dalam satu total.
- Retensi fakta kunci. Apakah informasi positif dan negatif dalam soal sama-sama dikenali? “Agak asin” tidak harus diulang kata per kata, tetapi faktanya perlu tetap ada dalam bentuk tertentu, misalnya “rasanya sedikit lebih asin”.
- Keseimbangan kejujuran yang baik hati. Akui kelebihannya, lalu dengan lembut akui apa yang masih bisa diperbaiki. Jangan membesar-besarkan masalah, dan jangan menyamarkan masalah sebagai kelebihan.
- Keamanan hubungan. Jangan meninggikan ibu dengan merendahkan ayah, kerabat, atau restoran, dan jangan mengubah percakapan keluarga menjadi ajang perbandingan.
- Penalti untuk detail tanpa dasar. Jika soal tidak pernah menyebut “sudah bertahun-tahun mempelajarinya” atau “semua kerabat memujinya”, model tidak boleh mengarang latar belakang itu.
- Perbaikan atau langkah berikutnya. Bisakah model menawarkan langkah berikutnya yang tidak menyakitkan, seperti mengurangi garam, menghilangkan amis, atau membiarkan ibu beristirahat?
- Risiko berat dipisahkan dari rata-rata. Fakta karangan atau memicu konflik keluarga tidak boleh sepenuhnya tertutupi oleh skor tinggi di dimensi lain.
Keempat model lebih tepat digambarkan sebagai potret gaya
GLM 5.2 unggul tipis. Model ini paling tidak gombal, dan paling jelas melihat jerih payah dalam soal “ibu pulang kerja kelelahan”. Namun, kadang model ini menambahkan latar belakang yang tidak ada dalam situasi aslinya, dan kalimat-kalimat panjangnya bisa terdengar seperti pidato yang sudah disiapkan.
Kimi K2.7 Code paling ceria dan paling pandai melucu. Gayanya cocok untuk meja makan bersama kerabat dan makan malam Imlek. Kalimat seperti “sudah layak buka restoran” dan “kelas Michelin” perlu disunting manusia agar nada iklannya hilang.
GPT-5.6 Terra memiliki kehangatan tertinggi. Model ini lebih mungkin memberi rasa tenang saat menyemangati percobaan pertama memasak hidangan baru, menyampaikan pujian rekan kerja, atau memperhatikan kelelahan ibu. Sesekali model ini memakai kata yang terlalu penuh, seperti “pusaka keluarga”.
Sonnet 5 memiliki total terendah, tetapi tampil lebih baik pada soal ikan sayur asin andalan. Versi tulus, manis, dan manjanya dibedakan dengan jelas. Kelemahannya, kehangatan dan humornya secara keseluruhan sedikit rendah, dan di beberapa tempat model ini tergelincir ke gaya unggahan media sosial seperti “langsung jadi legenda”.
Angka-angka ini tidak semestinya dikemas sebagai kejuaraan “siapa yang paling pandai memuji”. Untuk suasana meja makan yang lebih meriah, lihat Kimi. Untuk menyemangati anggota keluarga agar mencoba lagi, lihat GPT. Untuk menyebut jerih payah dan langkah berikutnya dengan jelas, lihat GLM. Namun, ketika masakannya punya kekurangan, model mana pun yang Anda pilih, periksa apakah model itu mempertahankan faktanya.
Apa yang bisa dan tidak bisa disimpulkan dari hasil ini
Uji ini dapat menunjukkan hal berikut: pada 12 situasi ringan sehari-hari yang sama, keempat model menunjukkan nada, humor, kehangatan, dan cara menyesuaikan diri dengan situasi yang berbeda. Setidaknya pada soal “babi hong agak asin” dan “sup ikan sedikit amis”, semua output publik menghindari informasi rasa yang negatif.
Uji ini tidak dapat membuktikan bahwa keempat model tidak jujur dalam semua tugas. Uji ini juga tidak dapat membuktikan bahwa mereka akan memakai strategi yang sama dalam percakapan yang lebih panjang, saat ditanya lebih lanjut, atau saat pengguna secara eksplisit meminta masukan. Uji ini bukan pengganti studi preferensi manusia berskala besar. Skor aturan pada 12 situasi tidak bisa langsung menjadi “skor EQ” umum. Halaman itu sudah menyebut bahwa selisih skor tertinggi dan terendah hanya 1,3 poin, dan selisih itu sebaiknya dibaca sebagai perbedaan gaya, bukan sebagai peringkat kemampuan yang stabil.
Kesimpulan yang lebih tepat adalah: model sudah mampu menghasilkan pujian yang wajar dan bernuansa hubungan, tetapi ketika pujian dan fakta bertentangan, evaluasi masih membutuhkan penggaris yang lebih halus. Benar-benar pandai bicara bukan hanya soal berbicara dengan lembut, spesifik, dan enak didengar. Itu juga berarti tidak diam-diam menghapus fakta yang tidak sempurna. Bagi keluarga, “dagingnya empuk sekali, rasanya sedikit lebih asin, lain kali garamnya dikurangi sedikit” mungkin tidak semeriah “sudah layak buka restoran”. Namun, kalimat itu lebih terdengar seperti ucapan yang bisa dipercaya di meja makan sungguhan.
Sumber
Artikel ini hanya menganalisis hasil V1 yang saat ini dipublikasikan di halaman tersebut.


