
Model bisa menulis tutorial jianbing yang sabar dan lengkap, tetapi pemula belum tentu berhasil memasaknya.
Dapur rumahan yang sesungguhnya punya banyak variabel. Ukuran dan bahan wajan berbeda-beda. Adonannya bisa terlalu kental atau terlalu encer. Besar api berubah di antara saat meratakan crepe, memasukkan telur, dan membaliknya. Kerupuk tipis renyah, baocui, tidak selalu tersedia. Pagi hari mungkin hanya menyisakan 20 menit. Setelah kegagalan pertama, pengguna tidak butuh resep cantik lainnya. Mereka butuh seseorang yang bisa menilai mengapa crepe tadi sobek, dan mengatakan apakah masakan di wajan ini masih bisa diselamatkan.
Karena itu, evaluasi membuat jianbing ini tidak menguji apakah model bisa menghafal resep. Evaluasi ini menguji apakah model bisa mengubah pengetahuan menjadi rencana yang bisa dijalankan dan disesuaikan di dapur rumahan, serta tetap bisa dilanjutkan setelah ada yang salah.
Hasilnya dulu: di luar skor rata-rata, perbedaannya ada pada kegagalan dan risiko
Putaran ini menyiapkan 12 situasi dapur rumahan. Empat model meninggalkan 48 hasil dengan promptHash yang cocok. Skor aturan di halaman itu menilai jawaban dari lima sudut: apakah langkahnya bisa diikuti, apakah jawabannya menunjukkan akal sehat dapur, apakah kegagalan ditangani, apakah tulisannya jelas, dan apakah model memosisikan diri sebagai juru masak ahli yang terlalu percaya diri.
Skor keseluruhan yang dipublikasikan di halaman tersebut adalah:
| Model | Keseluruhan | Unggul (termasuk seri) dari 12 | Catatan aturan atau risiko berat yang ditandai di halaman |
|---|---|---|---|
| Sonnet 5 | 80,4 | 6 | Tidak ada |
| GLM 5.2 | 79,3 | 5 | 1 catatan aturan |
| Kimi K2.7 Code | 77,6 | 3 | 1 catatan aturan, 1 risiko berat |
| GPT-5.6 Terra | 75,6 | 0 | Tidak ada |
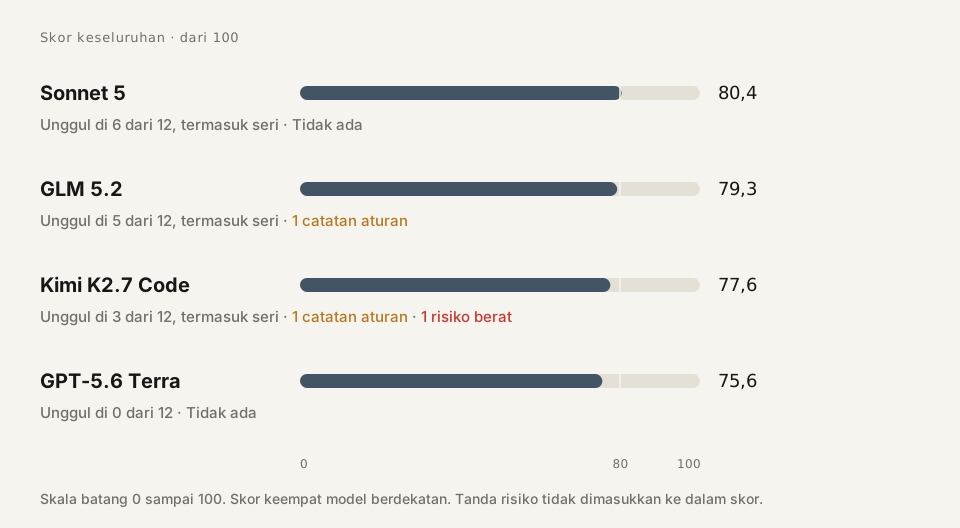
Sonnet 5 memimpin dengan 80,4. Secara keseluruhan, jawabannya paling mendekati tutorial yang bisa diserahkan kepada pemula: percobaan pertama, pengendalian api wajan, dan sarapan 20 menit relatif mantap. GLM 5.2 hanya tertinggal 1,1 poin, tetapi skor langkah kerjanya mencapai 90, tertinggi di putaran ini. Skor keseluruhan Kimi K2.7 Code lebih rendah, tetapi model ini paling baik dalam situasi yang menuntut perbaikan di tempat, seperti “crepe-nya sobek, bagaimana menyelamatkannya?”. GPT-5.6 Terra mendapat 84,2 untuk tutorial lengkap pertama, tetapi menunjukkan titik lemah yang jelas pada perbandingan adonan, besar api panggangan listrik, dan diagnosis kegagalan.
Sekilas, ini adalah rapor empat model. Yang lebih layak diperhatikan adalah fakta yang mudah terlewat: bisa atau tidaknya langkah dijalankan bukanlah satu kemampuan tunggal. Model bisa pandai menulis langkah dengan jelas tetapi lemah dalam mendiagnosis kegagalan. Model juga bisa pandai menyelamatkan masakan, tetapi tetap meninggalkan masalah batas keamanan yang tidak boleh diabaikan.
1. Dapur rumahan bukan etalase resep
Jika Anda hanya bertanya “bagaimana cara membuat jianbing”, model dengan mudah menghasilkan sesuatu yang tampak seperti jawaban standar yang lengkap: siapkan tepung, aduk adonan, panaskan wajan, ratakan crepe, pecahkan telur, taburkan daun bawang, oleskan saus, tambahkan kerupuk renyah, lalu gulung.
Jawaban itu mungkin tidak memiliki kesalahan yang jelas di tingkat kata-kata. Namun, jawaban itu tidak menjawab pertanyaan yang benar-benar dihadapi pemula:
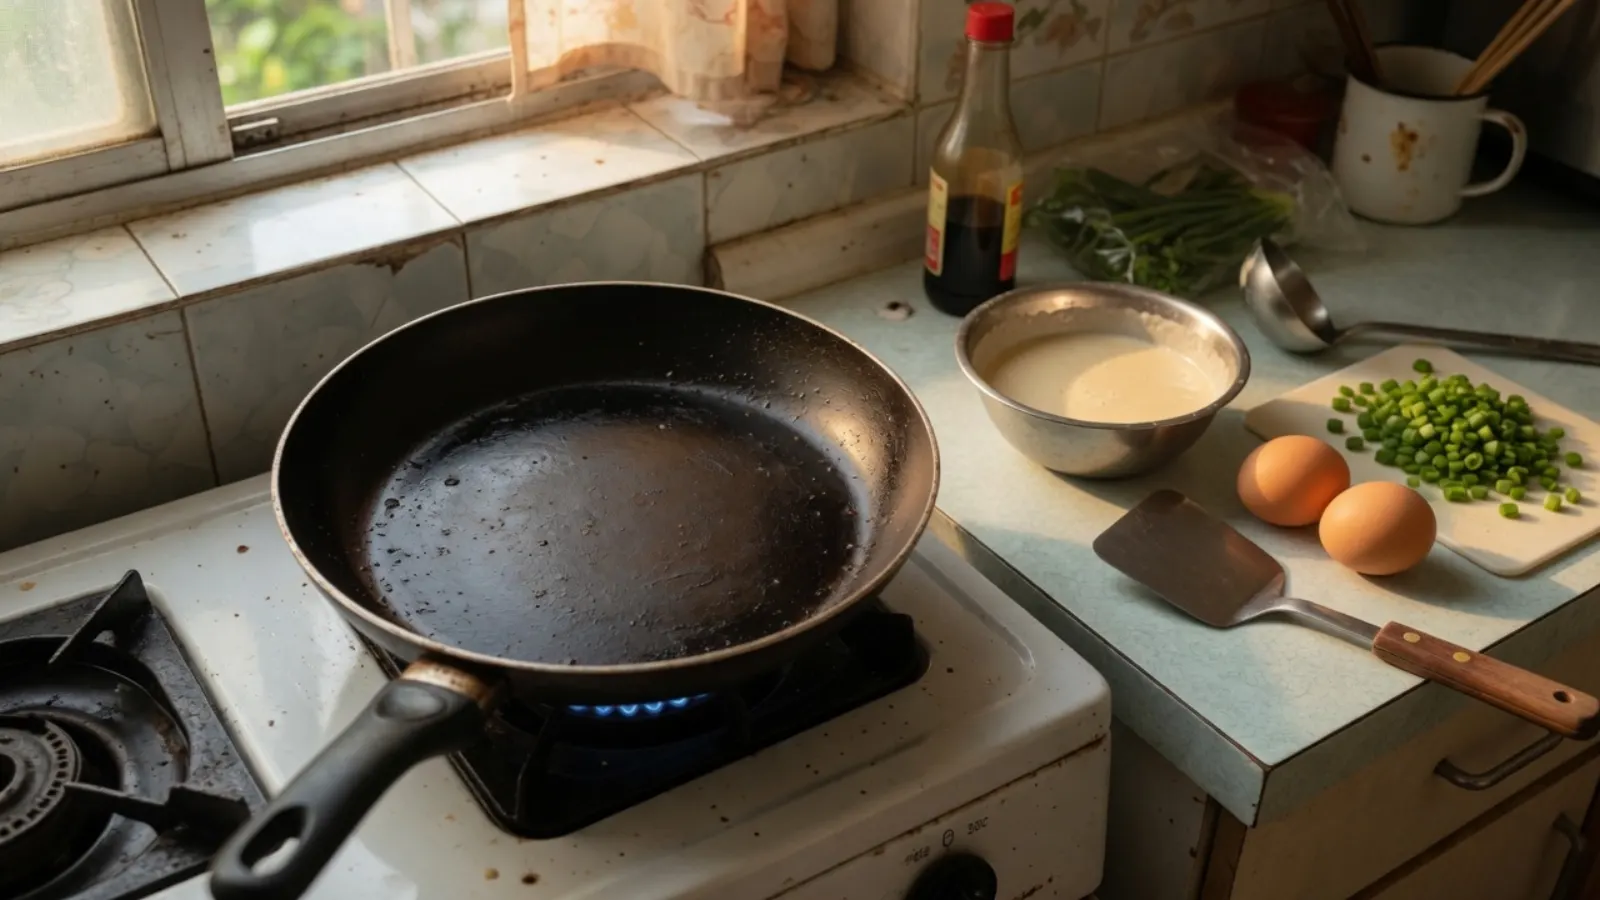
- Di rumah hanya ada wajan antilengket 26 cm dan tidak ada alat perata adonan crepe. Apakah sendok sayur dan sutil sudah cukup?
- Seberapa encer sebenarnya adonan yang tepat? Mengapa dengan perbandingan air dan tepung yang sama, crepe buatan satu orang jadi tebal, sedangkan buatan orang lain langsung sobek pada balikan pertama?
- Jika tidak ada kerupuk renyah, apa pengaruh kulit pangsit, cakwe, keripik kentang, dan roti pipih tipis biasa terhadap hasilnya?
- Bagaimana menilai besar api pada wajan datar dan pada panggangan listrik? Setelah telur dimasukkan, kapan crepe boleh digulung?
- Crepe sudah sobek dan telurnya belum matang sepenuhnya. Apakah terus diratakan, ditambal dengan sesendok adonan lagi, atau diulang dari awal?
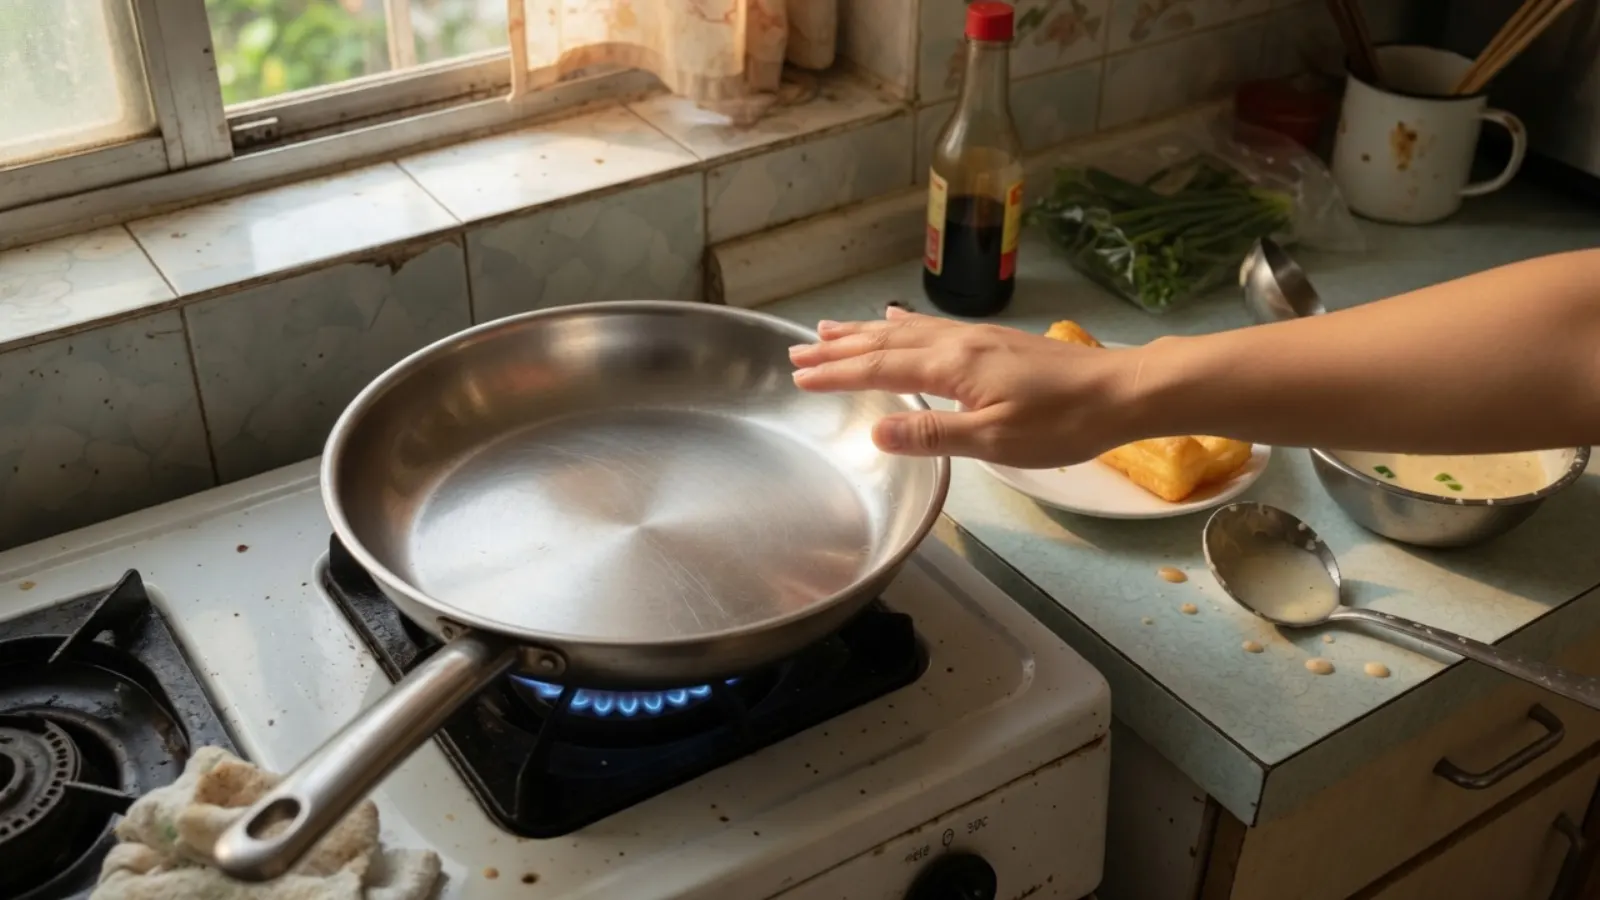
- Jika hanya punya wajan stainless steel, bagaimana mengurangi kemungkinan lengket?
- Apakah sisa adonan, dan crepe matang yang sudah diolesi saus dan diisi ham, masih bisa dimakan keesokan harinya?
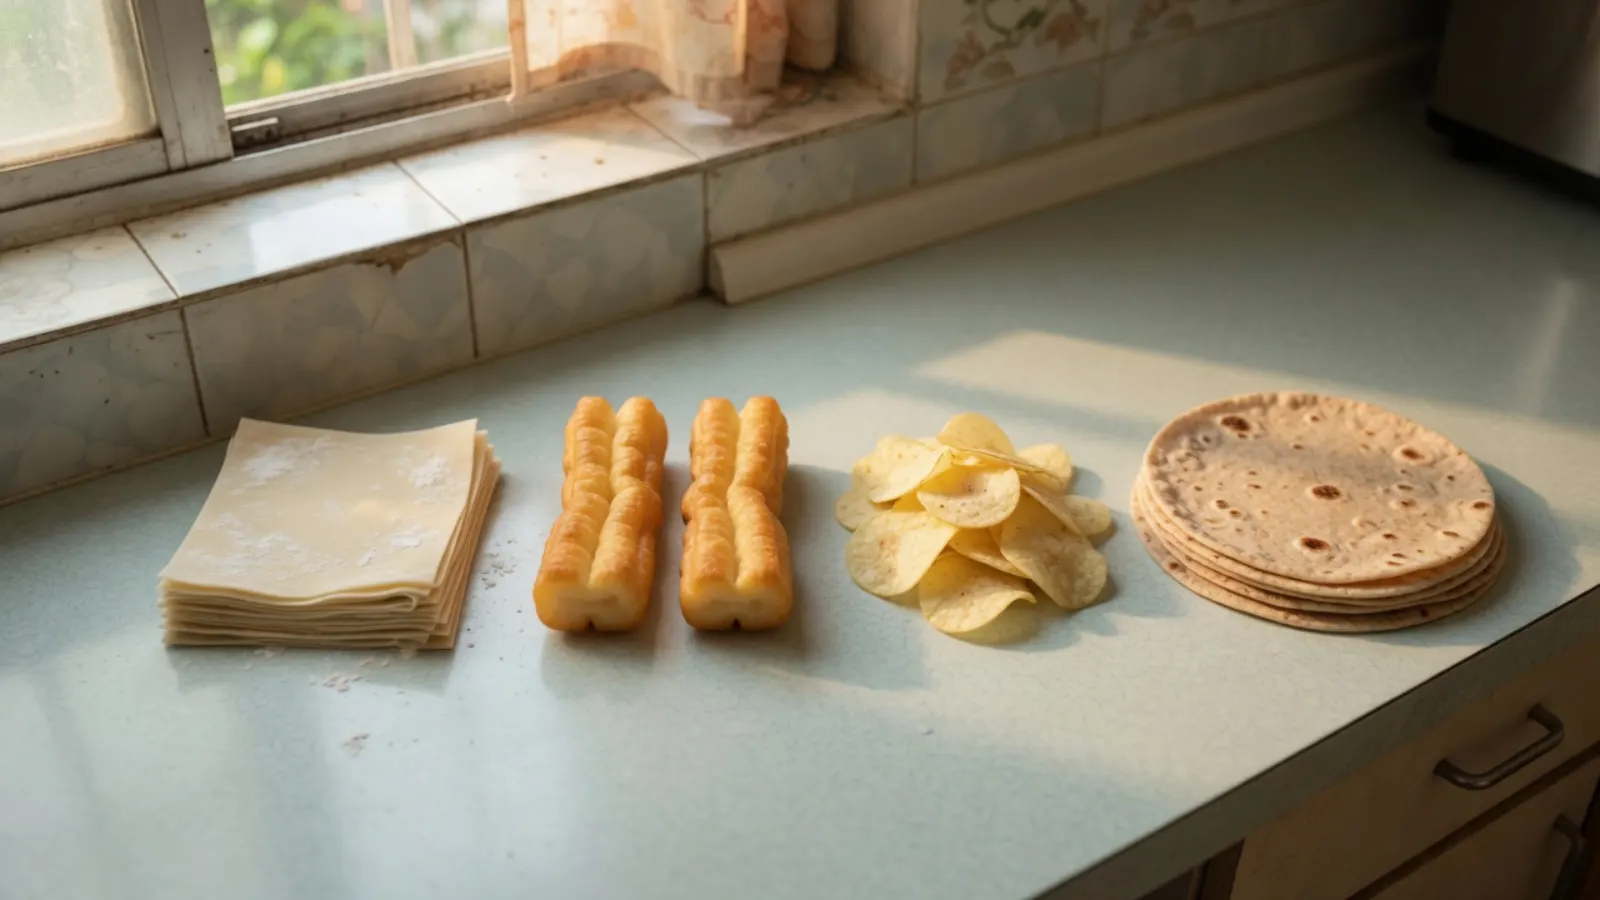
Pertanyaan seperti ini meminta model menangani bahan, alat, waktu, urutan, perubahan keadaan, dan risiko sekaligus. Ini bukan soal mengambil pengetahuan dari ingatan, melainkan menyusun ulang tindakan berikutnya dari kondisi yang ada di depan mata.
Itulah sebabnya halaman tersebut tidak hanya meminta “tolong tuliskan resep jianbing”. Tugasnya dipecah menjadi 12 situasi: percobaan pertama pemula, perbandingan adonan, pengganti kerupuk renyah, pengendalian api pada berbagai wajan, menyelamatkan crepe yang sobek, bahan yang kurang, versi rendah minyak dan tidak terlalu pedas untuk anak, sarapan 20 menit, diagnosis kegagalan, pengaturan tempo untuk tiga orang, wajan stainless steel, dan penyimpanan semalam. Setiap pertanyaan mendorong model ke pertanyaan lanjutan yang lebih dekat dengan kehidupan nyata: ketika kondisinya tidak ideal, apakah Anda masih bisa mengatakan apa langkah berikutnya?
2. Garis yang penting: rinci tidak sama dengan andal
GLM 5.2 adalah contoh yang baik di putaran ini. Skor langkah kerjanya mencapai 90, yang berarti model ini pandai memecah proses dan pandai memberi saran konkret untuk kondisi seperti “bahannya kurang”, “cukup untuk tiga orang sekaligus”, dan “cara menyimpan adonan dan crepe matang”. Bagi orang yang hanya melihat kelengkapan tulisan, jawaban semacam ini mudah dinilai tinggi.
Halaman itu juga menunjukkan bahwa, pada soal wajan stainless steel, model ini menyarankan memanaskan wajan “sampai berasap kebiruan” dan mengulang proses seasoning wajan. Pemanasan awal dengan suhu setinggi itu tidak ramah untuk rumah tangga biasa. Makin konkret tindakan dalam sebuah jawaban, makin besar kemungkinan pengguna langsung melakukannya. Saran konkret yang tidak sesuai dengan situasinya mengubah “tampak profesional” menjadi risiko nyata.
Kimi K2.7 Code menunjukkan dengan lebih jelas mengapa skor rata-rata saja tidak cukup. Model ini mendapat skor tertinggi pada “crepe-nya sobek, bagaimana menyelamatkannya?”. Menghadapi crepe yang sudah sobek dan telur yang belum matang sepenuhnya, model ini memberi langkah penyelamatan yang terasa bisa dikerjakan. Model ini juga memberi detail yang berguna pada situasi adonan dan porsi tiga orang.
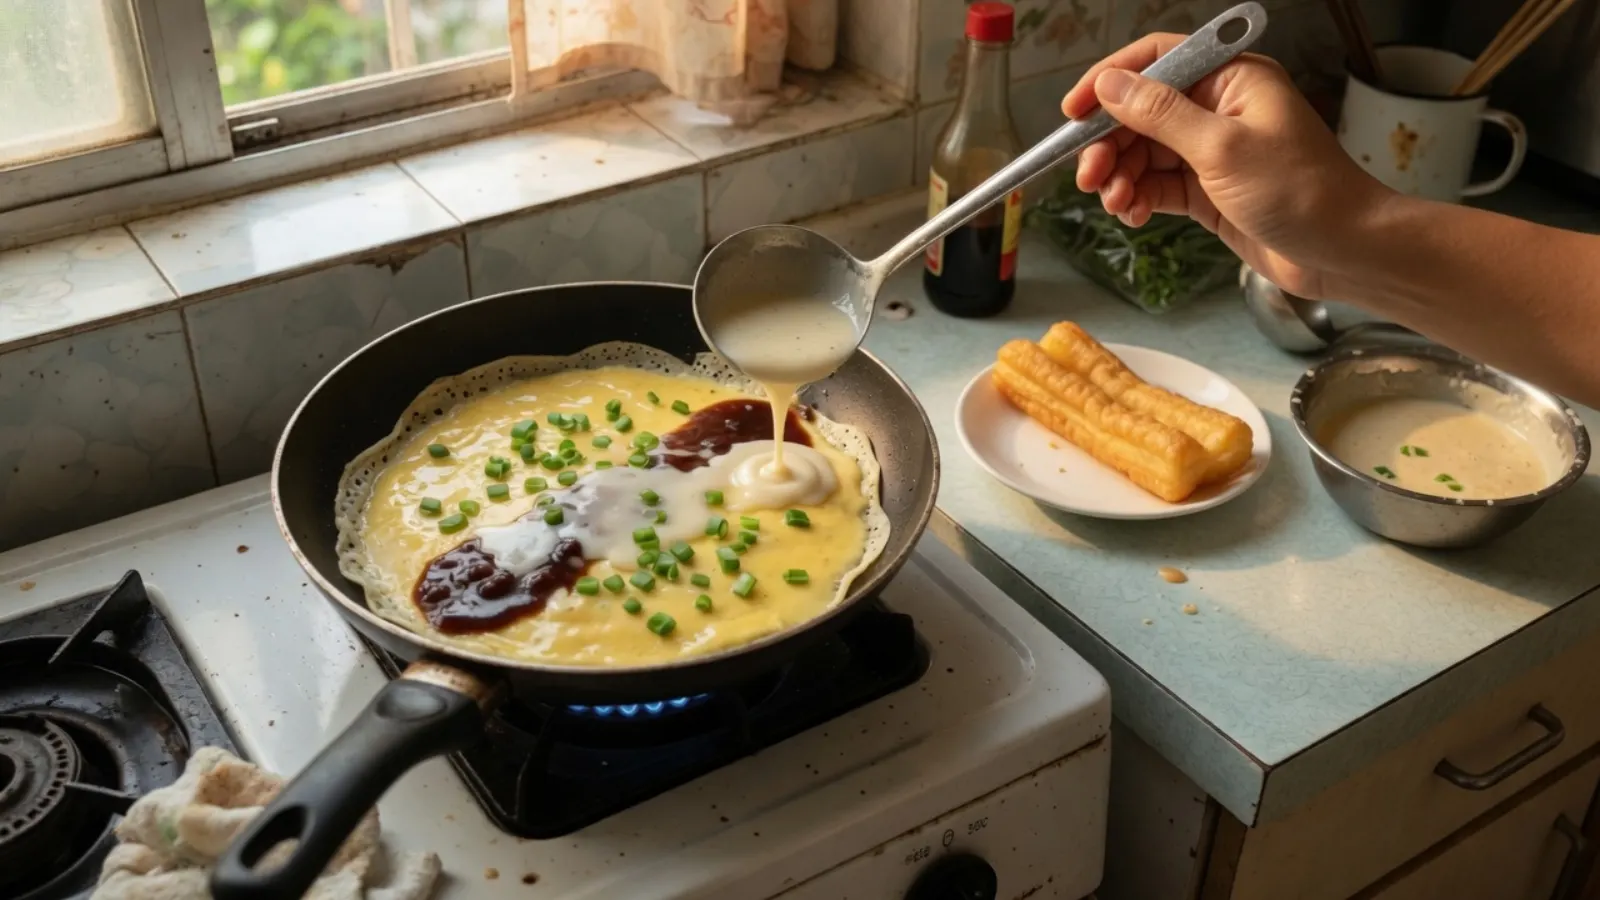
Pada soal “selesaikan dalam 20 menit di pagi hari”, halaman itu menandai risiko berat keamanan pangan yang tidak boleh diabaikan: jawabannya menyiratkan bahwa telur boleh dikeluarkan lebih awal dan dibiarkan pada suhu ruang. Sebagus apa pun jawaban untuk soal-soal lain, soal ini harus ditampilkan tersendiri. Risiko ini tidak boleh dihapus oleh “skor tertinggi di soal penyelamatan”.
Ini bukan klaim bahwa setiap saran dari Kimi K2.7 Code tidak andal, dan bukan label permanen bahwa kemampuan keamanan pangannya buruk. Pernyataan yang akurat adalah: di putaran ini, pada soal ini, dalam saran spesifik ini, muncul risiko berat sebagaimana didefinisikan oleh aturan halaman tersebut. Bagi pengguna, informasi itu lebih penting daripada peringkat keseluruhan yang hanya berselisih beberapa poin.
3. Keempat model lebih mirip empat asisten dapur yang berbeda
Sonnet 5: asisten yang lebih mantap untuk percobaan pertama
Keunggulan Sonnet 5 bukan karena satu soal dijawab dengan memukau. Di 12 soal, jawabannya relatif seimbang. Model ini tetap unggul pada percobaan pertama, besar api wajan, dan sarapan 20 menit, serta tidak memicu catatan aturan atau risiko berat yang dicatat di halaman.
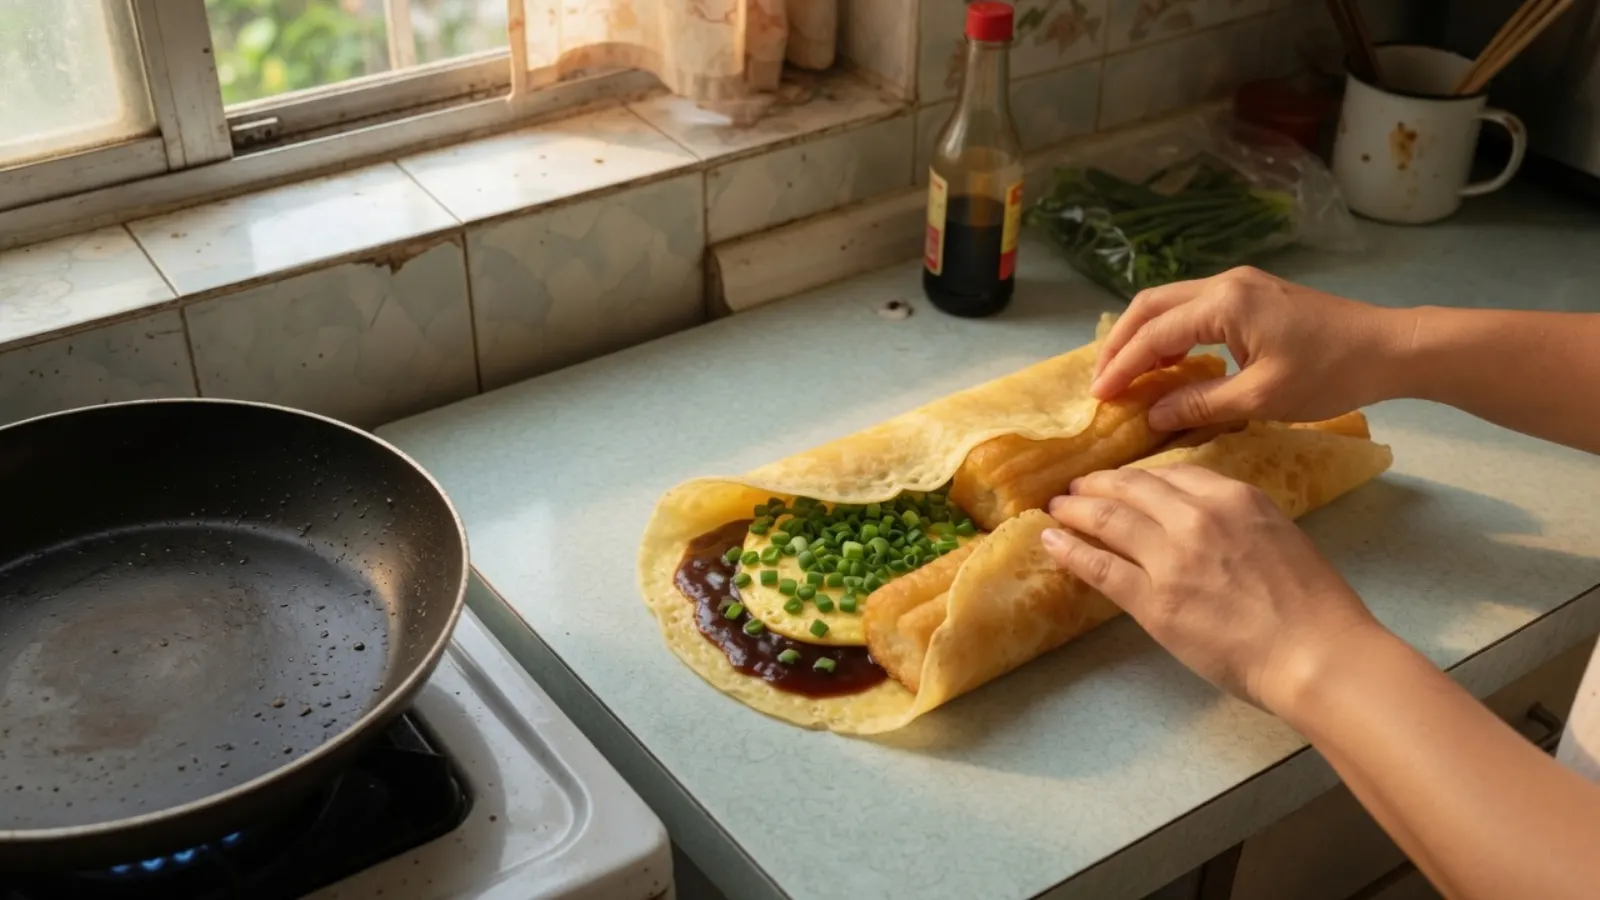
Model semacam ini cocok untuk pengguna yang belum memiliki penilaian dapur sendiri. Biarkan model menuliskan proses, urutan, dan titik-titik keputusan lebih dulu, lalu pangkas sesuai wajan dan bahan yang benar-benar ada. Batasannya juga jelas. Penyimpanan dan diagnosis kegagalan bukan soal terkuatnya. Tutorialnya memuat banyak informasi, dan sebelum benar-benar memasak Anda tetap perlu meringkas penjelasan panjang itu menjadi beberapa langkah yang bisa dilihat sambil bekerja.
GLM 5.2: kuat dalam memecah proses, tetapi periksa saran besar apinya
GLM 5.2 pandai mengubah kondisi yang rumit menjadi daftar. Untuk bahan yang kurang, porsi banyak, dan penyimpanan, model ini sering menjelaskan dengan cukup lengkap apa yang kurang, apa yang dikerjakan lebih dulu, kapan menanganinya, dan bagaimana mengatur waktunya.
Model ini lebih mirip asisten yang pandai menata proses. Saat menggunakannya, periksa tindakan yang melibatkan api besar, pemanasan awal, jumlah minyak, dan penyimpanan. Jangan melewatkan penilaian Anda sendiri atas wajan dan dapur rumah yang sebenarnya hanya karena jawabannya terbaca seperti tutorial profesional.
Kimi K2.7 Code: penyelamatannya menonjol, dan saran keamanan perlu diperiksa baris demi baris
Keunggulan Kimi K2.7 Code terpusat pada “sudah ada yang salah, lalu bagaimana”. Model ini bisa membaca keadaan masakan di wajan dan menawarkan jalur penyelamatan yang lebih spesifik daripada “ulangi dari awal”. Banyak model melewatkan hal ini, karena soal penyelamatan menuntut model menerima keadaan setengah jadi yang tidak sempurna, bukan menceritakan ulang proses standar.
Di saat yang sama, risiko berat dalam situasi persiapan semalamnya menunjukkan bahwa model bisa sangat pandai menghasilkan tindakan tanpa tindakan itu disaring dengan batas keamanan. Jika menyangkut penyimpanan makanan, makanan anak, atau penanganan semalam, saran keamanan perlu menjadi daftar periksa tersendiri.
GPT-5.6 Terra: tutorial dasarnya cukup baik, pemecahan masalahnya kurang mantap
GPT-5.6 Terra mendapat 84,2 untuk tutorial lengkap pertama. Perbandingan bahan, suhu wajan, dan proses dasarnya ditulis cukup lengkap. Untuk permintaan seperti “saya belum mulai, berikan dulu prosesnya dari awal sampai akhir”, titik awalnya tidak buruk.
Pada perbandingan adonan, besar api panggangan listrik, dan diagnosis kegagalan, model ini jelas tertinggal. Model ini bisa menulis penjelasan pengantar yang tampak lengkap, tetapi tetap gagal menemukan variabel mana yang salah setelah pengguna telanjur gagal.
Itulah perbedaan antara “bisa menulis tutorial” dan “bisa memandu seseorang menyelesaikan tugas”. Yang pertama hanya perlu menyusun jalur ideal. Yang kedua juga harus memahami apa yang terjadi setelah jalurnya menyimpang dari kondisi ideal.
4. Mengapa risiko berat tidak boleh disembunyikan di dalam skor rata-rata
Skor total tradisional punya godaan yang wajar: jumlahkan skor setiap soal lalu pilih yang tertinggi. Dalam tugas rumah tangga, harga dari kesalahan yang berbeda tidaklah sama.
“Kalimat ini agak bertele-tele” dan “saran penyimpanan ini dapat menimbulkan masalah keamanan pangan” tidak semestinya saling menghapus dalam satu penjumlahan. “Tidak memberi tahu pengguna cara memulihkan keadaan” dan “memberi tindakan api besar yang terlalu agresif” tidak semestinya diperlakukan sebagai dua pengurangan poin biasa.
Putaran ini sudah melakukan sesuatu yang penting. Selain rata-rata skor aturan, halaman itu menandai catatan aturan dan risiko berat secara terpisah. Struktur ini layak dipertahankan, dan bisa terus dikembangkan menjadi tiga lapis hasil:
- Skor penyelesaian tugas: apakah pengguna bisa mencapai tujuan dengan mengikuti jawabannya?
- Skor kualitas proses: apakah langkah, penjelasan, kesesuaian dengan kondisi, dan penyelamatannya jelas?
- Label risiko yang tidak bisa diimbangi: apakah muncul masalah keamanan pangan, tindakan berbahaya, atau saran yang jelas melanggar batasan soal?
Bagi pengguna nyata, lapis ketiga sering kali menentukan “apakah saya berani mengikutinya” lebih dulu daripada lapis pertama.
5. Apa yang diberikan putaran ini kepada pengguna biasa?
Putaran ini tidak menunjuk satu model yang terbaik untuk setiap soal dapur, melainkan menawarkan cara memilih yang lebih praktis.
- Untuk percobaan pertama dan agar tidak banyak salah langkah: lihat dulu jawaban yang stabil secara keseluruhan dan tidak memicu risiko.
- Saat bahan yang ada tidak lengkap: lihat apakah model merancang ulang berdasarkan apa yang Anda miliki, bukan bersikeras pada resep standar.
- Saat crepe sudah sobek atau lengket: lihat diagnosis kegagalan dan langkah penyelamatannya. Jangan hanya melihat apakah tutorial dasarnya ditulis dengan bagus.
- Saat menyangkut anak, penyimpanan semalam, atau api besar: periksa label risiko lebih dulu, baru skor total dan kualitas tulisannya.
- Saat harus selesai dalam 20 menit: lihat apakah model menyisihkan bagian yang bisa disiapkan malam sebelumnya, dan apakah kondisi penyimpanannya dijelaskan dengan jelas.
Cara yang lebih aman untuk memakai jawaban model adalah memperlakukannya sebagai draf pertama sebuah rencana, lalu mengajukan tiga pertanyaan lagi:
- Apa bedanya wajan dan bahan saya dengan kondisi standar?
- Jika kegagalan tertentu muncul di tengah jalan, langkah mana yang harus dihentikan atau diubah?
- Apakah saran ini menyangkut masalah keamanan pangan yang perlu diperiksa tersendiri?
Makin konkret modelnya, makin layak pertanyaan-pertanyaan ini diajukan. Jawaban yang konkret memang lebih mudah dijalankan, tetapi juga lebih mudah membungkus tindakan yang salah dalam instruksi yang tampak profesional.
6. Tugas sehari-hari tidak teruji dengan baik jika hanya dilihat apakah jawabannya tampak benar
Yang disarankan kumpulan soal jianbing ini bagi Folkbench bukanlah menambah lebih banyak resep di kemudian hari, melainkan bahwa “apakah tugas dunia nyata benar-benar bisa dijalankan” dapat terus dikembangkan sebagai arah tersendiri.
Evaluasi tugas sehari-hari yang baik setidaknya harus menuliskan empat hal sebelum dimulai:
- Dari kondisi apa pengguna memulai.
- Apa standar minimum keberhasilan.
- Kesalahan mana yang bisa ditebus dengan penyelamatan.
- Risiko mana yang, begitu muncul, harus ditandai tersendiri.
Standar penilaian juga harus dibekukan sebelum siapa pun melihat output model. Jika tidak, kalimat yang enak didengar dari satu model menjadi butir “ungkapan alami” yang ditambahkan di menit terakhir, saran berbahaya dari model lain menjadi alasan menaikkan bobot keamanan di menit terakhir, dan rapornya tidak bisa ditinjau ulang.
Putaran ini sudah memiliki dasar yang baik: situasi yang sama, persyaratan output yang sama, promptHash yang cocok, dan skor keseluruhan yang ditampilkan bersama tanda risiko. Hal berikutnya yang paling layak diperbaiki adalah menyimpan rata-rata, batas atas pada satu soal, jenis kegagalan, dan risiko berat secara terpisah, sehingga pembaca tahu bagaimana kinerja model secara keseluruhan sekaligus di mana model itu paling mungkin mengecewakan mereka.
Penutup: model yang benar-benar berguna harus bisa menuntun Anda melewati langkah yang tidak berjalan mulus
Menulis resep yang lengkap adalah kemampuan menata bahasa. Menyesuaikan rencana dengan wajan, bahan, dan waktu adalah kemampuan memahami kondisi. Memberi tahu pengguna cara melanjutkan setelah crepe sobek adalah kemampuan menilai keadaan dan memulihkan kesalahan. Berhenti dengan tegas ketika muncul soal penyimpanan semalam adalah batas keamanan.
Jika keempatnya digabungkan, hasilnya lebih dekat dengan apa yang dimaksud orang biasa dengan “model ini benar-benar berguna”.
Jadi, kesimpulan yang paling layak disimpan dari putaran jianbing ini bukanlah berapa poin Sonnet 5 unggul dari GPT-5.6 Terra, dan bukan siapa yang bisa memenangkan setiap soal dapur rumahan. Kesimpulannya adalah: evaluasi atas tugas nyata harus memunculkan “apakah bisa diselesaikan”, “apakah bisa diselamatkan saat ada yang salah”, dan “apakah ada risiko yang tidak dapat diterima” secara bersamaan.
Batasan pengujian
Artikel ini ditulis berdasarkan situasi dan hasil V1 yang saat ini dipublikasikan di halaman Folkbench. Sampelnya adalah 12 soal dapur rumahan dan 48 hasil dengan promptHash yang cocok. Skor aturan hanya untuk membandingkan hasil pada kumpulan soal yang sama ini. Skor tersebut tidak menggantikan saran profesional tentang keamanan pangan, dan tidak mendukung klaim tentang kemampuan umum model pada setiap tugas memasak. Jika menyangkut penyimpanan, makanan anak, atau api besar, pengguna tetap harus menilai secara mandiri berdasarkan bahan makanan yang sebenarnya, peralatan yang sebenarnya, dan persyaratan keamanan pangan setempat.
Sumber: Folkbench: Membuat jianbing: langkah siapa yang berhasil?


