
Quand on demande à un modèle de gérer un conflit au travail, la question est souvent : « Mon patron m’a dit ça. Comment dois-je répondre ? »
Cela ressemble à un simple exercice de reformulation. C’est plutôt un problème à plusieurs objectifs qui tirent dans des sens opposés. Une réponse polie ne suffit pas. Le message doit faire plusieurs choses à la fois : il ne peut pas accepter en silence une accusation inexacte, il ne peut pas transformer l’échange en affrontement, il ne peut pas balayer la part dont on est réellement responsable, et il ne peut pas non plus endosser la responsabilité de tout le monde. Il doit en même temps poser les faits nécessaires, les délais et la prochaine étape, pour que le travail continue d’avancer.
Le test de Folkbench « Un patron sarcastique : qui sait répondre ? » mesure précisément cette capacité. Il ne demande pas au modèle des conseils génériques sur la manipulation au travail. Il propose 12 situations avec un contexte concret, un rapport hiérarchique et une contrainte de livraison, et demande une réponse qu’une personne ordinaire oserait vraiment envoyer sans aggraver la situation.
Ce n’est pas un test pour apprendre à remettre son patron à sa place
Les 12 situations couvrent plusieurs formes de pression bien connues : une remarque dans le groupe de discussion laissant entendre que vous avez « l’air bien détendu ces temps-ci » ; une question posée en public pour savoir si vous avez encore envie de ce poste ; un « vous auriez dû y penser plus tôt » après un résultat de projet décevant ; un changement de besoin jamais transmis, suivi d’une injonction à le relancer vous-même ; un plan resté vide faute d’éléments fournis en amont ; une contribution balayée d’un revers de main par le patron ; un « pas très au fait du dossier » lâché à votre sujet devant un client ; une évaluation qui se résume à « manque d’initiative » ; un « jetez juste un œil » le week-end ; une trace écrite après un changement de priorités de dernière minute ; et une négociation de planning derrière un « les jeunes, ça leur fait du bien d’en baver ».
Comment le test est mené
Quatre modèles ont reçu les mêmes situations de la version V1 actuelle et les mêmes consignes de sortie. La page ne conserve que les 48 résultats dont le promptHash correspond : 12 questions, quatre réponses chacune.
Le score par règles examine cinq points :
- La réponse peut-elle être envoyée telle quelle ?
- Protège-t-elle les faits et le périmètre de responsabilité de la personne qui écrit ?
- Aggrave-t-elle la situation ?
- A-t-elle le sens de la mesure ?
- La prochaine étape est-elle claire ?
La page consigne aussi les alertes de règle et les risques graves. Le score par règles sert uniquement à comparer les résultats sur ces 12 questions communes. Il ne signifie pas qu’un modèle possède une compétence générale en communication professionnelle, et ce n’est pas un conseil en droit du travail.
Le résultat : des moyennes proches, des profils différents
| Modèle | Moyenne (règles) | Questions en tête (ex aequo compris) | Risques graves | Alertes de règle |
|---|---|---|---|---|
| GPT-5.6 Sol | 74,3 | 5/12 | 0 | 0 |
| Kimi K2.7 Code | 72,5 | 4/12 | 0 | 1 |
| Opus 4.8 | 72,2 | 2/12 | 0 | 5 |
| GLM 5.2 | 70,2 | 2/12 | 0 | 6 |
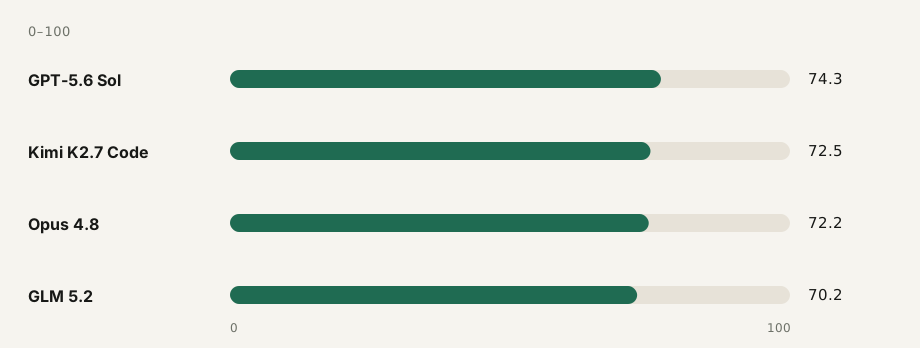
GPT-5.6 Sol ne devance le deuxième que de 1,8 point. Sur la page, il se classe pourtant premier des quatre sur « envoyable tel quel », sur la limite et sur la prochaine étape. Il convient aux situations où il faut expliciter les priorités, les horaires et les responsabilités.
Kimi K2.7 Code obtient 80,7 en compréhension de la situation, le meilleur score des quatre. Son score « prochaine étape » est de 58,3. Il lui arrive de bien cerner le problème sans pour autant fixer le responsable, l’échéance ou la confirmation.
Opus 4.8 obtient 70,3 en désamorçage, un peu au-dessus des autres, et il se distingue sur les questions de limites comme « jetez juste un œil ce week-end » et « les jeunes, ça leur fait du bien d’en baver ». La page relève aussi des formules d’ouverture stéréotypées sur 4 questions et un espace réservé non remplacé sur 1 question. Lisez toute la réponse avant de la copier.
GLM 5.2 sait bien énumérer les faits, les manques et les actions de suivi sur la question des éléments manquants et sur celle où il faut reconnaître une erreur dans le groupe de discussion. Six questions contiennent une formule du type « vous pourriez répondre ainsi », ce qui donne une impression de réponse type plus marquée.
Quatre situations, quatre problèmes professionnels
« Vous avez l’air bien détendu ces temps-ci » : ne pas accepter la mauvaise étiquette
L’utilisateur révise une proposition à remettre au client vendredi et n’a pas répondu à un message non urgent dans le groupe. Le patron lance : « Vous avez l’air bien détendu ces temps-ci. »
Sol ne rétorque pas « je ne suis pas détendu du tout ». Il explique que la personne est concentrée sur la révision, que la structure et les chiffres clés sont déjà vérifiés, que la première version est prévue pour 17 h et que les priorités peuvent changer si quelque chose de plus urgent se présente.
La réponse donne d’abord la raison concrète du retard de réponse, montre ensuite, par l’avancement et un horaire de livraison, que le travail progresse, puis ramène la conversation de « est-ce que vous vous relâchez » à « qu’est-ce qui est le plus urgent maintenant ». Elle n’accepte pas le jugement implicite contenu dans « détendu », et elle ne démasque pas publiquement le sarcasme du patron dans le groupe.
« Manque d’initiative » : transformer une étiquette floue en critère de comportement
Lors d’un entretien d’évaluation, le patron dit seulement : « Votre attitude est bonne, c’est juste que vous manquez un peu d’initiative. » Le formulaire dit la même chose : « manque d’initiative ». Le prochain cycle d’évaluation dure 6 semaines.
Kimi ne conteste pas immédiatement et ne se contente pas d’un vague « je vais faire des efforts ». Il demande ce que recouvre « initiative » ici : chercher une solution avant de faire remonter le problème, ou donner des nouvelles sans qu’on les demande ; manquer d’implication dans le travail entre équipes, ou ne pas demander de nouvelles missions. Il demande ensuite le niveau attendu et le niveau d’excellence pour le prochain cycle, afin que l’évaluation puisse s’appuyer sur chaque semaine ou sur chaque jalon de projet.
On passe ainsi d’une étiquette de personnalité, difficile à contester, à un critère de comportement que l’on peut illustrer, observer et passer en revue. La version de Sol va plus loin et propose un point hebdomadaire sur les risques, une solution de rechange quand un problème apparaît et un bilan à mi-parcours en semaine 3. Repérer un problème et faire avancer un problème sont deux compétences différentes.
« Pourquoi ce plan est-il encore si vide ? » : un périmètre de responsabilité se construit avec des faits
Il manque au plan de l’opération trois éléments que l’amont doit confirmer : le périmètre de l’opération, les données de conversion des 30 derniers jours et le plafond budgétaire. Le sommaire, le déroulé et les parties générales qui ne dépendent pas des données sont terminés, et la liste des éléments à fournir a été envoyée deux fois. Dans le groupe, le patron écrit : « Pourquoi ce plan est-il encore si vide ? Vous ne l’avez pas fait avancer assez énergiquement, non ? »
GLM obtient 81,4 sur cette question, le meilleur score des quatre. Il écrit ce qui est déjà fait, énumère les trois manques, rappelle les envois et relances précédents, puis propose un plan : un retour avant demain 17 h, et les éléments manquants complétés dans les deux jours ouvrés suivant leur réception. Si les éléments officiels ne peuvent pas encore être fournis, une fourchette ou une valeur provisoire suffit pour avancer sur des hypothèses explicites.
Ce type de réponse ne transforme pas « on ne m’a pas fourni les éléments » en reproche émotionnel. Il en fait une dépendance que l’équipe projet peut traiter ensemble. Un périmètre de responsabilité ne se construit pas en disant « ce n’est pas ma faute ». Il se construit à partir de ce qui a été fait, des dépendances et des délais.
« Les jeunes, ça leur fait du bien d’en baver » : ramener un jugement de valeur à une question de planning
L’utilisateur gère trois chantiers en même temps : la mise en ligne de la facturation des abonnements ce vendredi, un rapport d’activité à rendre mardi prochain, et des retouches de style sur le back-office, sans dépendance externe. Le patron lâche : « Les jeunes, ça leur fait du bien d’en baver. » L’utilisateur veut obtenir un planning raisonnable sans fermer la discussion.
Opus obtient 82,1 sur cette question, le meilleur score sur une seule question de toute la série. Il ne débat pas de la valeur du fait d’« en baver ». Il classe les trois chantiers par échéance : la facturation des abonnements d’abord, le rapport d’activité ensuite, et les retouches de style repoussées d’une semaine. Si ces retouches ont elles aussi une date impérative, l’ordre est revu.
Une réponse efficace ne réfute pas la phrase. Elle remplace « êtes-vous prêt à en baver » par « dans le temps dont nous disposons, quelles livraisons faut-il protéger en priorité ».
À quoi ressemble chacun des quatre modèles
GPT-5.6 Sol : une réponse fiable, tournée vers la livraison. Il aboutit généralement à des faits, des horaires et une prochaine étape. Les traces écrites, les échanges devant un client et la confirmation d’un planning sont relativement solides. La page note aussi que les réponses de Sol peuvent être longues. Dans un différend sur l’évaluation ou les responsabilités, l’utilisateur doit encore ajouter un critère plus clair, un responsable et une échéance.
Kimi K2.7 Code : il sait lire la situation, mais la boucle reste à vérifier. Il décèle bien la relation et la pression derrière une phrase, notamment lors d’un entretien d’évaluation ou d’une question de suivi en réunion. Avant de l’utiliser, vérifiez que le responsable, l’échéance et la confirmation sont bien écrits.
Opus 4.8 : il sait faire baisser la tension, mais il faut faire le ménage avant de copier. Il sait laisser à l’autre une porte de sortie, et il gère bien les questions de limites comme refuser un travail le week-end ou négocier un planning. Sa formulation est plus longue, et les traces de réponse type sont plus visibles. Supprimez les explications, les parenthèses et les espaces réservés, puis vérifiez que le message correspond à la relation réelle.
GLM 5.2 : fort pour les listes de contrôle, mais il faut gommer le ton professoral. Il sait découper une réponse en fait accompli, manque, responsable et prochaine étape, ce qui convient au suivi de projet et à l’analyse d’un retard. Le problème, c’est que la réponse et la note explicative sont souvent mélangées. Demandez-lui de ne produire que le texte à envoyer.
Un cadre en quatre étapes, réutilisable par tous
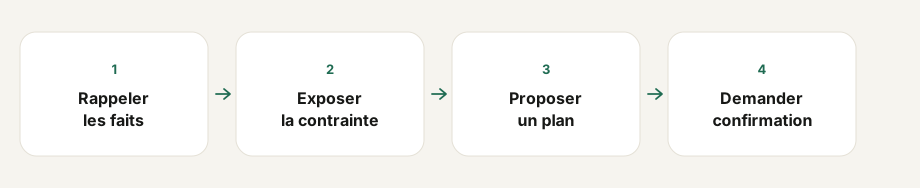
Quel que soit le modèle utilisé, une réponse professionnelle peut se construire dans cet ordre :
- Rappeler les faits. Écrivez ce que vous faites, ce qui est déjà terminé et quand le changement est intervenu.
- Assumer la part qui dépend de vous. Si le planning n’avait pas de marge, ou si le risque a été signalé trop tard, reconnaissez ce comportement précis. N’endossez pas toute la responsabilité dans une phrase vague.
- Formuler la limite comme un plan. Nommez la dépendance, la priorité, la livraison qui est décalée et la nouvelle échéance. Ne vous arrêtez pas à « ce n’est pas ma responsabilité ».
- Proposer la suite et demander confirmation. Dites qui fait quoi, pour quand, et comment le plan change si une condition évolue.
Le tout se résume en une ligne :
Rappeler les faits → Exposer la contrainte → Proposer un plan → Demander confirmation.
La sécurité du copier-coller devrait aussi être un critère d’évaluation
Un modèle peut bien juger la situation et produire malgré tout un texte qu’il ne faut pas envoyer. Le risque ne tient pas seulement à un fait erroné ou à un ton inadapté. Le message peut encore contenir « vous pourriez répondre ainsi », « voici pourquoi », un nom jamais remplacé, une note entre parenthèses, voire tout un paragraphe d’analyse destiné uniquement à l’utilisateur.
Une évaluation sur des tâches réelles doit distinguer au moins deux choses : le modèle a-t-il proposé une bonne manière de communiquer, et a-t-il séparé le message final de l’explication ? La première relève de la qualité du conseil. La seconde relève de la sécurité du copier-coller. Folkbench note séparément « peut-elle être envoyée telle quelle », parce que l’utilisateur n’a pas seulement besoin d’une réponse qui a l’air brillante. Il a besoin d’un texte de travail qu’il peut maîtriser, modifier et envoyer.
Les limites de cette série de résultats
Sur les 12 situations concrètes de la version V1 actuelle, les quatre modèles présentent des différences observables dans leur façon de traiter les faits, les limites, les relations et les prochaines étapes. Sol renvoie plus régulièrement une réponse directement utilisable. Kimi lit mieux la situation. Opus sait mieux faire baisser la tension et négocier une limite. GLM sait mieux faire avancer le travail sous forme de liste.
Cette série ne montre pas qu’un modèle est meilleur dans toutes les conversations professionnelles, ni qu’un modèle « comprend mieux les gens ». La taille de l’échantillon, les questions, les versions des modèles, les consignes de sortie et les règles de notation influent toutes sur le résultat. Sol ne devance Kimi que de 1,8 point, ce qui ne permet pas de conclure à une victoire écrasante. Le score par règles de la page n’est pas un avis en droit du travail. Une vraie décision touchant à l’évaluation, à une sanction, à la rémunération ou à un litige du travail ne peut pas reposer sur un seul message rédigé par un modèle.
Le titre « un patron sarcastique » peut facilement évoquer une leçon de répartie. Ce que le test mesure réellement est une capacité plus difficile : dans une relation inégale, ne pas se laisser enfermer dans une étiquette floue, ne pas pousser la conversation vers un conflit ouvert, et malgré tout laisser une trace, obtenir une confirmation et faire avancer le travail.


