Un seul échec peut prouver qu’un modèle s’est trompé. Il ne peut pas, à lui seul, prouver que le modèle échoue plus souvent qu’avant.
« Ce modèle a-t-il encore été nerfé ? » Un pélican dont un pied pend à côté de la pédale, un vélo dont le cadre est tordu comme une torsade, posés à côté d’une capture qui avait plutôt fière allure la semaine dernière : il n’en faut pas plus pour que la question surgisse.
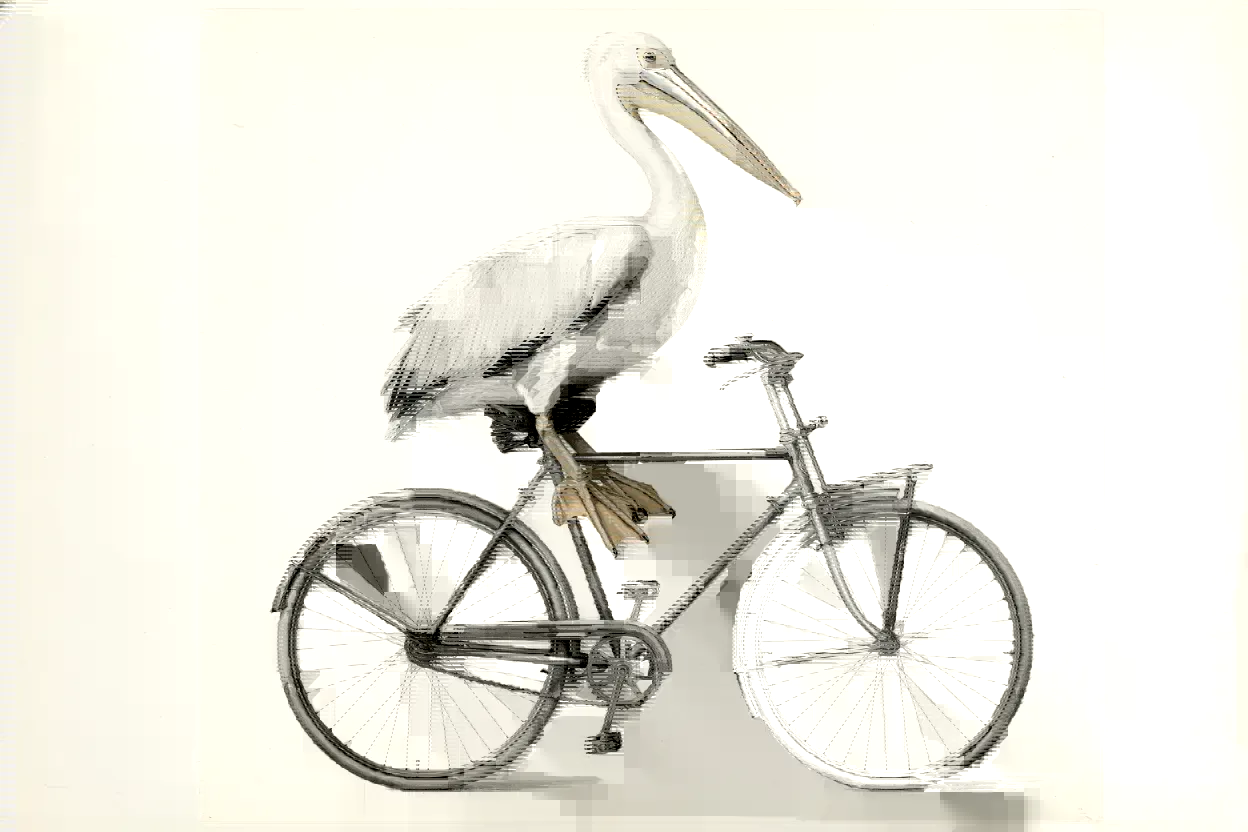
Ce soupçon ne mérite pas d’être balayé d’un « les modèles sont aléatoires ». Quelqu’un a payé pour une tâche que le service savait accomplir, et il n’y arrive plus : la question est légitime. Deux captures d’écran ne suffisent pas pour autant à montrer que le modèle a été remplacé, que le budget de raisonnement a été réduit ou qu’un service en particulier a été dilué.
Il y a quelque temps, j’ai lancé le test du pélican des dizaines de fois. Ce qui rend l’exercice utile, c’est que beaucoup de ses erreurs sont dessinées là où on peut les voir. Un code qui s’exécute ne garantit pas que la structure du vélo soit correcte. Un oiseau et un vélo bien présents ne garantissent pas que le pied repose vraiment sur la pédale. Ces relations spatiales se repèrent plus facilement à l’œil qu’une réponse fluide qui cacherait encore une faille logique. Plus j’accumulais les essais, plus un autre point devenait clair : nous jugeons souvent un service entier sur une seule production.
Cet article ne cherche à excuser aucun modèle, et il n’apprend pas à repérer un « faux modèle » à partir de quelques indices superficiels. La question qui m’intéresse est plus étroite. Quand nous soupçonnons un modèle de s’être dégradé, comment transformer cette impression en preuves que quelqu’un d’autre peut revérifier ?
Note : les services A et B ci-dessous, et tous les chiffres de test qui leur sont associés, sont des exemples pédagogiques. Ils ne renvoient à aucun service réel et ne constituent ni une mesure ni un classement de Folkbench.
1. D’abord, séparer les questions : qu’entendez-vous par « nerfé » ?
« Nerfé » est un mot commode, et il réunit plusieurs questions différentes en une seule. Le niveau le plus direct est le suivant : cette réponse précise est fausse. Le pélican a une patte en trop, le pied rate la pédale, ou les roues se sont détachées du cadre. Chacun de ces défauts est un échec concret, que l’on peut vérifier. Un seul échantillon suffit à prouver que « ce type d’erreur s’est produit », et suffit à démentir la promesse qu’« il ne ferait jamais ce type d’erreur ». Le deuxième niveau est le suivant : dans les mêmes conditions, ou dans des conditions assez proches, ce service échoue plus souvent.
La question n’est plus de savoir si l’erreur existe, mais à quelle fréquence elle apparaît. Ce qui mérite le plus d’être mesuré dans « l’expérience s’est dégradée », c’est le passage de « ça marchait la plupart du temps » à « ça ne marche plus la plupart du temps ». Le troisième niveau est le suivant : le changement a été causé par une modification du modèle lui-même, ou de la configuration côté serveur. On entre là dans une affirmation sur la cause. Un même mauvais résultat peut avoir des explications différentes : des paramètres de requête différents, un contexte différent, une sortie tronquée, ou un vrai changement du modèle sous-jacent et des réglages d’inférence. Le résultat seul ne permet généralement pas de retenir une seule de ces explications.
Ainsi, « cette réponse était fausse », « ce service est moins fiable » et « ce service a discrètement changé de modèle » n’appellent pas des preuves de même force. Reconnaître cette différence ne relève pas la barre pour la plainte d’un utilisateur. C’est l’inverse. Poser clairement la question empêche un prestataire d’expliquer chaque échec par « le hasard », et empêche un évaluateur d’expliquer chaque différence par « ils ont changé de modèle ».
2. Regardez-vous une seule production, ou une distribution de sorties ?
Avec un réglage de génération qui échantillonne au hasard, une même entrée peut produire des sorties différentes. Même avec un mécanisme destiné à améliorer la reproductibilité, « aussi cohérent que possible » ne doit pas se lire comme « identique à chaque fois ». Une ancienne note technique d’OpenAI le disait explicitement : avec le même seed, les mêmes paramètres et la même empreinte de backend, la sortie n’est toujours pas garantie identique. C’est une limite de la reproductibilité. Cela ne signifie pas que tous les modèles actuels acceptent les mêmes paramètres1.
Pour le test du pélican, ce que nous voulons généralement savoir n’est pas « peut-il de temps en temps dessiner une belle image ? », mais « dans les conditions que j’ai fixées, si je lui confie la tâche une fois de plus, quelle est la probabilité d’obtenir un résultat conforme ? ». Un exemple simplifié montre le problème d’une capture unique. Supposons que le vrai taux de conformité d’un service, pour un essai, soit de 80 %, que chaque génération soit indépendante et que son état ne change pas pendant le test. La probabilité d’au moins un échec sur 20 essais consécutifs est : 1 − 0.8²⁰ ≈ 98.85%. Autrement dit, un service qui fait bien le travail la plupart du temps laissera presque à coup sûr, quelque part dans ces 20 essais, un échec bon à capturer.
Inversons la situation. Supposons que le vrai taux de conformité d’un autre service, pour un essai, ne soit que de 40 %. Sous les mêmes hypothèses d’indépendance et de stabilité, la probabilité d’obtenir au moins un résultat conforme sur 20 essais est : 1 − 0.6²⁰ ≈ 99.996%. Lui aussi produira presque à coup sûr une production à brandir. Ces deux calculs ne disent pas que chaque appel réel est indépendant, ni que les vrais taux de conformité valent exactement ces chiffres. Ils mettent en évidence un problème de sélection : ne montrer que le meilleur essai conduit facilement à surestimer la fiabilité, et ne montrer que le pire conduit facilement à exagérer un déclin.
Le même service peut donc apparaître dans un post qui brandit une image comme preuve qu’il tourne à pleine puissance, et dans un autre qui brandit une image comme preuve qu’il a été nerfé. Les deux captures peuvent être authentiques. Le raisonnement qu’on en tire, lui, ne tient pas forcément. Il y a une autre distinction facile à négliger. Réussir dès la première génération, et générer dix fois puis choisir la réussite, ne relèvent pas de la même capacité. La seconde inclut des appels supplémentaires, de l’attente et le coût de la sélection. Si vous comparez deux façons de travailler, donnez aux deux le même budget d’essais. Ne comparez pas le premier essai de A avec le meilleur résultat trié sur le volet de B.
3. Vingt essais suffisent-ils à rendre une différence statistiquement significative ?
Non. Vingt essais peuvent constituer un budget expérimental raisonnable. Ce n’est pas un permis statistique. Reprenons un exemple concret. Le canal A est lancé 20 fois et produit 16 résultats conformes. Le canal B est lancé 20 fois et en produit 8. Les deux utilisent une même tâche fixe et la même règle de notation, et tous les échantillons sont conservés.
| Canal | Conformes / total | Taux observé | Intervalle de Wilson à 95 % du taux |
|---|---|---|---|
| A | 16 / 20 | 80 % | 58,4–91,9 % |
| B | 8 / 20 | 40 % | 21,9–61,3 % |
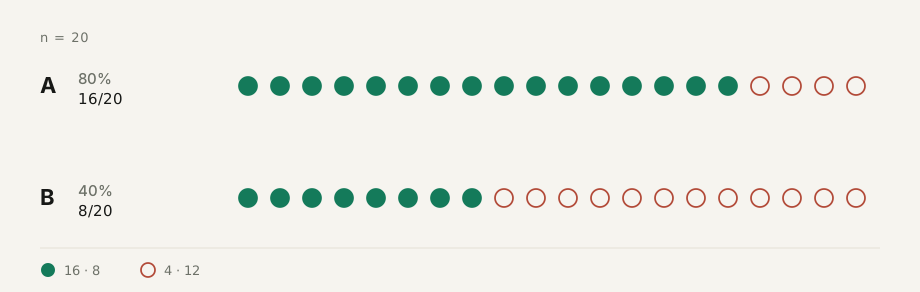
Les intervalles sont des intervalles de Wilson bilatéraux à 95 % pour une proportion binomiale. Ils expriment l’incertitude sur le taux de conformité estimé. Ce n’est pas une fourchette de notes pour la qualité de l’image2. La différence observée dans l’échantillon est de 40 points de pourcentage. Avec seulement 20 essais de chaque côté, l’estimation reste grossière. Il ne faut pas traiter 80 % et 40 % comme une capacité réelle mesurée avec exactitude et appelée à ne jamais bouger.
Si l’on suppose en outre que les appels sont indépendants, que la probabilité de conformité de chaque canal est stable dans la fenêtre et que cette comparaison a été choisie à l’avance, un test exact de Fisher bilatéral sur les effectifs conformes / non conformes donne p ≈ 0.0225. Au seuil de significativité de 5 % fixé au préalable, cet exemple soutient l’idée que « les taux de conformité diffèrent dans ces conditions »3. Ce chiffre ne signifie pas « 97,75 % de chances que B ait été dilué », ni « 97,75 % de chances que A soit meilleur pour toujours ». Une valeur p est la probabilité d’obtenir des données aussi extrêmes, ou plus extrêmes, sous l’hypothèse d’absence de différence et dans les conditions du test. Ce n’est pas la probabilité d’une cause cachée3.
Ne remplacez pas un test de la différence par un coup d’œil au chevauchement des deux intervalles. Chaque intervalle estime un taux. Le test porte sur la différence entre les deux. Trois limites comptent davantage que la mémorisation d’un test en particulier. Regardez ensemble l’ampleur de l’écart et la taille de l’échantillon. 16 contre 8 ne doit pas fonder une conclusion aussi forte que 16 contre 15. Le nombre d’échantillons nécessaire dépend de la taille de l’écart que vous espérez détecter, et du risque d’erreur de jugement que vous êtes prêt à accepter. Aucune règle du type « lancez-le au moins tant de fois » ne vaut pour toutes les tâches.
Ne pas trouver de différence significative ne prouve pas que les deux sont identiques. Les données peuvent simplement être trop peu nombreuses, ou trop instables, pour permettre une conclusion à ce stade. Pour montrer qu’une différence est assez petite pour être ignorée, définissez à l’avance ce que « assez petite » veut dire. Un résultat non significatif n’est pas une preuve d’équivalence. Une différence statistique n’est pas, à elle seule, une raison de changer de service. L’utilisateur doit encore peser le coût d’un échec, le prix d’un appel, la latence et le coût de refaire le travail. Une différence peut être réelle et rester trop petite pour changer le choix. Le rôle des statistiques ici n’est pas de produire une valeur p d’allure professionnelle. Il est de nous empêcher d’affirmer plus que ce que les preuves peuvent porter.
4. Une baseline est un contrat expérimental, pas la phrase « le prompt était le même »
Beaucoup de comparaisons échouent avant même que la taille de l’échantillon ne pose problème : les échantillons n’étaient pas comparables dès le départ. On demande aux deux côtés de « dessiner un pélican à vélo ». D’un côté, une requête API dans une session neuve. De l’autre, une fenêtre de chat qui compte déjà des dizaines d’échanges, avec des outils activés. Un côté peut écrire une longue sortie, l’autre atteint une limite de longueur à mi-parcours. Répéter cela cent fois ne permet toujours pas d’attribuer le résultat à une différence de capacité du modèle.
Les travaux sur le standard d’évaluation OLMES montrent que des choix d’évaluation comme le format du prompt, les exemples en contexte et la formulation de la tâche modifient les performances mesurées. Une comparaison reproductible doit consigner ces réglages. Les tâches de ces travaux ne sont pas le SVG du pélican, mais l’avertissement sur la configuration expérimentale mérite d’être retenu4. Je considérerais la baseline comme un contrat qui fixe « ce que cette série mesure réellement ».
L’objet comparé doit être précis : le service, le groupe ou la route, et la version du modèle que vous pouvez réellement obtenir. Si vous ne disposez que d’un alias de modèle susceptible de changer au fil du temps, notez l’alias. Si vous ne connaissez pas le snapshot sous-jacent, écrivez « inconnu ». Ne considérez pas le nom de modèle renvoyé par l’interface comme une vérification indépendante de l’identité sous-jacente. Conservez l’entrée aussi complètement que possible. Cela va au-delà du prompt final : cela inclut le prompt système, l’historique, les pièces jointes et les réglages d’outils que vous pouvez contrôler et observer. Des conditions visibles identiques ne prouvent pas que les conditions invisibles l’étaient aussi.
Pour les réglages de génération, notez le niveau de raisonnement, la limite de sortie et les paramètres d’échantillonnage que l’interface prend réellement en charge. Écrivez « non pris en charge » pour un champ que l’interface ne propose pas, et « inconnu » pour un champ dont vous ne pouvez pas confirmer qu’il a été appliqué. Ne les considérez pas discrètement comme identiques. Un réglage nommé « high » ne doit pas être supposé correspondre au même budget de calcul sur deux modèles différents.
L’environnement d’évaluation comprend la façon de faire le rendu et la façon de noter. Examinez le même SVG dans la même fenêtre d’affichage et avec le même moteur de rendu. Pour une tâche d’animation, utilisez la fenêtre d’observation convenue : ne regardez pas l’animation complète d’un côté pour ne retenir qu’une seule image de l’autre. Si la tâche ne demandait pas d’animation, ne retirez pas de points parce que la sortie est une image fixe. Enfin, écrivez la règle des nouveaux essais avant le début du test. Savoir si un premier échec peut être retenté, combien de fois, et si un retour est autorisé, fait partie des conditions du test. Ce n’est pas quelque chose à improviser une fois les résultats connus.
Fixer ces éléments ne revient pas à construire un « modèle de laboratoire » coupé du monde réel. Vous pouvez tout à fait comparer l’expérience par défaut de deux produits de chat. La conclusion doit alors être « ces deux produits diffèrent dans ce qu’ils livrent avec leurs réglages par défaut », et non « j’ai isolé lesquels des poids du modèle sous-jacent sont les meilleurs ». Une condition que vous ne pouvez pas contrôler peut rester inconnue. Une condition inconnue ne peut pas être consignée comme contrôlée.
5. L’organisation du test compte souvent plus que le simple fait de le lancer plus souvent
Ne liez pas le canal au moment de la journée
Lancer tout A le matin, puis tout B tard le soir, mélange « une différence entre canaux » et « une différence dans le temps ». Même si vous observez un écart, il est difficile de dire dans quelle mesure il dépend de cette fenêtre. Pour une comparaison côte à côte légère, j’entrelacerais A et B dans une fenêtre choisie à l’avance, en tirant l’ordre au hasard. Gardez un niveau de parallélisme aussi proche que possible. Ne laissez pas un côté générer une requête à la fois pendant que l’autre encaisse une rafale.
Vous pouvez aller un peu plus loin et découper la fenêtre en petits lots, avec A et B dans chaque lot. En plus du résultat global, vous verrez alors si la différence se concentre dans un seul lot. Un ordre aléatoire aide à réduire la confusion liée au moment. Il ne supprime pas automatiquement la corrélation due à un backend partagé, à une courte panne ou à tout autre facteur similaire.
Une question longitudinale, « est-ce pire que la semaine dernière ? », est différente. Le temps est précisément la variable étudiée : impossible de placer les deux côtés au même instant. Conservez autant que possible la même tâche centrale, la même configuration et la même règle de notation, et relancez un service de référence dans chaque fenêtre d’observation. Ne comparez pas indéfiniment les résultats du jour à la meilleure image de la semaine dernière. Quand vous lisez un résultat longitudinal, gardez à la fois le taux de conformité absolu et l’écart relatif. Si le service testé et la référence baissent tous les deux, l’écart entre eux peut rester le même. Cela ne signifie pas que l’expérience de l’utilisateur ne s’est pas dégradée. Une référence n’est pas une vérité toujours juste et toujours stable.
Ne décidez pas quand arrêter en regardant les résultats
« Lancer cinq fois. Si A gagne, publier. Si A ne gagne pas, continuer jusqu’à ce que la différence soit significative. » Cela ressemble à un ajout d’échantillons. En réalité, cela change la règle statistique. Consulter encore et encore un test à échantillon fixe, et s’arrêter en fonction de ce que l’on voit, casse le contrôle des faux positifs pour lequel ce test a été conçu. Un test qui doit surveiller les données en continu doit utiliser une méthode prévue pour l’analyse séquentielle5. La plupart des gens n’ont pas besoin de commencer par les statistiques séquentielles. Le plus simple est de noter, avant la série, combien d’essais vous ferez, quel indicateur principal vous utiliserez et quelles comparaisons principales vous effectuerez. Puis de conserver tous les résultats.
Faire d’abord quelques appels pour vérifier que l’interface et le processus de notation fonctionnent, c’est très bien. Ce sont des essais pilotes. Une fois la procédure finalisée, lancez le test formel séparément. Ne mélangez pas les résultats de la mise au point de la tâche avec les résultats formels. Le même principe s’applique à deux autres habitudes. Essayer des dizaines de tâches et ne publier que celle qui paraît la meilleure, ou constater que le score total est en retrait puis proclamer la victoire sur un sous-score, ce n’est pas la comparaison convenue à l’avance.
Ne prenez pas cent répétitions d’une tâche pour cent tâches
La génération répétée vous dit à quel point le service est fiable sur cette tâche. Elle n’élargit pas automatiquement la portée de la conclusion. Un pélican qui sort de façon régulière ne signifie pas, à lui seul, que le débogage de code, l’analyse de textes longs et le suivi d’instructions complexes sont aussi fiables. Quand vous tirez des conclusions sur une catégorie de tâches, la variation entre tâches et la variation entre répétitions d’une même tâche sont deux formes d’incertitude distinctes. La recherche sur l’évaluation distingue l’échantillonnage répété, les comparaisons au niveau de la tâche et le traitement des échantillons groupés et dépendants6.
J’utiliserais donc d’abord une sonde pour observer la répétabilité, puis j’ajouterais un petit ensemble de tâches fixes liées à l’usage réel. Les deux côtés répondent au même ensemble. Calculez le résultat de chaque tâche, et la différence sur chaque tâche, avant d’agréger. Ne vous contentez pas de livrer un score total. Si vous menez une analyse formelle sur plusieurs tâches, conservez l’appariement par tâche et par lot. Vous ne pouvez pas traiter « 10 tâches, 10 fois chacune » comme « 100 tâches indépendantes » et réutiliser le calcul de la tâche unique vu plus haut.
Il y a un piège plus discret. Un seed fixe est utile quand on traque un problème de reproduction. Copier vingt fois une sortie quasiment inchangée obtenue avec le même seed ne constitue pas vingt observations indépendantes de la distribution des sorties aléatoires. Quand vous mesurez la stabilité, convenez à l’avance de la stratégie d’échantillonnage. Une interface qui prend en charge les seeds peut utiliser plusieurs seeds générés à l’avance. Pour une interface qui ne les prend pas en charge, consignez cette limite. La façon de faire évoluer un ensemble de tâches sur le long terme est une autre question. Au moins à l’intérieur de cette comparaison, ne changez pas les tâches pour relier ensuite anciens et nouveaux scores en une courbe « le modèle progresse ».
6. Timeouts, troncatures et dessins ratés ne vont pas dans le même sac
Une distorsion statistique courante consiste à ne noter que les productions revenues correctement, et à supprimer les timeouts et les erreurs. Le score obtenu répond à « une fois une sortie complète en main, à quelle fréquence est-elle conforme ? ». Il ne répond pas à la question qui compte davantage pour l’utilisateur : « si j’envoie une requête, est-ce que j’obtiens un résultat conforme ? ». Supposons que 20 requêtes aient été prévues à l’avance et que 4 d’entre elles aient expiré. Les 16 autres ont renvoyé une production complète, dont 8 conformes. Le taux de conformité parmi les sorties complètes est de 50 %. Le taux de premières livraisons conformes, calculé sur les 20 requêtes, est de 40 %. Ne publier que le premier chiffre passe sous silence les quatre fois où l’utilisateur n’a rien reçu.
Je conserverais trois types de résultat à la fois : un échec technique de livraison, un retour complet qui échoue à la tâche, et un retour complet qui la réussit. Les timeouts, les erreurs d’interface, les flux interrompus et les dépassements de la limite de longueur doivent chacun garder leur propre motif. Les consigner séparément n’excuse pas une défaillance du service. Pour quelqu’un qui choisit un service, un timeout et un dessin raté coûtent tous deux du temps. Mais quand on remonte à la cause, ils ne doivent pas tous être décrits comme « l’intelligence du modèle a baissé ». Une panne du réseau local ou du script de test doit être listée à part. Décider de l’exclure exige une règle écrite à l’avance. Vous ne pouvez pas supprimer un échantillon après avoir vu quel côté a perdu.
Je préférerais faire de la part des premières requêtes qui renvoient un résultat conforme l’indicateur principal, et garder à côté, comme éléments d’explication, le taux de conformité du contenu parmi les sorties complètes, le taux d’échec technique, la latence et le coût. Le taux de conformité du contenu sur les sorties complètes n’est pas non plus un score de « capacité pure » sans biais. Si les requêtes complexes risquent davantage d’expirer, les productions qui restent étaient peut-être plus faciles dès le départ. Ce taux peut aider à localiser un problème. Il ne peut pas remplacer le résultat calculé sur l’ensemble des requêtes.
« Peut-il réussir après une correction ? » peut faire l’objet d’un test séparé, avec la même possibilité de correction des deux côtés. N’accompagnez pas un côté pendant cinq tours de correction pour condamner l’autre à la première erreur.
7. Une comparaison minimale que n’importe qui peut réellement mener
Pas besoin de construire une plateforme d’évaluation avant de tester un pélican. Voici un plan de départ. Il sert à vérifier une différence évidente sur une sonde fixe. Ce n’est pas un plan d’échantillonnage qui garantit de détecter un léger déclin.
| Élément | Convention pour cette série |
|---|---|
| Question | Sur cette tâche fixe, les services A et B diffèrent-ils dans la part de premières livraisons conformes ? |
| Entrée et réglages | Conserver la requête visible complète. Aligner les paramètres que vous pouvez contrôler. Consigner les différences que vous ne pouvez pas confirmer. |
| Échantillon | Prévoir à l’avance 20 requêtes formelles de chaque côté. Exclure les essais pilotes de l’échantillon formel. |
| Moment et ordre | Découper une fenêtre déclarée à l’avance en 4 lots, avec 5 appels pour A et 5 pour B dans chacun. Les entrelacer au hasard dans le lot, avec la même règle de parallélisme. |
| Nouveaux essais | Le test formel de première réponse n’ajoute aucun nouvel essai. Ouvrir une expérience séparée pour mesurer la correction. |
| Notation | Fixer la règle de conformité avant le premier essai. Après le rendu, masquer le nom du canal, mélanger l’ordre, puis noter. |
| Sortie | Conserver chaque résultat brut, le statut de chaque appel, la justification de chaque note, ainsi que les statistiques par lot et globales. |
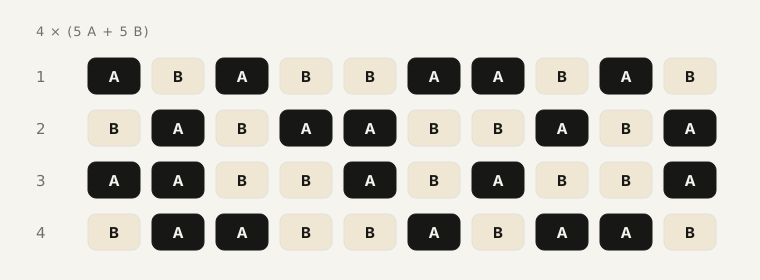
Une règle de conformité simple est un bon point de départ pour la tâche du pélican. Le fichier s’affiche-t-il dans l’environnement convenu ? Le sujet et le vélo sont-ils assez complets pour être reconnus ? Une structure essentielle est-elle manifestement fausse ? Les contacts exigés par la tâche, comme celui du pied et de la pédale, sont-ils réellement respectés ? Vous pouvez noter l’esthétique à part. Des couleurs soignées ne compensent pas une erreur de structure.
Si quelqu’un hésite sur un échantillon limite, marquez-le comme litigieux et appliquez la règle de revue fixée à l’avance. Ne décidez pas s’il passe après avoir vu le nom du canal. Un petit test peut être noté à la main, à l’aveugle. Quand l’échelle grandit, la notation automatique et le calibrage des juges deviennent la question suivante. Inutile de tout résoudre dès la première série. L’enregistrement est bien plus simple si vous séparez la configuration propre à la série du journal qui compte une ligne par appel. La configuration de la série conserve le modèle de requête brut, les paramètres, la version de la tâche, la version de la règle de notation, la fenêtre temporelle, ainsi que la convention sur les timeouts et les nouveaux essais. Chaque appel doit enregistrer au moins ces champs :
run_id,block_id,service,service_group,requested_model,returned_model,started_at,request_hash,status,finish_reason,latency_ms,qualified,failure_reason,artifact_pathNotez les heures avec un fuseau horaire. Reliez la réponse brute, le SVG extrait et l’image rendue par artifact_path. Le nombre de tokens, les empreintes de backend et toute autre information exposée par l’interface peuvent être stockés à côté. Si rien n’a été fourni, enregistrez une valeur vide ou « inconnu ». request_hash permet de vérifier que la requête est restée identique. Il ne remplace pas la requête brute. Quand vous enregistrez ou partagez le journal, retirez les clés API et masquez le contexte privé ou tout autre contenu sensible. Ce dont une vérification publique a besoin, ce sont les conditions expérimentales, pas les identifiants du compte livrés avec.
Quand vous faites la synthèse, regardez d’abord l’écart global et le résultat de chaque lot. L’intervalle binomial et le test exact de Fisher vus plus haut s’appliquent quand leurs hypothèses, dont l’indépendance et la stabilité, sont à peu près respectées. Si le résultat dépend nettement du lot, ou si vous passez ensuite à des tests répétés sur plusieurs tâches, analysez le plan apparié. Ne réutilisez pas mécaniquement la formule de la tâche unique. Si une première différence mérite d’être creusée, retestez-la dans une nouvelle fenêtre déclarée à l’avance, et ajoutez des tâches liées à votre usage réel. La première série fournit une piste d’anomalie. C’est une nouvelle série, indépendante, qui aide à juger si l’anomalie persiste.
8. Une fois la différence trouvée, comment rédiger la conclusion ?
Avec les mêmes chiffres pédagogiques, une conclusion mesurée et néanmoins utile peut se lire ainsi :
Avec la tâche fixe de cette série, des réglages visibles identiques et une fenêtre temporelle déclarée à l’avance, A et B ont chacun été testés 20 fois. Les premières livraisons conformes sont au nombre de 16 et 8. Les taux de conformité observés diffèrent de 40 points de pourcentage. Sous des hypothèses qui incluent un échantillonnage indépendant, un test exact de Fisher bilatéral donne une valeur p d’environ 0,0225, ce qui soutient l’existence d’une différence dans les conditions de cette série. Le résultat doit encore être vérifié dans d’autres fenêtres et sur des tâches apparentées. Il ne permet pas, à lui seul, d’identifier la cause précise d’un changement du modèle sous-jacent ou de la configuration du serveur.
C’est moins excitant que « la preuve qu’il tourne à pleine puissance ». Mais cela transmet à la personne suivante les conditions dont elle a besoin pour revérifier. Si des tests ultérieurs, dans le temps et sur des tâches apparentées, continuent d’aller dans le même sens, nous avons une raison plus solide de dire que ce service est moins fiable que la référence pour ces usages, ou qu’il a réellement régressé par rapport à sa propre baseline historique. Passer de « la livraison s’est dégradée » à « ils ont discrètement mis un modèle plus petit à la place » reste un pas de plus. Confirmer un mécanisme précis exige des preuves indépendantes capables de départager les explications, comme un historique de routage ou de configuration vérifiable. Le style de sortie ne suffit pas pour deviner le modèle.
Cela ne veut pas dire non plus qu’un utilisateur doit attendre que la cause soit connue pour avoir le droit de changer. Choisir un service dépend de sa capacité à satisfaire vos exigences. Accuser une cause précise dépend de preuves sur cette cause. Les deux peuvent rester distincts.
9. Ce qu’il faut vraiment économiser, c’est le coût d’une démonstration claire
Le plus fatigant dans un test manuel n’est généralement pas d’appuyer sur « lancer ». C’est le travail répétitif qui suit. Où est le fichier ? Les paramètres ont-ils changé ? De quelle génération vient cette image ? S’agissait-il d’un nouvel essai ? La capture correspond-elle encore à la réponse brute ? Sans ces traces, la conviction qu’« il est vraiment devenu plus bête » peut, une semaine plus tard, se réduire à quelques captures que personne ne peut revérifier.
Si vous voulez seulement un premier aperçu du comportement des différents services, tout le monde n’a pas à repartir de zéro. Vous pouvez commencer par Folkbench, consulter les classements publics et l’accès aux rapports, et voir si le modèle, le groupe de service et l’indicateur qui vous intéressent ont déjà un résultat. Les pages publiques insistent sur la comparaison des services à modèle égal, et les classements précisent aussi que les chiffres du groupe d’une ligne ne valent pas pour tous les groupes de ce relais7.
Un classement publié doit réduire le coût de la collecte et de l’organisation. Il ne doit pas servir de prétexte pour cesser de vérifier les conditions. Folkbench compris, tout classement mérite qu’on l’interroge davantage : quand a-t-il été mesuré, qu’a-t-on mesuré, quelle était la taille de l’échantillon, les échecs ont-ils été conservés, et quelle est la portée de la conclusion ? Une information qui n’est pas publique reste inconnue. Revenons à la question de départ. Quelle part de « le modèle a été nerfé » est réelle, et quelle part relève de l’illusion d’un tirage unique ?
Tant qu’il n’existe ni définition partagée, ni échantillon complet, ni conditions comparables, publier un pourcentage global ne fait que créer une nouvelle légende. Ce que nous pouvons mieux faire, c’est prendre chaque soupçon concret et le transformer, étape par étape, en jugement vérifiable. Quand vous voyez un échec, conservez le résultat brut. Quand vous soupçonnez un déclin, lancez une comparaison. Quand vous trouvez une différence, remontez alors à la cause. N’essayez pas de boucler toutes ces étapes dans une seule capture d’écran. Une capture peut poser une bonne question. Y répondre demande encore une vraie expérience.
Notes et sources
- OpenAI, How to make your completions outputs consistent with the new seed parameter, exemple archivé du Cookbook. La note présente un seed fixe comme un effort de déterminisme « au mieux », et non comme une garantie. Cet article ne cite que cette limite de la reproductibilité. Il ne traite pas les anciens noms de modèles ni la prise en charge des paramètres décrits sur cette page comme une description actuelle du produit. Source↩
- NIST/SEMATECH, e-Handbook of Statistical Methods, section 7.2.4.1, Confidence intervals, intervalle de score de Wilson pour une proportion. Cet article utilise des intervalles de Wilson bilatéraux à 95 % pour 16/20 et 8/20. Ils ont été calculés à partir de la formule et arrondis à une décimale, en pourcentage. Le niveau de confiance décrit la couverture à long terme de la méthode d’intervalle. La méthode de Wilson est une approximation. Source↩
- Documentation SciPy,
scipy.stats.fisher_exact. Cet article utilise le tableau de contingence[[16, 4], [8, 12]]avecalternative="two-sided"et obtientp = 0.0224774273717544. Il s’agit d’un calcul sur les données d’exemple, et non d’un résultat mesuré issu d’un article scientifique ou du rapport d’une plateforme. L’exemple compare des résultats binomiaux indépendants. Des données appariées, un regroupement par tâche, une dépendance temporelle ou des comparaisons multiples exigent une analyse adaptée au plan d’expérience. Source↩ - Yuling Gu et al., OLMES: A Standard for Language Model Evaluations, Findings of NAACL 2025. L’article examine des détails d’évaluation comme le format du prompt, le choix des exemples en contexte et la formulation de la tâche, ainsi que ce qu’exige une comparaison reproductible. Source↩
- Ramesh Johari, Leo Pekelis et David J. Walsh, Always Valid Inference: Bringing Sequential Analysis to A/B Testing, arXiv:1512.04922, révision de 2019. L’article examine le problème de la surveillance continue des résultats lorsqu’elle détermine la taille de l’échantillon, ainsi que les méthodes d’inférence séquentielle qui y répondent. Source↩
- Evan Miller, Adding Error Bars to Evals: A Statistical Approach to Language Model Evaluations, 2024. Sur l’incertitude au niveau de la tâche, l’échantillonnage répété, les comparaisons appariées et les échantillons groupés, voir les sections 2, 3 et 4. Sur la planification de la taille de l’échantillon, voir la section 5. Source↩
- Pages publiques d’accueil et de classements de Folkbench, consultées le 5 octobre 2026. Cet article s’appuie sur ces pages publiques uniquement pour décrire le point d’entrée, le périmètre de la comparaison et l’avertissement au niveau des groupes. Il ne cautionne de manière indépendante aucun chiffre précis du classement, et n’affirme pas que Folkbench met déjà en œuvre chacune des procédures expérimentales proposées ici. Accueil ; Classements↩