Folkbench lance la détection de dégradation des modèles au sein du Moniteur d’intégrité. Les classements traditionnels évaluent le plafond d’un modèle dans un cadre officiel, tandis que les annuaires de relais d’API s’arrêtent généralement aux tarifs affichés, à la disponibilité HTTP et à la latence. Aucun des deux ne répond à la question clé en production : lorsqu’un modèle transite par un relais d’API tiers, sa profondeur de raisonnement, son respect des contraintes et sa signature restent-ils alignés avec l’API officielle directe ?
Pour combler cet angle mort, Folkbench déploie une suite automatisée de sondes couvrant l’actualité et l’empreinte du modèle (model fingerprint), étalonnée en continu par des clés API officielles directes indépendantes sur les mêmes fenêtres temporelles. En ancrant les mesures des relais sur une référence officielle en direct, les écarts discrets deviennent des signaux publics vérifiables.
Principaux apports de cette fonctionnalité :
- Sondes bidimensionnelles : Associe des sondes d’actualité renouvelées dans le temps à des sondes d’empreinte mesurant habitudes de raisonnement, allocation de tokens et télémétrie d’API, bloquant ainsi le cache statique et l’imitation de surface.
- Étalonnage officiel indépendant : Exécute les mêmes sondes via des clés API officielles directes isolées durant chaque fenêtre de mesure pour distinguer une variation du fournisseur officiel d’une dérive propre au relais.
- Granularité par modèle et par groupe de service : Suit concordance des sondes, tokens d’entrée, tokens de réflexion, empreintes et contrôles de cache disponibles pour chaque couple modèle-groupe.
- Chaîne complète du contrôle au basculement : Relie le Moniteur d’intégrité aux quatre classements publics Folkbench, au comparateur côte à côte et au client open source Folkbench Switch.
Pourquoi les classements classiques et le suivi de disponibilité manquent la dégradation
Dans un routage par relais, une passerelle s’interpose entre l’appelant et le laboratoire du modèle. Sous contrainte de coût ou en période de pointe, trois formes de dégradation restent invisibles aux métriques réseau classiques :
- Substitution silencieuse de modèle : L’appel demande un modèle phare, mais aux heures chargées ou sur des contextes longs la requête est redirigée vers un modèle plus léger ou un ancien snapshot.
- Réduction du budget de réflexion : Le nom du modèle reste inchangé, mais l’effort de raisonnement est abaissé ou les étapes internes sont coupées prématurément.
- Troncature du contexte ou des sorties : D’anciens tours de conversation sont écartés ou la longueur maximale de sortie est bridée, provoquant des oublis sur des tâches longues.
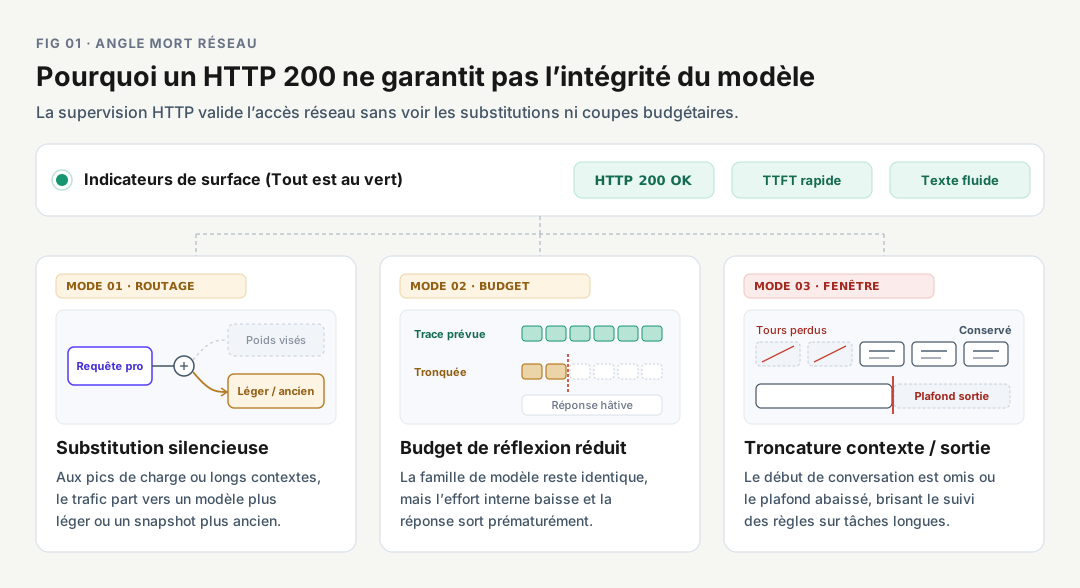
Figure 1 : Une connectivité irréprochable en surface (`HTTP 200`, faible TTFT, phrases fluides) ne garantit pas l’intégrité du modèle. Substitution silencieuse, baisse du budget de réflexion et coupure du contexte restent invisibles au simple ping.
Dans les trois cas, la connectivité apparente reste parfaite : l’endpoint renvoie HTTP 200, les échanges simples restent fluides et un raisonnement raccourci réduit même parfois la latence. De plus, comme détaillé dans [Le modèle a-t-il vraiment été nerfé ?](/fr/blog/did-the-model-get-dumber/), la variabilité d’échantillonnage rend toute capture isolée insuffisante pour trancher entre bruit statistique et dégradation systémique.
Pourquoi les tests manuels courants échouent face au routage moderne
Lorsque les utilisateurs soupçonnent une baisse de niveau, deux vérifications manuelles courantes se heurtent au routage moderne des passerelles :
- Demander au modèle son identité : Un modèle n’a aucune visibilité sur le proxy qui le précède ; une consigne système ou une formule apprise suffit à lui faire revendiquer le nom souhaité.
- Réutiliser des énigmes statiques : Les questions classiques figurent déjà dans les corpus d’entraînement de petits modèles, et un jeu fixe expose le test au cache statique ou au routage sélectif vers une voie saine pour les seuls prompts de test.
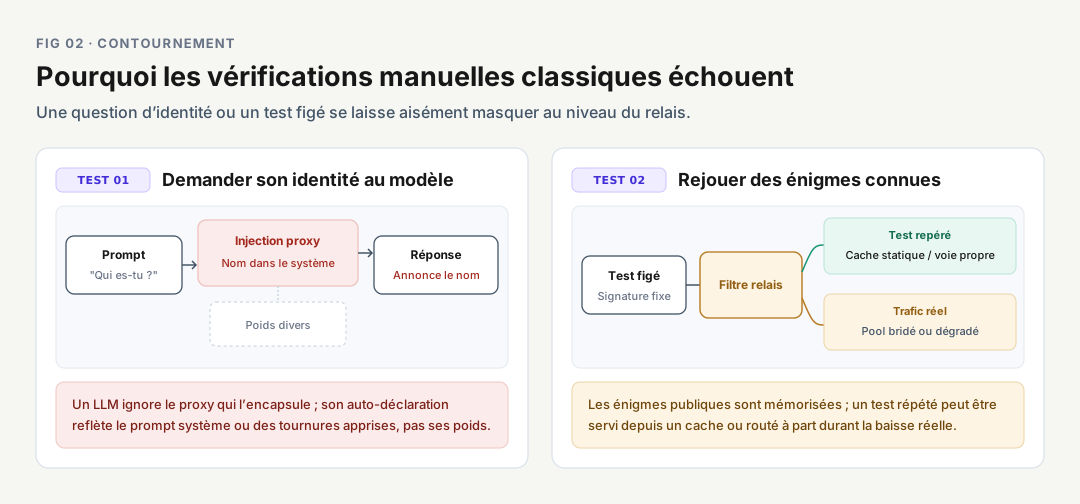
Figure 2 : Pourquoi deux autotests courants échouent. À gauche, le prompt système injecté impose le nom attendu quels que soient les poids actifs. À droite, un filtre détecte les tests fixes répétés et répond via un cache statique ou une voie saine tout en dégradant le trafic ordinaire.
Architecture à doubles sondes : actualité et empreinte du modèle
Pour détecter ces dérives avec rigueur, Folkbench déploie dans chaque fenêtre deux dimensions de sondes complémentaires exécutées en parallèle :
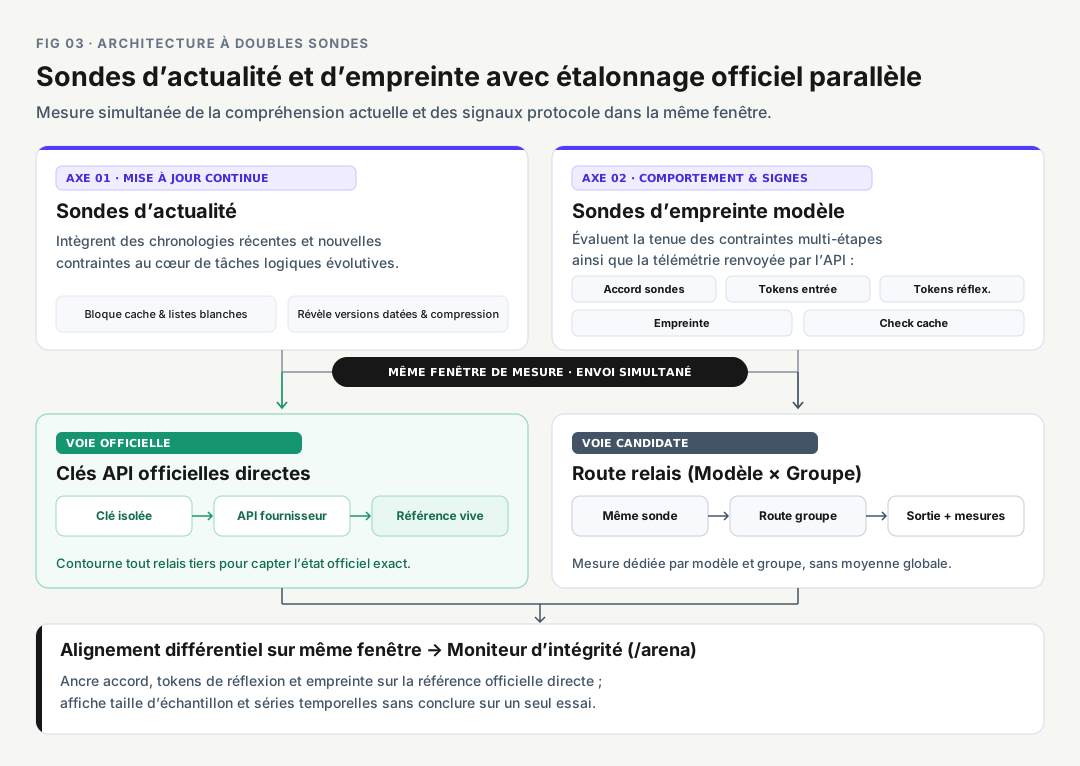
Figure 3 : Architecture parallèle à fenêtre unique. Les sondes d’actualité bloquent les caches figés ; les sondes d’empreinte relèvent concordance, tokens d’entrée, tokens de réflexion, empreinte et contrôles de cache face à des clés API officielles directes isolées.
1. Sondes d’actualité : neutraliser le cache statique et les versions obsolètes
Les sondes d’actualité intègrent des faits récents, des chronologies actualisées et des conditions dynamiques. Leur renouvellement continu empêche l’utilisation de réponses mises en cache ; lorsqu’une tâche demande d’ordonner des événements récents et d’appliquer de nouvelles contraintes, un ancien snapshot bute sur sa date de coupure et un modèle trop compressé perd en cohérence.
2. Sondes d’empreinte : contrôler les habitudes d’exécution et la télémétrie
Un substitut correct sur des questions basiques ou un modèle privé de la moitié de son budget de réflexion peut encore réussir des QCM simples. Les sondes d’empreinte observent le respect fin des contraintes, les trajectoires multi-étapes et la télémétrie API : concordance des sondes, tokens d’entrée, tokens de réflexion, empreinte du modèle et contrôles de cache disponibles. Lorsque le budget de réflexion est réduit en arrière-plan, la prose reste fluide tandis que tokens de réflexion et concordance décrochent simultanément.
Étalonnage par clés API officielles directes indépendantes
Sans témoin simultané, une baisse observée sur un relais peut venir soit du relais lui-même, soit d’une mise à jour ou fluctuation côté fournisseur officiel. Pour lever cette ambiguïté, Folkbench exécute exactement les mêmes sondes sur des clés API officielles directes et indépendantes, sans passer par aucun relais, durant les mêmes fenêtres de mesure.
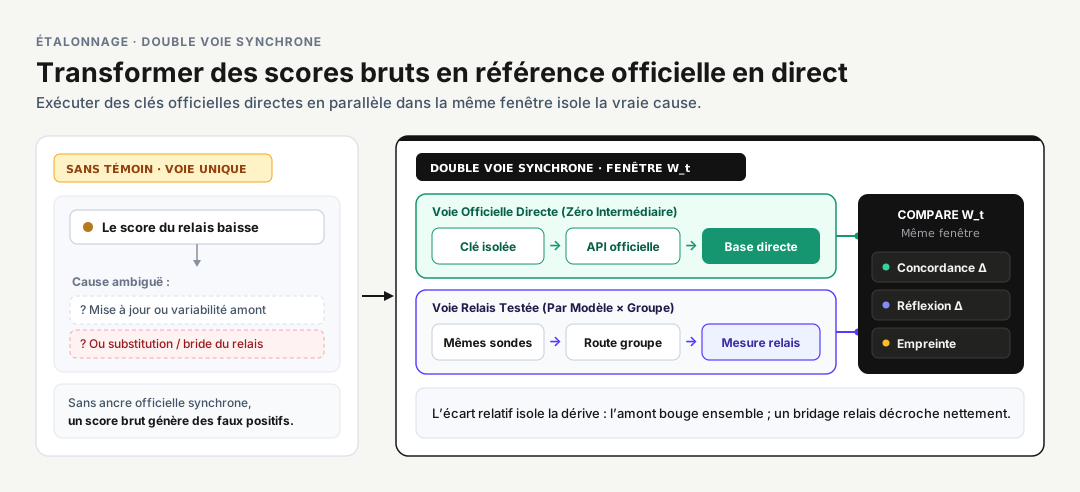
Mécanisme d’étalonnage : Sans témoin officiel simultané (à gauche), une baisse reste ambiguë entre évolution amont et dérive du relais. La double voie synchrone (droite) confronte des clés officielles isolées à chaque route `modèle × groupe` dans la même fenêtre `W_t`.
| Cas observé | Mesure du relais sans témoin | Étalonnage par clés officielles directes indépendantes |
|---|---|---|
| Fluctuation ou mise à jour du modèle officiel | Risque de fausse alerte contre le relais | La référence officielle évolue en parallèle et isole le bruit global |
| Base officielle stable, chute d’un relais | Absence de point de comparaison simultané | Concordance et tokens de réflexion divergent nettement de la référence |
| Écart entre groupes d’un même relais | Un pool stable masque un pool promo bridé | Chaque route modèle × groupe est confrontée séparément à la référence |
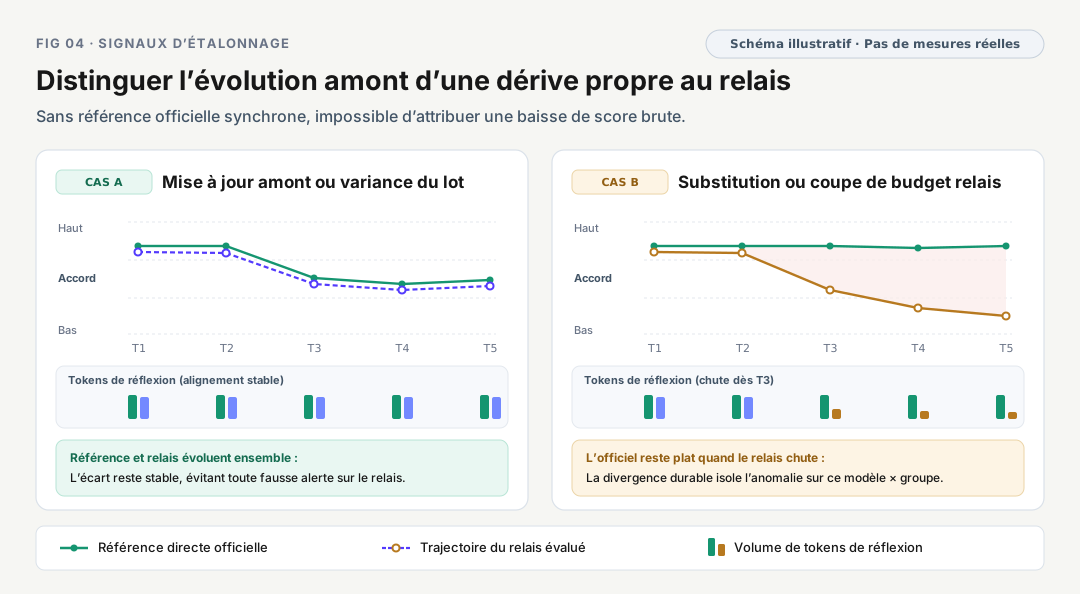
Figure 4 (schéma illustratif, non issu de mesures réelles) : Attribution par référence officielle directe. Une baisse parallèle dès `T3` (Cas A) reflète une évolution amont ou du lot ; une référence stable face au décrochage conjoint de la concordance et des tokens de réflexion (Cas B) signale une dérive sur ce couple `modèle × groupe`.
Conformément aux limites rappelées sur le [Moniteur d’intégrité](/fr/arena), une réponse isolée ou un pourcentage seul ne prouve pas une substitution. Les signaux s’interprètent avec la taille d’échantillon, la continuité temporelle et la distribution de tokens.
Ce qui distingue Folkbench des sites d’évaluation classiques
La plupart des sites d’évaluation se cantonnent soit aux scores théoriques sur jeux fixes, soit au prix et au ping HTTP. Folkbench comble cet écart avec une chaîne de vérification en quatre étages :
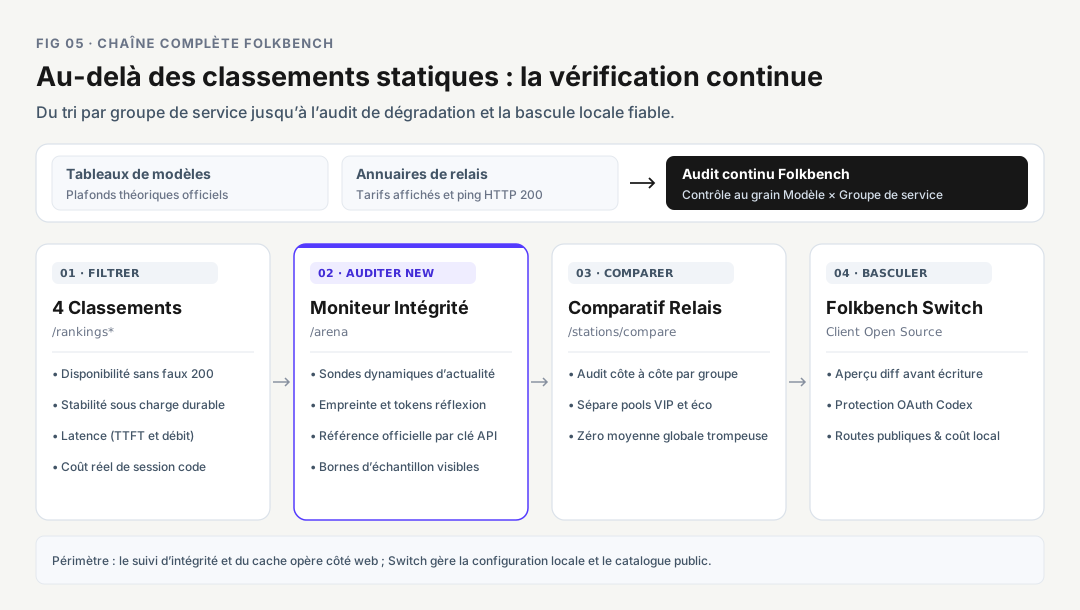
Figure 5 : Des classements statiques au contrôle continu de livraison. Folkbench enchaîne sélection par groupe (`/rankings), audit de dégradation (/arena), comparaison exacte (/stations/compare) et bascule locale sécurisée (Folkbench Switch`), la détection continue et le suivi de cache restant assurés côté web.*
- Mesure par modèle et par groupe exact : Évite qu’une seule voie haut de gamme ne représente tout un prestataire.
- Quatre classements publics spécialisés : [Disponibilité](/fr/rankings) (écarte les faux
200et coupures de flux), [Stabilité](/fr/rankings/stability) (charges longues et heures de pointe), [Latence](/fr/rankings/latency) (TTFT distinct du débit continu) et [Coût par session](/fr/rankings/cost) (coût réel de travail). - [Moniteur d’intégrité](/fr/arena) et [Comparateur de relais](/fr/stations/compare) ouverts : Télémétrie étalonnée et comparaison directe sans maintenir vos propres clés de référence.
- Client open source [Folkbench Switch](https://github.com/Folkbench/folkbench/releases) : Application Tauri + Rust (macOS
.dmg, Windows.exe) pour Claude Code, Codex, Gemini CLI, Aider, OpenCode et Kimi CLI avec aperçu des diffs, protection des identifiants OAuth Codex et estimation locale d’usage. (Le suivi d’intégrité et de cache reste une fonction web continue.)
Exploiter ces signaux au quotidien
- Sélectionnez vos groupes candidats sur [Disponibilité](/fr/rankings), [Stabilité](/fr/rankings/stability), [Latence](/fr/rankings/latency) et [Coût par session](/fr/rankings/cost).
- Vérifiez sur le [Moniteur d’intégrité](/fr/arena) l’alignement des sondes, tokens de réflexion et empreintes avec la référence officielle sur plusieurs fenêtres consécutives.
- Comparez exactement le groupe visé dans [Comparer les relais](/fr/stations/compare) avant de créditer un compte.
- Enregistrez une route principale et une route de secours dans Folkbench Switch pour basculer en quelques secondes après contrôle du diff.
Évaluer l’IA en production ne se limite plus au score théorique d’un modèle : il faut vérifier que chaque route délivre réellement le modèle payé. Grâce aux sondes d’actualité, aux empreintes de modèle et à l’étalonnage officiel direct indépendant, Folkbench fournit un repère public et vérifiable pour choisir vos routes d’API.