
Le premier article invitait à ne pas croire une simple capture d’écran. Celui-ci va plus loin : pourquoi ne faut-il pas non plus croire un score ?
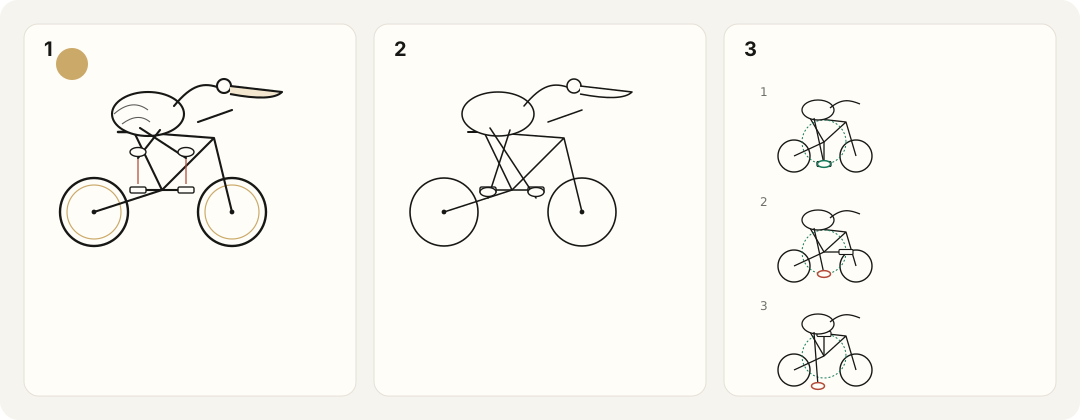
Imaginons trois pélicans à vélo. Le premier est dessiné avec beaucoup de soin : un plumage tout en nuances, des reflets sur les roues, et même un coucher de soleil en arrière-plan. Mais en y regardant de près, on s’aperçoit que ses deux pieds flottent au-dessus des pédales. Le deuxième ressemble à un croquis en quelques traits : pas d’ombre, pas de jolie palette. Pourtant, le cadre est correctement assemblé, le corps est assis sur la selle et les pieds reposent bel et bien sur les pédales. Le troisième ne présente aucun défaut sur une image fixe. Mais dès qu’on lance la lecture, un pied se met à dériver sur sa propre trajectoire : la pédale tourne de son côté, le pélican pédale du sien. Lequel mérite la meilleure note ?
Si la réponse est « le premier est le plus beau », nous notons l’esthétique. Si c’est « le deuxième est le plus fiable », nous notons l’accomplissement de la tâche. Et si l’on ne regarde qu’une capture d’écran, l’erreur du troisième risque de passer totalement inaperçue.
L’article précédent soutenait que, pour savoir si un modèle s’est réellement dégradé, il faut répéter les tests dans des conditions comparables plutôt que de retenir une seule sortie. Mais ce raisonnement reposait sur une prémisse qui n’a pas encore été établie : nous savons déjà ce qu’est un résultat conforme. Si cette prémisse est fausse, la répétition ne rend pas automatiquement la conclusion crédible. Elle peut seulement permettre à un instrument de mesure biaisé de mesurer de façon de plus en plus stable. Cet article part de là : comment transformer « ce pélican a l’air correct » en une méthode d’évaluation fondée, vérifiable et automatisable pas à pas ?
Remarque : les échantillons, chiffres, barèmes de notation et configurations présentés ici sont des exemples méthodologiques. Ils ne correspondent à aucun classement réel de modèles et ne signifient pas que Folkbench a mis en œuvre ces procédures. Les travaux cités servent à expliquer des méthodes et des risques connexes ; ils ne signifient pas que la proposition de cet article a été validée expérimentalement.
1. Rédiger l’énoncé avant de discuter de la notation
Le test du pélican séduit parce qu’il étale l’erreur au grand jour : une patte en trop, un cadre qui ne se raccorde pas, un pied qui rate la pédale, tout cela se dissimule mal derrière une phrase bien tournée. Encore faut-il préciser ce qu’il mesure réellement. Demander à un modèle de « dessiner en SVG un pélican qui fait du vélo » permet d’observer directement s’il sait transformer une consigne écrite en code, et si ce code produit une image conforme à la consigne. Ce résultat seul ne dit pas quelle représentation spatiale le modèle a utilisée en interne. Il ne permet pas non plus de faire passer « il a bien réussi cet exercice » pour « il possède une compréhension spatiale complète ».
Si le modèle peut faire le rendu, regarder l’image et la réviser à plusieurs reprises, on mesure alors un flux de travail avec rétroaction, et non plus une simple génération de code. Les deux méritent d’être mesurés, mais ils ne doivent pas se retrouver dans le même classement à la première réponse. Le point le plus concret est le suivant : une exigence qui n’a pas été écrite dans l’énoncé ne doit pas surgir au moment de la notation. Si l’énoncé d’origine se résume à « dessiner un pélican qui fait du vélo », on ne peut pas exiger après coup un vélo de route standard, deux roues rigoureusement identiques, les deux ailes sur le guidon ou toutes les pièces bien visibles. Une perspective raisonnable, l’occultation et le style cartoon font partie du dessin à consigne ouverte. Je séparerais donc le test en deux variantes.
La première conserve l’énoncé ouvert et observe comment le modèle comprend et exprime l’idée de « faire du vélo ». La notation ne retient que les exigences claires et nécessaires, et elle admet que les cas limites peuvent prêter à discussion. La seconde est un énoncé contraint : il fixe à l’avance le point de vue, les relations visibles, le format de sortie et les techniques autorisées. Par exemple : vue principalement de profil ; léger décalage autorisé pour montrer les deux pieds ; contact visible entre chaque pied et sa pédale ; un seul SVG autonome à livrer ; aucune image ni aucun script externe.
Un énoncé contraint modifie l’énoncé d’origine. Ce n’est pas un défaut. Dès lors que la version de l’énoncé est indiquée, il permet de poser une question plus précise : le modèle a-t-il manqué le point de vue, échoué à rendre le contact lisible, ou mal dessiné la structure du vélo ? L’enjeu n’est pas de savoir quelle version est la plus « authentique ». Un énoncé ouvert se note comme un énoncé ouvert, un énoncé contraint comme un énoncé contraint. On n’associe pas un énoncé flou à une norme stricte inventée après coup.
2. Pas de note globale trop vite : décomposer d’abord « faire du vélo »
« Dans l’ensemble, pas mal. 8 points. » C’est la façon de noter la plus commode, et la plus difficile à revérifier. Ce 8 vient-il d’un sujet correct, d’une structure cohérente ou d’une palette agréable ? La prochaine fois que la même erreur apparaîtra, le juge lui donnera-t-il 9 ? Je partirais de quatre dimensions, sans les traiter comme quatre chiffres remplis au jugé.
| Dimension | Ce qu’elle vérifie principalement | Ce qu’il ne faut pas y mêler |
|---|---|---|
| Pelican : le sujet | S’il est reconnaissable comme un pélican ; si le corps ou les membres présentent une anomalie manifeste ; s’il respecte la visibilité explicitement exigée par l’énoncé | Un degré de réalisme, un détail du plumage ou une préférence de style personnelle que l’énoncé n’exigeait pas |
| Bicycle : le vélo | Si les roues, le cadre, la manivelle, les pédales, etc. forment la structure cohérente exigée par l’énoncé | Une marque, un modèle de vélo, une décoration ou une écriture SVG particulière que l’énoncé n’exigeait pas |
| Riding : la relation de conduite | Si le corps est soutenu de façon plausible ; si les pieds correspondent aux pédales ; si la relation de pilotage exigée par l’énoncé est établie | Le simple fait que « l’oiseau est à côté du vélo » ou que « les deux objets existent » |
| Animation : les relations dans le temps | Si le mouvement exigé a bien lieu ; si le contact et les liaisons tiennent pendant le mouvement ; s’il y a un saut incohérent ou une interpénétration | Une animation qu’un énoncé statique n’a jamais demandée ; des effets sans rapport avec la tâche |
Qu’un objet existe ne signifie pas qu’une relation est établie. « Il y a un pied » et « il y a une pédale » sont deux jugements sur des objets. « Le pied est sur la pédale » est un jugement sur une relation. Un pas plus loin, « le pied reste sur la pédale pendant qu’elle tourne » est un jugement sur une relation dans le temps. C’est pourquoi vérifier seulement que « le pélican, le vélo et les deux roues sont bien présents » est très loin de suffire. Ce qu’il faut isoler, ce sont les liens entre le corps et la selle, le pied et la pédale, la pédale et la manivelle, le cadre et l’axe des roues.
Des travaux existants peuvent servir de point d’appui. TIFA transforme les exigences d’un texte en plusieurs questions, puis s’appuie sur des questions-réponses visuelles pour vérifier si une image générée y satisfait. Ce n’est pas un évaluateur de pélicans clé en main, mais cela indique une piste utile : confronter l’image aux exigences point par point, plutôt que de se contenter d’une impression d’ensemble1. Pour l’implémentation, je conserverais quatre états pour chaque vérification : pass, fail, uncertain et not_applicable. Ils signifient respectivement réussi, échoué, preuves insuffisantes et sans objet.
La distinction importante porte sur les deux derniers. Si un énoncé statique n’exigeait pas d’animation, Animation est « sans objet ». Si l’animation était exigée mais que les éléments disponibles ne suffisent pas à juger d’une interpénétration, c’est « preuves insuffisantes ». Le premier cas ne doit pas coûter de points. Le second ne doit pas être compté automatiquement comme une réussite. Il faut ensuite répartir les critères entre conditions nécessaires et critères de qualité complémentaires. Les conditions nécessaires décident de la conformité. Les critères complémentaires décrivent le détail et l’aspect. Un échec manifeste sur une condition nécessaire ne peut pas être racheté par un beau plumage, un arrière-plan ou un dégradé.
Un premier rapport peut se contenter d’indiquer combien de vérifications du sujet ont réussi, quel critère de structure du vélo a échoué, si la relation de conduite laisse une question en suspens et si l’animation s’applique. Il n’a pas besoin d’une note globale précise à deux décimales. Si une note combinée est vraiment nécessaire, publiez à l’avance les critères applicables, les pondérations et le traitement des valeurs manquantes, et affichez séparément les échecs aux conditions nécessaires. Les classements obtenus avec différentes pondérations méritent eux-mêmes d’être vérifiés pour leur robustesse. Une note globale est un résumé compressé. Ce n’est pas une raison de remplacer les preuves d’origine.
3. Le DOM SVG peut aider, mais ce n’est pas un schéma structurel livré avec la réponse
Face à du SVG, l’intuition d’ingénieur vient facilement : il y a du code source, pourquoi ne pas l’analyser directement ? Les règles s’écrivent alors très vite. Deux éléments circle ? Il y a deux roues. Un élément nommé foot ? Il y a un pied. Si les boîtes englobantes du pied et de la pédale se chevauchent, le pied est sur la pédale. Le problème, c’est que chacune de ces étapes confond « une manière d’exprimer quelque chose dans le code » avec « un fait sémantique dans l’image ».
Une roue peut être un élément cercle ou un chemin. Deux roues peuvent être écrites séparément, ou réutilisées via use. Un même objet visuel peut aussi se composer de plusieurs groupes et chemins. La spécification SVG autorise ces différentes formes d’expression et n’exige pas qu’un objet du monde réel corresponde à un seul nœud DOM2. Ainsi, ne pas trouver deux éléments circle ne prouve pas qu’il manque une roue, et en trouver deux ne prouve pas qu’elles sont placées de façon cohérente. Un élément nommé foot porte seulement le nom que le générateur lui a donné ; ce n’est pas une vérification indépendante.
Les règles statiques conviennent aux contraintes vérifiables sans ambiguïté
Par exemple : la sortie s’analyse-t-elle dans le format convenu, contient-elle une référence externe interdite par l’énoncé ou un script non autorisé, produit-elle un rendu non vide dans l’environnement spécifié ? Ces vérifications ont une base claire et se consignent facilement dans des journaux. Elles répondent à la question « la sortie respecte-t-elle les contraintes de livraison et les contraintes techniques ? », et non à « cet oiseau est-il correctement installé sur son vélo ? ». De même, un rendu réussi ne remplace pas une vérification du format. La spécification SVG distingue différentes formes de document et différents modes de traitement. Un fragment intégré dans une page web et un fichier SVG autonome ne doivent pas être validés selon la même exigence d’analyse sans que ce choix soit énoncé3.
Une vérification géométrique doit d’abord établir ce que l’on mesure
Une fois identifiées de façon fiable les zones géométriques visibles qui correspondent au pied et à la pédale, on peut calculer distances, chevauchements et trajectoires. Par exemple, diviser la distance entre le dessous du pied et la surface de contact de la pédale par un diamètre de roue de référence convenu dans la même image. On obtient une distance relative. Exprimer ainsi « à quelle distance de la pédale se trouve le pied » est plus facile à interpréter que d’appliquer un seuil fixe en pixels. La définition de la surface de contact et la marge d’erreur tolérée doivent encore être étalonnées sur des échantillons annotés. On ne peut pas décréter de nulle part que « cinq pixels d’écart, c’est forcément faux ».
La mesure doit aussi tenir compte des transformations de coordonnées, du contour, du découpage et de la visibilité réelle. Un élément SVG peut se trouver dans un système de coordonnées imbriqué. La spécification prévoit aussi des cas où un élément qui n’est pas réellement rendu possède malgré tout une boîte englobante. Disposer d’une boîte englobante, ce n’est pas disposer des limites de l’objet visible dans l’image4. Deux boîtes englobantes qui se chevauchent ne signifient pas que le dessous du pied touche la pédale. Deux zones planes qui se superposent peuvent n’être qu’une occultation en profondeur, et non un appui plausible. Sur du SVG quelconque, les règles géométriques sont plus utiles comme preuves d’appoint, une fois validées, que comme juge non étalonné doté d’un droit de veto.
Il est possible, pour faciliter l’automatisation, d’exiger un ensemble uniforme d’ID de pièces, de points clés et de structure de groupes. Il faut alors en faire une piste distincte, dite « sortie structurée », qui vérifie que ces déclarations correspondent bien à l’image réelle. On ne laisse pas le modèle écrire « contact correct » pour que le programme d’évaluation le croie sur parole. Le DOM nous donne davantage d’informations vérifiables. Il ne résout pas gratuitement la reconnaissance sémantique.
4. Avant de confier le poste à un juge visuel, faites-lui passer un examen
Si les règles statiques ne suffisent pas, confions la notation à un modèle capable de voir les images. C’est une voie qui vaut la peine d’être explorée. Mais « le modèle sait décrire une image » ne doit pas être assimilé à « le modèle sait juger de façon stable une erreur spatiale subtile ». Les travaux de 2023 sur MT-Bench et Chatbot Arena analysent le biais de position, le biais de verbosité et le biais d’autopréférence des juges LLM, et rapportent aussi que des modèles performants s’accordaient assez bien avec les préférences humaines sur certaines évaluations textuelles. La conclusion raisonnable n’est donc pas « aucun modèle juge n’est digne de confiance », mais « leur crédibilité dépend de la tâche et doit être vérifiée ». Ces résultats obtenus sur des évaluations textuelles ne peuvent pas non plus servir directement de taux d’exactitude pour une notation visuelle5.
Les capacités visuelles elles-mêmes doivent être vérifiées. L’étude BlindTest de 2024 a constaté que les modèles vision-langage testés commettaient encore des erreurs sur une géométrie simple, par exemple savoir si deux cercles se chevauchent ou si deux lignes se croisent. Cela ne signifie pas que tous les modèles actuels en sont restés à ce niveau. Mais cela suffit à rappeler qu’on ne doit pas présumer qu’une relation de contact fine est bien jugée au seul motif que le modèle est réputé6. Je commencerais par constituer un ensemble d’échantillons de référence annotés par des humains, plutôt que de confier immédiatement le classement à un juge.
Cet ensemble doit contenir des réussites évidentes et des échecs évidents, mais aussi des cas limites : croquis, traits fins, occultations plausibles, chemins complexes, et productions correctes à l’arrêt mais fausses en mouvement. Prévoyez qu’au moins deux annotateurs notent indépendamment et à l’aveugle, puis réexaminez les désaccords. Les humains ne constituent pas non plus une vérité terrain naturelle. Si deux personnes qui lisent la même règle aboutissent sans cesse à des conclusions opposées, c’est peut-être d’abord l’énoncé ou les consignes de notation qu’il faut revoir. Un échantillon impossible à clarifier peut rester contesté. Il n’a pas besoin d’une « réponse type » inventée de toutes pièces.
Le juge doit répondre à des questions concrètes, pas livrer un avis esthétique
Fournissez-lui l’énoncé d’origine, les règles de notation figées et une image rendue de façon uniforme. Pour un énoncé animé, ajoutez des images horodatées ou une vidéo. Ne lui donnez pas en plus le nom du fournisseur, une position au classement ou la déclaration du modèle générateur selon laquelle « cette image respecte entièrement les exigences ». Interrogez le juge critère par critère : « Chaque pied touche-t-il sa propre pédale ? » « Le cadre visible se raccorde-t-il de façon cohérente aux axes avant et arrière ? » « À ces instants, le lien entre le pied et la pédale tient-il ? »
Joignez à chaque jugement un élément de preuve court et localisable, par exemple : « à 2,0 secondes, le pied le plus proche de l’observateur présente un écart net avec la pédale ». Quand les preuves sont insuffisantes, renvoyez uncertain. Ne compensez pas un manque de visibilité par un paragraphe fluide. Le texte présent dans l’image, les commentaires SVG et les métadonnées ne peuvent être que du contenu évalué. Ils ne peuvent pas devenir des instructions qui modifient les règles de notation. Masquer un nom de fichier ou une étiquette de canal n’autorise pas à modifier la production. Si un recadrage ou une image annotée d’appui est nécessaire, conservez à la fois l’original et une trace du traitement.
L’étalonnage ne peut pas reposer sur un seul « taux de concordance global »
Supposons un ensemble de référence comptant 90 images conformes et 10 images présentant une erreur grave. Un juge qui répond toujours « réussi » obtient malgré tout une exactitude globale de 90 %, tout en laissant passer toutes les erreurs graves. Je vérifierais donc séparément combien d’erreurs critiques ont été manquées, combien de productions correctes ont été rejetées à tort, si les performances sont homogènes d’un style à l’autre, et si des notations répétées d’une même production restent stables. Sur les cas limites, il faut aussi voir si le juge accepte de reconnaître que les preuves sont insuffisantes.
Quelques échantillons qui « ne modifient qu’un seul facteur » sont utiles : garder l’original et éloigner un pied de la pédale, ou ne changer que l’arrière-plan sans toucher à la structure. La première modification doit affecter la note concernée. La seconde ne doit pas modifier sans raison un jugement structurel. Ces échantillons construits sont précieux pour le diagnostic, mais ils ne remplacent pas entièrement de vraies sorties de modèles. Les échantillons utilisés pour réviser le prompt de notation et les échantillons réservés au contrôle final du juge doivent rester séparés. On ne peut pas ajuster sur les mêmes réponses jusqu’à obtenir un résultat satisfaisant, puis présenter ce score comme une preuve de capacité de généralisation.
Un vote entre plusieurs juges peut faire apparaître des désaccords. Mais recourir à trois modèles ne rend pas les trois jugements indépendants : ils peuvent partager la même erreur. Qu’un juge affirme lui-même « j’en suis sûr à 95 % » ne peut pas, sans étalonnage, être pris pour une exactitude réelle de 95 %. Ce qu’un juge doit prouver, c’est qu’il sait reconnaître une erreur, et pas seulement qu’il sait expliquer sa note.
5. L’animation, ce n’est pas quelques captures de plus : c’est vérifier si une relation se rompt dans le temps
Une note statique demande : « le pied est-il sur la pédale maintenant ? » Une note d’animation demande : « une fois le mouvement lancé, cette relation tient-elle toujours ? » Un pied qui touche la pédale par hasard sur la première image ne suit pas pour autant la trajectoire de la pédale ensuite. À l’inverse, figer le pied et la pédale pour que rien ne bouge ne constitue pas le mouvement de pédalage exigé par l’énoncé. L’animation pose donc au moins deux questions distinctes : ce qui doit bouger bouge-t-il réellement, et la liaison qui doit tenir pendant le mouvement tient-elle toujours ?
Il faut d’abord s’accorder sur la scène animée. Pédaler sur place, avancer, suivre le cycliste avec la caméra : ce sont des tâches différentes. Si l’énoncé n’exigeait pas une simulation mécanique précise, il ne faut pas ajouter en douce une contrainte supplémentaire comme le rapport de transmission. S’il exige explicitement que la manivelle tourne et que le pied reste en contact avec la pédale, ces exigences font partie des critères d’acceptation.
L’environnement d’évaluation doit aussi préserver l’état réel de l’animation. Voici un piège d’ingénierie concret. L’option de capture de Playwright animations="disabled" arrête les animations concernées qu’elle prend en charge : les animations finies sont avancées jusqu’à leur fin, les animations infinies sont annulées et ramenées à leur état initial. Ce n’est pas un synonyme de « capturer exactement un instant arbitraire »7. On ne peut donc pas déclarer une animation réussie parce que quelqu’un a désactivé l’animation et capturé une jolie image. Validez d’abord votre méthode de contrôle du temps et de capture sur un fichier de test au mouvement connu, et seulement ensuite appliquez-la aux sorties des modèles. Les mécanismes d’animation pris en charge doivent eux aussi être documentés.
Supposons que l’énoncé exige une boucle de 4 secondes. Un plan de départ consiste à observer deux boucles complètes, à échantillonner à une fréquence fixée d’avance, et à inspecter en plus la jonction entre deux boucles ainsi que tout intervalle suspect. La fenêtre d’observation, la fréquence d’échantillonnage et les règles de vérification supplémentaire doivent toutes être fixées avant l’évaluation formelle, et non durcies après avoir vu de quel côté se situe le problème. Même ainsi, un nombre fini d’images peut manquer une défaillance brève entre deux images. Le rapport doit dire « aucune erreur manifeste n’a été constatée dans la fenêtre et les conditions d’échantillonnage convenues », et non « il est mathématiquement démontré qu’il n’y a eu aucune interpénétration à aucun moment ».
L’occultation normale dans une image plane demande aussi de la prudence. Quand une patte passe derrière le cadre, des contours qui se superposent ne signifient pas automatiquement une interpénétration. Ce qu’il faut vérifier, c’est si l’ordre de profondeur ou la liaison change de façon incohérente. Un agrandissement local aide à l’observation, mais ne doit pas faire perdre le contexte spatial global. Si un juge automatique ne sait pour l’instant traiter de manière fiable que des images fixes, publiez les résultats statiques et laissez l’animation à la revue humaine. Mieux vaut reconnaître que cet instrument ne mesure pas encore jusque-là que d’intégrer une capacité non mesurée dans une note globale.
6. Le système de notation peut se tromper, et donner l’illusion qu’un modèle s’est soudain dégradé
Vérifications statiques, juge visuel et revue humaine ne règlent pas tout. Le système lui-même peut changer. Hier, le juge était indulgent avec un léger écart ; aujourd’hui, une nouvelle version pénalise sévèrement. Les productions générées n’ont pas changé du tout, mais le taux de conformité affiché au classement baisse. Si l’on ne conserve que « nom du modèle, date, note globale », un changement de juge se confond facilement avec une dégradation du modèle. Outre le modèle générateur et les paramètres de requête, consignez la version de l’énoncé, la version de la grille de notation, le modèle et la configuration du juge, la version du moteur de rendu et celle du vérificateur automatique. Un changement sur n’importe lequel de ces éléments peut modifier le sens d’une note.
Avant de remplacer un juge ou une règle, je ferais noter les mêmes productions sauvegardées par l’ancienne et la nouvelle version, pour voir où se concentrent les écarts. Les productions historiques peuvent être renotées si nécessaire, mais il faut l’étiqueter comme « nouvelle notation du même artefact », et non le faire passer pour une nouvelle réponse du modèle.
Autre catégorie de problème : une évaluation qui n’a pas abouti. Un délai dépassé côté service, un SVG corrompu, un programme de capture qui plante ou une requête au juge qui échoue ne doivent pas tous être rangés sous « le modèle a mal dessiné ». Si la production elle-même enfreint les règles, elle peut être déclarée en échec selon la règle prévue. Si c’est l’infrastructure d’évaluation qui a failli, consignez l’évaluation comme non résolue et complétez-la selon une procédure fixe. Pour une production donnée, une condition nécessaire en échec manifeste suffit à déclarer l’ensemble non conforme. Inversement, si rien n’a échoué de manière manifeste mais qu’une condition nécessaire reste indéterminée, on ne peut pas simplement laisser passer la production.
Supposons que 100 requêtes planifiées donnent 72 cas confirmés conformes, 18 confirmés non conformes et 10 encore indéterminés. Le rapport peut d’abord donner ces trois chiffres, plutôt que de supprimer les échantillons non résolus et d’annoncer « un taux de conformité de 80 % ». Si l’on considère provisoirement comme correctes les étiquettes déjà attribuées, la part finale de productions conformes de ce lot se situe entre 72 % et 82 % : la borne basse compte chaque cas non résolu comme un échec, la borne haute comme une réussite. Cette fourchette provient des étiquettes non résolues. Ce n’est pas un intervalle de confiance statistique, et elle n’inclut ni les erreurs du juge ni l’incertitude liée à la généralisation à d’autres échantillons.
La revue humaine ne peut pas non plus se limiter aux échecs et aux litiges signalés par le juge. Il faut aussi vérifier un échantillon aléatoire, défini à l’avance, des productions validées automatiquement. Sinon, les omissions les plus dangereuses peuvent rester cachées dans la zone « réussi ». Aucune évaluation automatique ne peut prouver qu’elle est exempte d’erreurs en arguant qu’elle ne s’est jamais prise en défaut. Elle a besoin d’une procédure d’audit capable de débusquer activement ses propres erreurs.
7. Les énoncés vieillissent, mais en changer tous les jours n’est pas plus scientifique
Dès qu’un énoncé devient viral, les exemples, tutoriels, conseils de correction et optimisations ciblées affluent. Voir un modèle bien dessiner un pélican ne suffit pas, à soi seul, pour affirmer qu’il a triché. L’exposition d’un énoncé public, l’apprentissage d’un type d’exercice et l’entrée d’échantillons de test dans les données d’entraînement sont des problèmes de niveaux différents. Savoir si un modèle donné a vu un matériel de test donné exige des preuves. « Cet énoncé est trop célèbre » n’en est pas une.
L’entrée du matériel de test dans les données d’entraînement reste néanmoins un risque auquel l’évaluation doit faire face. La pratique de LiveBench consiste notamment à utiliser des sources d’information récentes, à renouveler continuellement les questions et à noter automatiquement à partir de réponses vérifiables. C’est une pratique qui réduit le risque correspondant, pas une garantie que « changer les questions chaque mois élimine absolument toute contamination »8. Pour un énoncé de génération ouverte comme le pélican, je préférerais distinguer trois usages : des énoncés de base stables, pour suivre l’évolution à long terme ; des énoncés d’extension renouvelés régulièrement, pour observer le transfert ; des énoncés réservés, non encore publiés, pour un contrôle une fois la procédure figée, plutôt que pour ajuster indéfiniment les règles.
La valeur d’un énoncé de base, c’est la comparabilité, pas l’immunité contre la contamination par l’entraînement. La valeur d’un énoncé d’extension, c’est une couverture plus large, pas une consigne plus bizarre.
Ce qui mérite de varier, ce sont les contraintes, pas seulement le nom du héros
Remplacer le pélican par un canard est un changement. Cela ne modifie pas automatiquement la structure relationnelle. Une variante plus utile au diagnostic modifie délibérément une seule condition. Si l’orientation est inversée, la liaison reste-t-elle correcte ? Si l’occultation augmente, les pièces clés restent-elles complètes ? Si l’énoncé demande de « se tenir à côté du vélo et le pousser », le modèle plaque-t-il encore une posture de cycliste ? Quand la même relation de contact passe dans une animation, se rompt-elle ?
On peut aussi passer à d’autres relations : une main qui tient l’anse d’une tasse, un objet posé sur un plateau, plusieurs pièces assemblées dans un ordre précis. Il ne s’agit pas d’entasser toutes les exigences rares dans une seule image, mais de savoir ce que teste chaque variante. Substituer mécaniquement cent animaux dans un même gabarit produit évidemment cent énoncés. Cela ne permet pas pour autant de parler de cent preuves indépendantes d’une capacité. L’agrégation doit conserver la catégorie de tâche et la famille de gabarits, afin qu’un gabarit ne pèse pas pour l’essentiel de la note globale simplement parce qu’il compte beaucoup de variantes.
Les nouveaux énoncés générés automatiquement doivent aussi être validés. Un énoncé peut être flou, contradictoire ou impossible à vérifier à partir de l’image finale. Si l’énoncé, la réponse et les règles du juge sont tous proposés par le même modèle, puis confirmés par ce même modèle, une vérification indépendante est d’autant plus nécessaire.
Quand la banque d’énoncés change, ne présentez pas un changement de difficulté comme un progrès du modèle
Obtenir 80 points ce mois-ci et 90 le mois prochain ne signifie pas forcément que le modèle s’est amélioré. Les nouveaux énoncés sont peut-être simplement plus faciles. Lors du passage d’une ancienne banque à une nouvelle, mieux vaut conserver des énoncés communs et faire passer les deux banques à un ensemble de systèmes de référence dans des conditions proches. Rapportez séparément l’évolution de chaque catégorie de tâche. Les énoncés communs et les systèmes de référence ne sont pas une vérité terrain valable pour toujours. Ils aident à repérer un changement, mais n’assurent pas automatiquement une mise en équivalence rigoureuse de la difficulté. Quand les preuves sont insuffisantes, la pratique honnête consiste à présenter les résultats par version, plutôt qu’à raccorder en une seule courbe les scores bruts d’épreuves différentes.
Un énoncé retiré peut être publié, pour que d’autres puissent revérifier, apprendre et améliorer. Une fois public, son rôle peut passer de « contrôle encore inédit » à « test de non-régression reproductible ». Un énoncé ne sert pas qu’une seule fois, mais il ne peut pas non plus rester éternellement le même instrument de mesure. L’enjeu d’une banque d’énoncés évolutive n’est pas de courir sans fin après la nouveauté, mais de gérer ce qu’un énoncé permet de conclure à chaque étape.
8. Ce qui mérite vraiment d’être automatisé, c’est une procédure qu’on peut auditer après coup
À ce stade, il est tentant de grossir le plan sans cesse : plusieurs juges, analyse de trajectoire, banque d’énoncés évolutive, arbitrage automatique, et rien de facultatif. Une version minimale utilisable n’a pas besoin de commencer comme une usine entièrement automatisée. Choisissez un petit ensemble d’énoncés, rédigez les critères d’acceptation, collectez de vraies sorties, constituez une référence humaine, puis vérifiez quels critères peuvent être confiés à des règles et lesquels à un juge visuel. Gardez un traitement humain pour ce qui n’est pas encore automatisé de façon fiable.
Tant que les données sont peu nombreuses, l’objectif est de trouver les failles des règles, pas d’annoncer que « l’exactitude de la notation a atteint tel niveau ». Une validation formelle de la capacité automatisée exige un ensemble d’échantillons réservé à part et un rapport sur l’incertitude. Une procédure raisonnable peut être :
Figer l’énoncé et les règles d’acceptation → générer selon le plan prévu → conserver la sortie brute complète
→ analyser et rendre dans un cadre contrôlé → vérifications statiques / notation visuelle critère par critère
→ examiner les litiges selon les règles, et contrôler par sondage les cas validés automatiquement
→ synthétiser les résultats de la première livraison, les performances par critère et les cas non résolus
Chaque étape doit pouvoir être rattachée à la précédente. La réponse brute, le SVG extrait, le rendu effectif, le relevé d’observation de l’animation, le retour brut du juge et la conclusion de la revue sont reliés par un même identifiant d’exécution. Lorsqu’un fichier est extrait ou normalisé, conservez la version d’avant et celle d’après. Si un fragment de SVG a dû être réparé pour pouvoir être rendu, consignez-le comme le résultat d’une procédure de réparation. N’écrasez pas discrètement la première réponse. Lorsque les règles de notation évoluent, ajoutez un nouvel enregistrement d’évaluation au lieu d’effacer l’ancien.
Un prérequis d’ingénierie ne peut pas être omis : traiter la sortie du modèle comme un contenu non fiable. Les modes de traitement SVG peuvent faire intervenir des scripts, des événements et des ressources externes. « L’extension dit que c’est une image » ne signifie pas qu’on peut l’exécuter sans risque dans un navigateur où l’on est connecté au quotidien3.
L’environnement de rendu doit isoler les identifiants des comptes, le réseau et les fichiers de l’hôte, limiter l’usage des ressources et utiliser une configuration de bac à sable adaptée aux contenus non fiables. Utiliser Playwright ne règle pas le problème au motif que le navigateur a été « mis dans Docker ». Sa documentation alerte explicitement sur les limites de l’image de conteneur par défaut, ainsi que sur le lien entre l’exécution en root et le bac à sable de Chromium9. Les mesures de sécurité concrètes doivent encore être vérifiées dans l’environnement où elles s’exécutent. Ce que l’énoncé autorise et ce que l’environnement d’exécution autorise doivent être alignés à l’avance. Ne laissez pas le modèle utiliser un script pour ensuite, au moment de la notation, désactiver tous les scripts sans le dire.
Ce qu’il faut réellement économiser, ce n’est pas la « vérification minutieuse » en elle-même. C’est le travail répétitif qui consiste, à chaque vérification, à retrouver le fichier, comparer les paramètres et compléter l’horodatage.
9. Un classement digne d’être lu doit permettre qu’on continue à l’interroger
Quand je vois une note, je veux pouvoir retrouver à quel service de modèle elle correspond, à quelle banque d’énoncés et à quelle fenêtre temporelle ; combien d’échantillons il y avait, et si les échecs et les cas non résolus ont été conservés ; qui a noté, comment l’étalonnage a été fait, et si l’on peut retrouver le fondement d’un jugement. Ces informations en disent plus sur le sérieux avec lequel une évaluation traite ses propres limites qu’une note globale à l’apparence très précise.
Si vous ne comptez pas construire la procédure vous-même, vous pouvez commencer par le classement public, les rapports et les explications sur la méthode d’évaluation de Folkbench, et vérifier si le modèle et le service qui vous intéressent disposent déjà d’un résultat publié applicable. Sa page d’accueil publique présente la comparaison comme portant sur différents services pour un même modèle. La couverture, l’état des fonctionnalités et le fondement d’une conclusion doivent toutefois s’apprécier d’après les informations publiques au moment de la consultation10.
Cela vaut pour Folkbench comme pour les autres classements. Les informations manquantes restent inconnues. La présentation d’une plateforme ne remplace pas le rapport effectif. La proposition d’évaluation de cet article n’équivaut pas à une capacité dont disposerait déjà une plateforme. Une bonne évaluation ne demande pas au lecteur de « croire mon score ». Elle lui permet de remonter du score à la production, aux conditions, aux règles et aux désaccords. Revenons aux trois pélicans.
Inutile de débattre pour savoir si le premier est le plus beau, et inutile de valider toute l’animation du troisième parce qu’une image est réussie. Une fois la mesure convenue et les preuves clairement consignées, une bonne part de ce qu’on qualifie de mystère devient une question qu’on peut discuter point par point. Le premier article disait qu’une capture d’écran peut soulever une bonne question, mais qu’y répondre exige une expérience digne de ce nom. Celui-ci voudrait ajouter : une expérience digne de ce nom exige aussi un instrument de mesure qui a lui-même été vérifié.
Annexe A. Un énoncé contraint et une grille d’acceptation pour démarrer
L’énoncé statique ci-dessous est un exemple conçu pour cet article. Ce n’est ni une norme du secteur, ni l’énoncé officiel d’une quelconque plateforme. Il doit être testé à blanc et étalonné par annotation avant usage. Une fois la comparaison formelle lancée, ne modifiez pas l’énoncé en fonction des résultats.
Exemple de prompt
Produisez uniquement le contenu d’un seul fichier SVG statique et autonome, pouvant être ouvert seul.
Utilisez viewBox "0 0 800 600". N’ajoutez ni bloc de code Markdown ni explication.

Dessinez un pélican façon dessin animé qui roule sur un vélo ordinaire à deux roues.
Adoptez une vue principalement de profil. Un léger décalage des pièces est autorisé pour que la relation de conduite reste lisible.

Le dessin doit satisfaire toutes les conditions suivantes :
1. Le pélican et le vélo sont entièrement dans l’image, sans pattes supplémentaires.
2. Les roues avant et arrière, le cadre, la selle, le guidon, la manivelle et les deux pédales sont reconnaissables.
   Le cadre se raccorde de façon cohérente aux deux axes de roue, et la liaison entre pédales et manivelle est cohérente.
3. Le corps est assis sur la selle. Chaque pied touche sa propre pédale,
   et les deux contacts doivent être clairement visibles. Au moins une aile touche le guidon.
4. Utilisez uniquement des graphismes vectoriels SVG et des styles en ligne. N’utilisez ni images bitmap intégrées, ni ressources externes,
   ni scripts, ni foreignObject, ni animation.

Le réalisme, un arrière-plan complexe, la texture du plumage et les effets décoratifs ne sont pas requis.
Exemple de grille d’acceptation
| ID | Vérification | Nature |
|---|---|---|
| F1 | Respecte le format de fichier autonome, la zone d’affichage et les limites de ressources convenus | Condition nécessaire |
| P1 | Le sujet est reconnaissable comme un pélican, l’image est complète et il n’y a pas de patte supplémentaire manifeste | Condition nécessaire |
| B1 | Les deux roues, le cadre, la selle, le guidon, la manivelle et les deux pédales sont reconnaissables | Condition nécessaire |
| B2 | Le cadre se raccorde de façon cohérente aux deux axes, et la liaison entre pédales et manivelle est cohérente | Condition nécessaire |
| R1 | Le corps et la selle forment un appui assis manifeste | Condition nécessaire |
| R2 | Chaque pied touche sa propre pédale, et les contacts respectent l’exigence de visibilité | Condition nécessaire |
| R3 | Au moins une aile touche le guidon | Condition nécessaire |
| A | Énoncé statique : la capacité d’animation n’a pas été testée | Sans objet |
| Q1 | Couleurs, traits et détails | Critère d’affichage facultatif, qui ne compense pas l’échec d’une condition nécessaire |
« Reconnaissable », « cohérent » et « manifeste » nécessitent encore des exemples positifs et négatifs appariés, ainsi qu’une note sur les cas limites. Le tableau n’est qu’un squelette de règles : quelques phrases ne suffisent pas à faire disparaître la part de jugement. Le résultat n’est conforme que si toutes les conditions nécessaires sont remplies. L’échec manifeste d’une condition nécessaire le rend non conforme. Si rien n’a échoué de manière manifeste mais qu’une condition nécessaire reste non résolue, le cas part en revue. R3 est vérifié parce que cet exemple de prompt l’exige explicitement. Il ne faut pas l’appliquer, sans le dire, à tous les énoncés du pélican.
Annexe B. Exemple d’enregistrement de sortie d’un juge
Le JSON ci-dessous est un enregistrement fictif portant sur un seul critère. Il montre comment les champs s’articulent et ne correspond à aucune image réelle. Ce n’est ni un rapport complet, ni une configuration qu’une bibliothèque pourrait exécuter directement.
{
  "run_id": "example-run-001",
  "task_version": "pelican-static-example-v1",
  "rubric_version": "pelican-static-example-v1",
  "judge_profile_id": "example-judge-profile-v1",
  "render_profile_id": "example-render-profile-v1",
  "criterion_id": "R2",
  "status": "fail",
  "evidence": {
    "artifact_ref": "example-render.png",
    "time_s": null,
    "description": "Le pied le plus proche de l’observateur présente un écart clairement visible avec la pédale correspondante."
  },
  "review_required": false,
  "review_reason": null
}
judge_profile_id doit permettre de retrouver le modèle précis du juge, le prompt, les paramètres et l’historique des versions. render_profile_id doit permettre de retrouver le navigateur, la zone d’affichage et les autres réglages pertinents. Une preuve d’animation doit indiquer l’instant réel, et pas seulement « il y a une image quelque part au milieu ». review_required est fixé par le système d’évaluation selon une règle établie ; le juge n’en décide pas seul. Même lorsque ce champ vaut false, l’échantillon peut encore faire l’objet d’un audit aléatoire. L’échec de la notation automatique, l’insuffisance du matériel visuel et la non-conformité de la tâche doivent être consignés séparément. Ils ne doivent pas partager un même statut « échec » aux contours flous.
Notes et sources
- Yushi Hu et al., TIFA: Accurate and Interpretable Text-to-Image Faithfulness Evaluation with Question Answering, ICCV 2023. L’article transforme des exigences textuelles en vérifications par questions-réponses afin d’évaluer la cohérence entre texte et image. Le présent article en reprend l’idée de décomposition, sans transposer les résultats expérimentaux de l’article original aux tâches SVG ou d’animation du pélican. Article↩
- W3C, Scalable Vector Graphics (SVG) 2, chapitres consacrés à la structure du document et aux chemins. Voir le regroupement, la réutilisation via
useet l’expression des chemins. L’idée qu’un nœud DOM ne correspond pas naturellement à un objet sémantique du monde réel est un jugement de conception d’évaluation formulé ici sur cette base. Structure du document ; Chemins↩ - W3C, SVG 2 — Conformance Criteria, sections sur les modes de traitement et la conformité des documents. La spécification distingue des capacités telles que l’exécution de scripts, les ressources externes et l’animation déclarative, ainsi que différentes formes de document. La prise en charge par les navigateurs et les limites d’exécution doivent encore être vérifiées dans l’environnement réel. Spécification↩
- W3C, SVG 2 — Coordinate Systems, Transformations and Units, passages sur les transformations de coordonnées et les boîtes englobantes. Les suggestions formulées ici sur la distance de contact, les seuils et la reconnaissance sémantique sont des exemples de conception d’évaluation. Elles ne constituent pas un algorithme de « pédalage correct » défini par la spécification SVG. Spécification↩
- Lianmin Zheng et al., Judging LLM-as-a-Judge with MT-Bench and Chatbot Arena, NeurIPS 2023 Datasets and Benchmarks Track, arXiv v4. Cet article ne s’en sert que pour ce qu’il dit des capacités et des biais des juges dans certaines évaluations textuelles. Il n’en déduit pas que tous les juges visuels présentent la même ampleur de biais ou la même exactitude. Article↩
- Pooyan Rahmanzadehgervi et al., Vision language models are blind, 2024. Cet article renvoie à l’étude originale de 2024 et cite précisément la version arXiv v1, afin de ne pas mêler les modèles, le titre et les résultats des révisions ultérieures. Cette étude ne peut pas servir de classement actuel des modèles de 2026. Version de l’article↩
- Documentation de Playwright sur l’option
animationsdepage.screenshot, consultée le 5 octobre 2026. La documentation décrit le traitement que cette option applique aux CSS animations, aux CSS transitions et aux Web Animations. Il ne faut pas, sans vérification, l’étendre à un contrôle temporel unique valable pour tous les mécanismes d’animation SVG. Documentation↩ - Colin White et al., LiveBench: A Challenging, Contamination-Limited LLM Benchmark, ICLR 2025, arXiv v2. Une version antérieure du titre employait « Contamination-Free ». Cet article suit la formulation de la révision de 2025 sur la mise à jour continue, la notation vérifiable et la réduction du risque de contamination. Il ne promet pas une absence totale de contamination. Article↩
- Documentation Docker de Playwright, consultée le 5 octobre 2026. La documentation indique que l’image par défaut n’est pas recommandée pour visiter des sites web non fiables, et explique que l’exécution en root par défaut désactive le bac à sable de Chromium. Cet article ne fournit pas de déploiement sécurisé complet. L’isolation, la politique réseau et les permissions doivent encore être mises en œuvre et testées pour l’environnement d’exécution. Documentation↩
- Page d’accueil publique de Folkbench, consultée le 5 octobre 2026. La page d’accueil donne accès au classement, aux rapports et aux explications associées, et présente la comparaison comme portant sur différents services pour un même modèle. Son point d’entrée de détection est en outre signalé comme « parcours de préparation bêta », avec la mention « les tests réels ne sont pas encore activés ; le point d’entrée actuel sert à présenter le parcours de préparation ». Cet article renvoie seulement aux informations publiques. Il ne traite pas un point d’entrée de démonstration comme une mesure achevée, n’apporte pas de caution indépendante à un classement particulier et n’affirme pas que Folkbench a mis en œuvre la notation en quatre dimensions, l’étalonnage du juge ou la banque d’énoncés évolutive proposés ici. Accueil↩


